Các tác tử AI đang thay đổi cách phần mềm được xây dựng. Các nhà phát triển đã chuyển từ việc viết từng dòng code thủ công sang việc điều phối các tác tử viết phần lớn code. Kết quả là, quy trình làm việc hiện tại bị chia tách giữa một chiếc laptop, một API mô hình đám mây và một máy ảo đám mây.
NVIDIA RTX Spark được thiết kế cho việc phát triển AI. Nhờ hệ thống trên chip NVIDIA GB10 và bộ nhớ thống nhất lớn, các nhà phát triển có thể chạy các tác tử lập trình cục bộ, truy cập các khung AI, và lập trình, kiểm thử, triển khai trên một PC duy nhất.
Một máy để lập trình, kiểm thử và triển khai
Laptop và máy để bàn compact RTX Spark cho phép các nhà phát triển hoàn thành toàn bộ quy trình làm việc trên một máy duy nhất.
Các nhà phát triển có thể chọn làm việc trên Windows, bao gồm cấu hình Windows Developer Config mới được phát triển cùng Microsoft, cài đặt các framework phát triển hàng đầu, tắt thông báo, tăng cường terminal và cho phép di chuyển thanh tác vụ sang một bên. Hoặc họ có thể làm việc trong Windows Subsystem for Linux, nơi họ có quyền truy cập vào cùng môi trường và các phụ thuộc mà họ sẽ sử dụng khi triển khai lên đám mây.
Điều này cho phép các nhà phát triển hoàn thành toàn bộ công việc trên hệ điều hành đích của họ mà không cần di chuyển mã. Và vì RTX Spark có GPU NVIDIA, các nhà phát triển có thể kiểm thử và triển khai đến cơ sở cài đặt AI cục bộ lớn nhất: 150 triệu PC RTX, cũng như hầu hết các đám mây trên thế giới chạy trên GPU NVIDIA.
Với bộ nhớ thống nhất lên đến 128GB và khả năng tính toán AI FP4 đạt 1 petaflop, các nhà phát triển có thể chạy các mô hình mã hóa cục bộ, bao gồm Qwen 3.8 Flash Next, giúp giảm mức tiêu thụ token của các tác nhân mã hóa đám mây.
Hiệu năng bạn cần cho phát triển AI
Quá trình phát triển đã chuyển từ việc phụ thuộc vào CPU, nơi hiệu năng chủ yếu được xác định bởi CPU, sang việc phụ thuộc vào GPU. Các nhà phát triển AI hiện nay cần chạy suy luận để vận hành các tác nhân lập trình và kiểm thử ứng dụng của họ; để tinh chỉnh và huấn luyện mô hình; và vâng, vẫn còn một chút biên dịch.
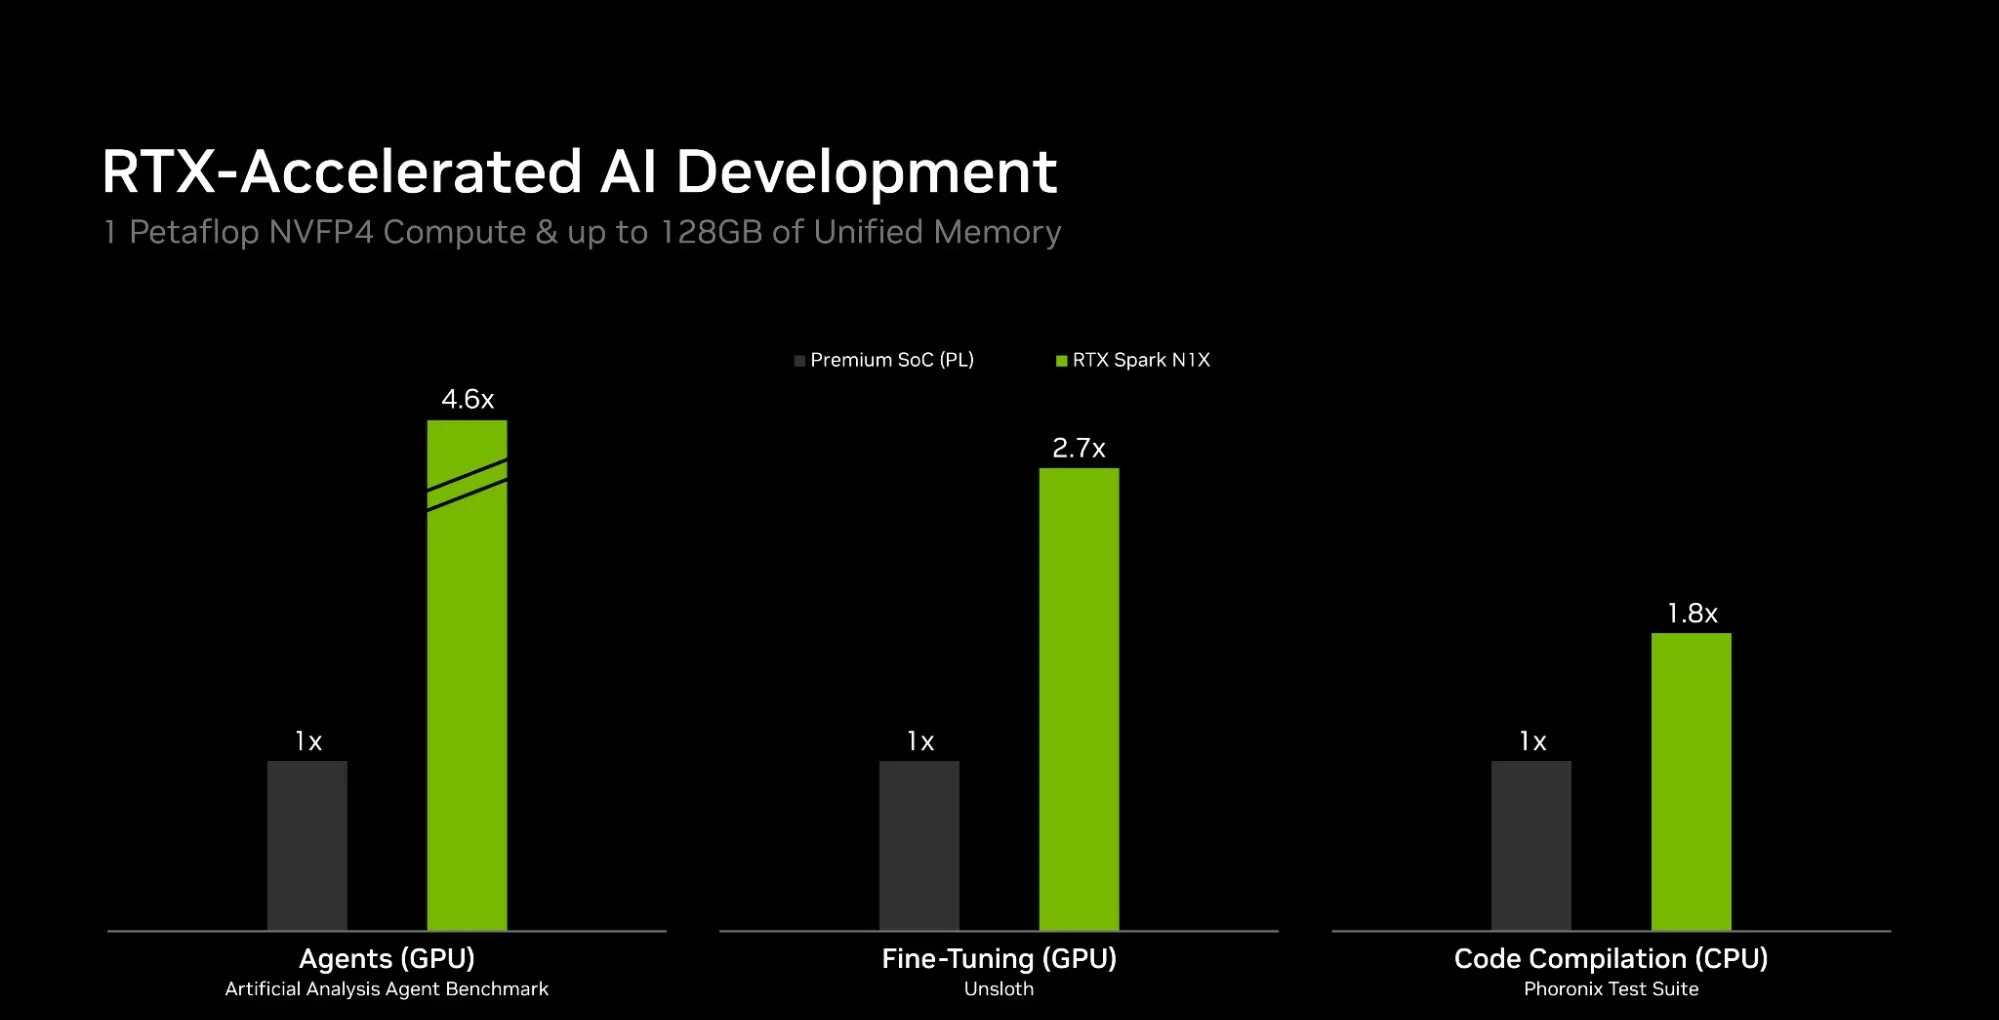
Nhờ có CPU NVIDIA Grace và GPU Blackwell trong RTX Spark, các laptop và desktop này được trang bị đầy đủ sức mạnh tính toán cần thiết cho suy luận, tinh chỉnh và biên dịch. So với Intel Panther Lake 12Xe, RTX Spark mang lại hiệu suất gấp 4,6 lần trên các tác nhân lập trình (coding agents), gấp 2,7 lần trên tinh chỉnh (fine-tuning) và gấp 1,8 lần trên biên dịch mã (code compilation).
Một phần mềm quen thuộc, được mở rộng cho Windows
NVIDIA đã hợp tác với Microsoft để thúc đẩy hệ sinh thái phát triển Windows on Arm. Cùng với RTX Spark, cộng đồng đang phát hành nhiều công cụ mới, bao gồm bản build PyTorch-CUDA đầu tiên, bản phát hành Python đầu tiên mặc định là native với Python 3.15, hơn 2.000 gói Conda sẵn sàng sử dụng và các phiên bản tương thích Arm cho hơn 97% trong số 15.000 gói Python hàng đầu.
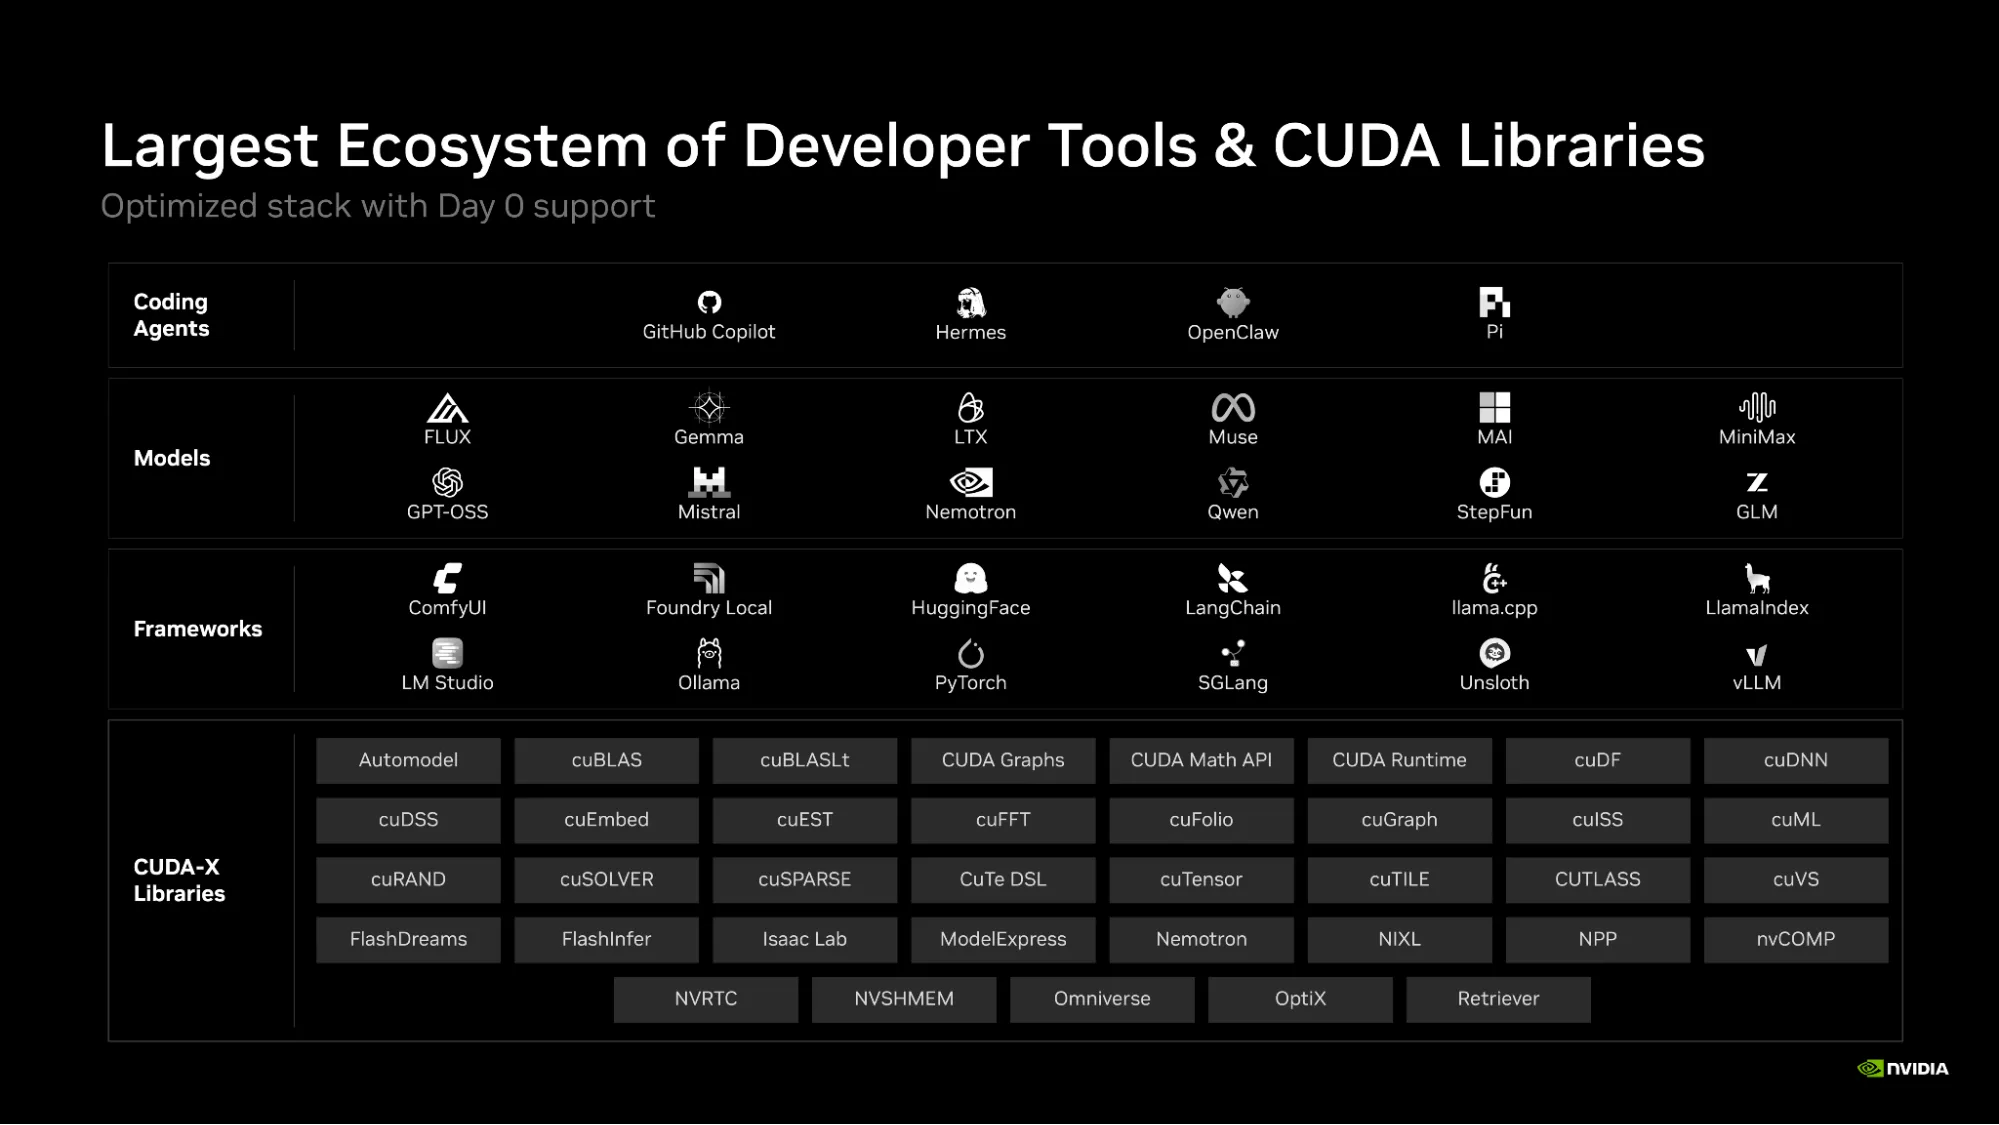
Một lợi thế quan trọng khi phát triển trên phần cứng NVIDIA là khả năng tiếp cận hệ sinh thái công cụ phát triển lớn nhất, từ các tác nhân lập trình, đến các mô hình AI, đến các framework.
Vì GPU NVIDIA là nền tảng được sử dụng rộng rãi nhất cho việc phát triển AI, các công cụ và framework mới thường hoạt động trên NVIDIA ngay từ ngày đầu tiên, trong khi hỗ trợ cho phần cứng khác sẽ đến sau đó vài tuần. Ngoài ra, còn có khả năng tiếp cận các thư viện NVIDIA CUDA-X, bao gồm các công cụ như FlashInfer để tăng tốc LLM và các công cụ thư viện NVIDIA NeMo để phát triển mô hình AI.
NVIDIA cũng cung cấp một kho lưu trữ NVIDIA Skills hướng dẫn các tác tử (agents) cách sử dụng các thư viện CUDA-X, cho phép các nhà phát triển xây dựng các ứng dụng được tăng tốc bằng GPU mà không cần phải am hiểu sâu về CUDA.
Các tác nhân lập trình cục bộ đến với RTX Spark
Các thiết bị RTX Spark rất lý tưởng cho các tác nhân lập trình cục bộ. NVIDIA đã hợp tác chặt chẽ với các tác nhân hàng đầu, bao gồm GitHub Copilot, Pi, Hermes và OpenClaw, để cải thiện chúng và giúp việc sử dụng trở nên dễ dàng hơn.
Các cải tiến bao gồm:
- Triển khai liền mạch các mô hình cục bộ với các công thức được tối ưu hóa
- Bảo mật được tăng cường với NVIDIA OpenShell và/hoặc Microsoft Execution Containers, cung cấp sandbox ở cấp hệ điều hành
- Bộ định tuyến prompt hybrid giữa các mô hình cục bộ và mô hình đám mây, để các prompt được gửi đến các mô hình cục bộ nếu chúng đủ tốt, hoặc được nâng cấp lên đám mây nếu cần, giảm mức tiêu thụ token
Microsoft GitHub CoPilot hiện cho phép AI cục bộ liền mạch thông qua Windows ML, hiện được hỗ trợ với llama.cpp làm backend. Bộ định tuyến prompt HydraFusion đã được nâng cấp để cũng hỗ trợ các mô hình cục bộ. Và mô hình MAI 1.1 Coding Flash mới có thể chạy cục bộ trên RTX Spark.
Pi, một tác nhân mã hóa mã nguồn mở với giao diện terminal nhẹ và hỗ trợ các mô hình cục bộ và đám mây, cũng được tối ưu hóa cho RTX Spark. Các phần mở rộng, kỹ năng và mẫu prompt của nó cho phép các nhà phát triển kiểm soát cách tác nhân phù hợp với quy trình làm việc của họ, từ việc lựa chọn mô hình đến các công cụ mà nó có thể sử dụng.
JetBrains đã ra mắt hỗ trợ native cho Junie Local trên RTX Spark. Tác nhân lập trình đọc mã, chỉnh sửa tệp và chạy kiểm thử, với mô hình và mã được giữ trên máy. Junie Local điều chỉnh kích thước cửa sổ ngữ cảnh theo bộ nhớ khả dụng cho GPU, do đó bộ nhớ thống nhất của RTX Spark cho phép nó giữ nhiều mã, đầu ra công cụ và lịch sử hội thoại hơn trong ngữ cảnh.
Các mô hình Nemotron mới mang đến nhiều lựa chọn hơn cho các tác nhân cục bộ
Nemotron 3.5 Bolt 74B-A9B 24GB là một LLM mới được phát triển chuyên biệt để chạy các tác tử cục bộ trên RTX Spark.
Mô hình này là một mô hình mixture-of-experts (MoE) với 74B tham số, 9B tham số hoạt động, được đóng gói vào 24GB bằng cách sử dụng lượng tử hóa 2-bit cùng các kỹ thuật huấn luyện nhận thức lượng tử hóa tiên tiến để duy trì chất lượng. Nó hướng tới việc đạt được sự cân bằng tối ưu giữa tốc độ và trí tuệ, nhanh hơn hầu hết các mô hình dense phổ biến trong khi thông minh hơn hầu hết các mô hình MoE phổ biến có dung lượng bộ nhớ tương đương.
Người dùng sẽ có thể chạy Nemotron 3.5 Bolt 74B ngay khi ra mắt thông qua llama.cpp, vLLM, Ollama, Unsloth và LM Studio. Nó cũng sẽ có thể được truy cập trực tiếp thông qua các tác nhân (agents) như Hermes và OpenClaw.
Giống như các mô hình Nemotron khác, Bolt 74B hoàn toàn mã nguồn mở, bao gồm dữ liệu huấn luyện, trọng số và công thức, do đó các nhà phát triển có thể tinh chỉnh và tùy chỉnh các tác nhân (agents) của riêng họ.
Các mô hình quyết định hiện được hỗ trợ trong các framework hàng đầu
Các mô hình quyết định là bước đột phá mới nhất trong phát triển AI. Chúng cung cấp cho các AI agent cách đưa ra quyết định gần như tức thì, không cần các vòng lặp suy luận dài. Chúng có thể chọn hành động tiếp theo, từ phân loại yêu cầu đến lựa chọn hành động kế tiếp, nhanh hơn tới 200 lần so với các agent truyền thống. Các mô hình quyết định hiện được hỗ trợ trong llama.cpp và Unsloth trên RTX Spark và GPU GeForce RTX.
SDK AI cho truyền thông
NVIDIA AI for Media SDKs hiện đã có sẵn cho RTX Spark, bao gồm Python wheel với hỗ trợ siêu phân giải video, tạo khung hình và TrueHDR. Wheel có sẵn trên PyPI, các SDK C++ cũng có sẵn trên NGC cho RTX Spark và Windows on Arm.
Mang ứng dụng Windows của bạn đến RTX Spark
Để mang một ứng dụng hiện có đến RTX Spark, trước tiên hãy đánh giá các phụ thuộc cho Windows trên Arm. Chọn bản dựng Arm64 native hoặc sử dụng Arm64EC để di chuyển các thành phần theo từng giai đoạn. Kiểm tra cài đặt, chức năng, hiệu suất và các đường dẫn NVIDIA và CUDA mà ứng dụng của bạn sử dụng.
Các tài nguyên chuyển ứng dụng của NVIDIA giải thích các tùy chọn và công cụ di chuyển, bao gồm cách bắt đầu chuẩn bị trên một hệ thống phát triển Windows on Arm hiện có.
Tìm kiếm RTX Spark của bạn và bắt đầu xây dựng
RTX Spark hiện đã có sẵn trên các laptop và sẽ ra mắt vào tháng 11 trên các máy tính để bàn dạng nhỏ gọn, lý tưởng cho các tác nhân chạy liên tục 24/7.
Khám phá các hệ thống RTX Spark để tìm ra lựa chọn yêu thích và xem các tùy chọn mua hàng khả dụng.
Khi bạn đã có được máy của mình, hãy bắt đầu với playbook Phát triển AI để cấu hình Windows, thiết lập agent của bạn và kết nối NVIDIA Skills. Và tìm hiểu cách bạn có thể bắt đầu phát triển ứng dụng Local AI cho GPU NVIDIA.
Bài viết liên quan
- Những cỗ máy tạo ra những cỗ máy
- NVIDIA Nemotron 3.5 Super VL hỗ trợ các tác nhân chuyên biệt với khả năng suy luận đa phương thức
- Mở rộng quy trình lập trình Agentic với Muse Spark Open của Meta trên NVIDIA GB300 NVL72
- Đánh giá hiệu năng suy luận LLM quy mô lớn với AIPerf
- Một nền tảng, hai cấu hình: Giải mã sự khác biệt giữa NVIDIA DGX Spark 64GB và 128GB