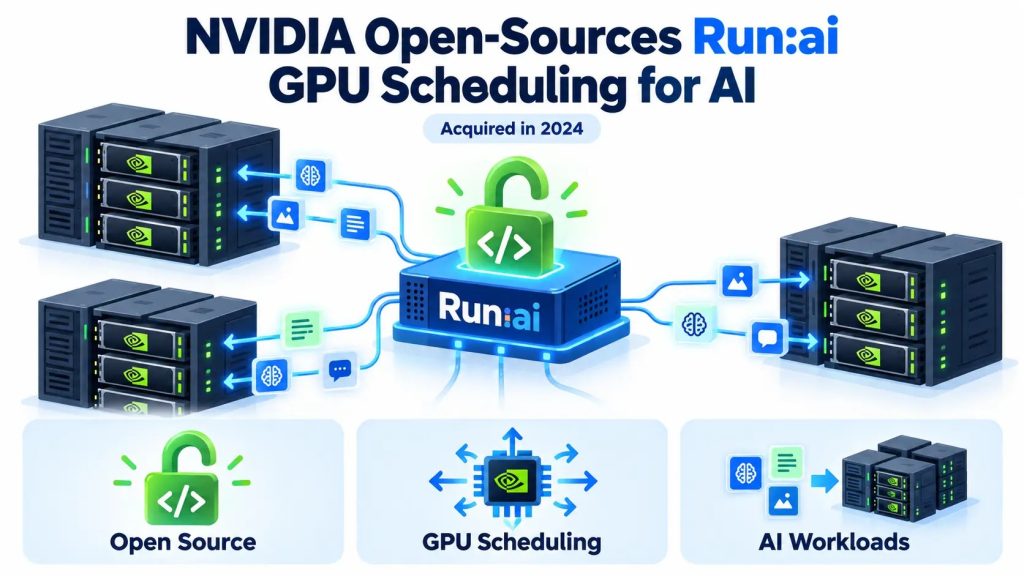
Ngày 13/10/2026, NVIDIA công bố mở mã nguồn toàn bộ nền tảng Run:ai, là một phần trong giải pháp NVIDIA DSX AI Factory Platform. Doanh nghiệp và nhà phát triển có thể triển khai nền tảng hoặc tích hợp từng thành phần vào hệ thống hiện có.
Đưa GPU vào một nguồn tài nguyên dùng chung
Khi nhiều nhóm cùng phát triển AI, việc vận hành cần đáp ứng cả huấn luyện, thử nghiệm và suy luận. Cấp GPU cố định cho từng nhóm có thể khiến tài nguyên bị giữ lại dù chưa được sử dụng hết.
NVIDIA Run:ai bổ sung lớp điều phối trên Kubernetes, kết hợp lập lịch, phân bổ GPU, quản lý hạn mức và giám sát. Nhờ đó, đội vận hành có thể quản lý tài nguyên theo nhu cầu công việc và chính sách của tổ chức, thay vì chỉ theo từng máy chủ.
Ad
Nền tảng có lớp quản lý tập trung và các dịch vụ chạy trong cụm Kubernetes, hỗ trợ quản lý công việc và quan sát tài nguyên trên nhiều cụm. Run:ai hoạt động cùng Kubernetes và các công cụ hạ tầng GPU hiện có.
Bốn thành phần có thể tích hợp độc lập
Bên cạnh mã tích hợp của nền tảng, NVIDIA cung cấp bốn thành phần có thể sử dụng riêng. Cách tiếp cận này cho phép đội kỹ thuật bổ sung khả năng còn thiếu mà không cần triển khai toàn bộ Run:ai.
KAI Scheduler: phân bổ GPU theo yêu cầu công việc
KAI Scheduler quyết định công việc được chạy ở đâu và khi nào. Với một tác vụ huấn luyện cần nhiều pod, cơ chế gang scheduling giúp chỉ bố trí thực thi khi có đủ tài nguyên cho cả nhóm, tránh để một phần công việc chạy rồi chờ phần còn lại.
Bộ lập lịch hỗ trợ chia sẻ công bằng giữa các nhóm, hạn mức tài nguyên và lựa chọn vị trí dựa trên cấu trúc kết nối phần cứng. Khả năng sắp xếp công việc vào tài nguyên phù hợp cũng giúp hạn chế tình trạng cụm còn dung lượng nhưng khó bố trí thêm tác vụ.
KAI Scheduler được phát hành theo Apache 2.0 và là dự án CNCF Sandbox. Thành phần này có thể triển khai trên cụm hiện có.
GPU Fractioning Operator: chia sẻ GPU cho các tác vụ nhỏ
Notebook, môi trường phát triển và mô hình nhỏ thường không cần toàn bộ bộ nhớ của một GPU. GPU Fractioning Operator đưa cơ chế chia phần GPU của CUDA 13.4 vào Kubernetes để phục vụ nhóm nhu cầu này.
Theo thiết kế được công bố, trình điều khiển CUDA áp đặt giới hạn bộ nhớ cho từng tác vụ; mỗi tác vụ chỉ nhìn thấy phần bộ nhớ được cấp. Operator bổ sung lớp tích hợp Kubernetes và số liệu giám sát theo pod.
Thành phần này phối hợp được với KAI Scheduler và không bị ràng buộc riêng vào bộ lập lịch đó. Khi triển khai, cần đối chiếu yêu cầu tương thích của CUDA, trình điều khiển và phần mềm trong cụm.
KAI Resource Management: quản lý tài nguyên theo tổ chức
KAI Resource Management bổ sung dự án, phòng ban, hạn mức phân cấp và các nhóm máy chủ. Đây là lớp giúp chuyển chính sách sử dụng GPU của doanh nghiệp thành cấu hình vận hành.
Ví dụ, tổ chức có thể đặt phần tài nguyên được bảo đảm cho nhóm nghiên cứu, đồng thời áp dụng chính sách chia sẻ năng lực còn trống. Các nhóm máy chủ giúp hướng công việc đến phần cứng phù hợp trong cụm có nhiều loại tài nguyên.
Workload Map: thống nhất cách mô tả công việc AI
Một hệ thống AI có thể dùng PyTorchJob để huấn luyện, RayCluster để xử lý phân tán hoặc KServe để phục vụ mô hình. Mỗi loại có cấu trúc và cách báo trạng thái riêng.
Workload Map cung cấp cách mô tả thống nhất để công cụ quản lý hiểu thành phần, vai trò và trạng thái của các công việc đó. Thư viện Go này giúp giảm nhu cầu viết tích hợp riêng cho từng loại tài nguyên Kubernetes; bản thân nó không lập lịch hay tự động mở rộng hệ thống.
Bổ sung khả năng nạp mô hình và điều phối suy luận
Model Streamer: giảm thời gian nạp trọng số
GPU có thể đã được cấp nhưng vẫn phải chờ trọng số được nạp từ hệ thống lưu trữ. Model Streamer hỗ trợ đọc song song và truyền dữ liệu trọng số vào bộ nhớ GPU, nhằm rút ngắn giai đoạn khởi động này.
Dự án hỗ trợ nhiều nguồn lưu trữ và có tích hợp với các công cụ suy luận như vLLM, SGLang. Hiệu quả thực tế cần được đo trên mô hình, đường truyền và hệ thống lưu trữ của từng triển khai.
Grove: phối hợp các thành phần của hệ thống AI
Trong kiến trúc suy luận tách bước xử lý đầu vào và sinh token, các thành phần cần được khởi chạy và mở rộng có phối hợp. Grove cung cấp API Kubernetes cho những công việc gồm nhiều thành phần như vậy.
Dự án hỗ trợ điều phối theo cấu trúc kết nối phần cứng, mở rộng tài nguyên và gang scheduling phân cấp. Grove thuộc hệ sinh thái NVIDIA Dynamo và cũng có thể được sử dụng độc lập.
Mở rộng khả năng tích hợp trong hệ sinh thái DSX
NVIDIA công bố tám đối tác đang tích hợp nền tảng mở: Crusoe, Mirantis, Nebius, OpenNebula Systems, Rafay, Saturn Cloud, Spectro Cloud và vCluster.
Với nền tảng mở và các thành phần độc lập, nhà cung cấp dịch vụ có thêm lựa chọn để xây dựng lớp quản lý GPU theo nhu cầu khách hàng.
Lựa chọn cách triển khai phù hợp
Đội vận hành có thể bắt đầu từ KAI Scheduler nếu cần cải thiện lập lịch, hoặc đánh giá GPU Fractioning Operator nếu nhiều tác vụ nhỏ đang dùng riêng từng GPU. Nhu cầu quản lý đồng bộ công việc, chính sách và nhiều cụm có thể phù hợp với toàn bộ Run:ai.
Kho mã Run:ai công bố giấy phép Apache 2.0, kèm các thông báo và giấy phép thành phần liên quan. Bản Community Product trên NGC có điều khoản phân phối riêng và không bao gồm hỗ trợ doanh nghiệp của NVIDIA.
Tài liệu tham khảo
- NVIDIA Technical Blog: thông báo mở mã nguồn Run:ai
- NVIDIA Run:ai
- KAI Scheduler
- GPU Fractioning Operator
- KAI Resource Management
- Workload Map
- Model Streamer
- Grove
Bài viết liên quan
- Xác nhận mức độ sẵn sàng của cụm GPU trước khi triển khai các tác vụ AI
- Nâng cao hiệu suất trong huấn luyện LLM quy mô lớn bằng cách sử dụng song song tensor không đồng nhất
- Xây dựng chatbot AI nội bộ cho doanh nghiệp: Nhanh hơn, đúng ngữ cảnh hơn, kiểm soát tốt hơn
- Kỷ nguyên của Agentic AI: Hạ tầng Blackwell thiết lập tiêu chuẩn hiệu năng mới với Benchmark AgentPerf
- Bên trong nền tảng NVIDIA Vera Rubin: 7 bộ xử lý mới, 1 Siêu máy tính AI