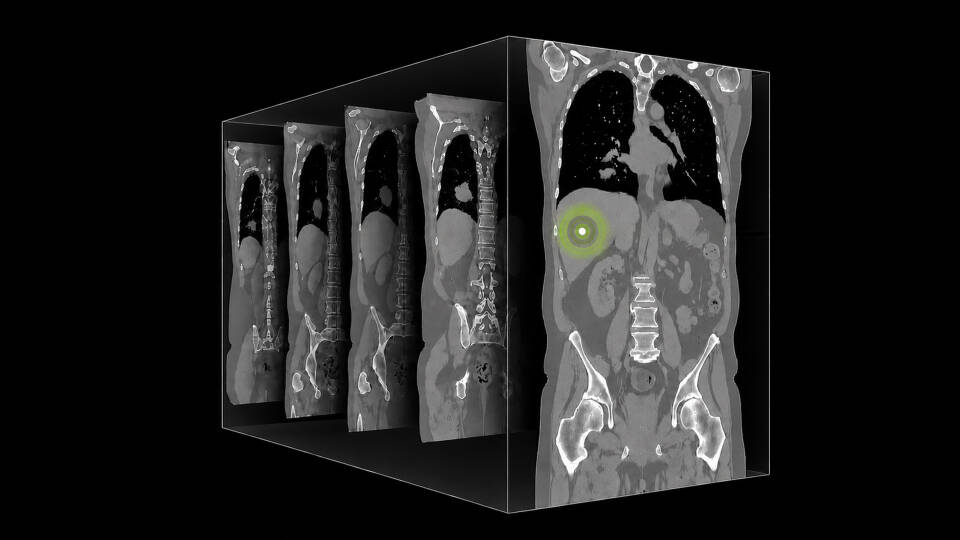
AI trong lĩnh vực chẩn đoán hình ảnh đã đạt được những bước tiến đáng kể trong việc phát hiện các bất thường trên X-quang ngực, tiêu bản bệnh lý và các bản quét 2D. Tuy nhiên, một trong những phương thức giàu thông tin lâm sàng và mật độ dữ liệu cao nhất—chụp cắt lớp vi tính (CT) 3D—vẫn chưa được các mô hình ngôn ngữ thị giác (VLMs) hiện đại hỗ trợ đầy đủ. Các mô hình đa năng tiên phong hoạt động kém hiệu quả với hình ảnh thể tích, và hầu hết các mô hình AI y tế mã nguồn mở đều thiếu chiều sâu hội thoại đa bước mà các bác sĩ chẩn đoán hình ảnh cần để tin tưởng và xác minh các phát hiện do AI tạo ra.
NVIDIA đang giải quyết khoảng trống này với NV-Reason-CT, một VLM được thiết kế riêng cho phân tích CT 3D. NV-Reason-CT mở rộng lập luận theo chuỗi suy nghĩ (chain-of-thought) cho CT thể tích toàn phần, tạo ra các báo cáo chẩn đoán có cấu trúc, mô phỏng tư duy nội tại của bác sĩ chẩn đoán hình ảnh và hỗ trợ hội thoại theo dõi đa bước đối với vùng ngực và bụng. Nó được xây dựng dựa trên phương pháp luận lập luận tiên phong bởi NV-Reason-CXR, đã được xác thực trong một nghiên cứu lâm sàng đa người đọc được chấp nhận tại RSNA 2026, xác nhận việc tiết kiệm thời gian cho bác sĩ trong khi duy trì độ chính xác chẩn đoán.
NV-Reason-CT là một nền tảng nghiên cứu và phát triển mở; không phải là hệ thống chẩn đoán tự động hay sản phẩm lâm sàng đã được phê duyệt. Đây là một mô hình AI nền tảng được thiết kế cho các nhà nghiên cứu và nhà phát triển đang xây dựng các ứng dụng phân tích CT chuyên biệt, để huấn luyện lại (post-train) cho trường hợp sử dụng của họ.
Tại sao suy luận CT 3D đòi hỏi một cách tiếp cận khác
Một nghiên cứu CT bụng đơn lẻ có thể bao gồm 300–600 lát cắt trục, mã hóa ngữ cảnh giải phẫu học trên ba chiều không gian mà một bộ mã hóa 2D tiêu chuẩn đơn giản không thể tái tạo từ các lát cắt độc lập.
Độ phức tạp thể tích này tạo ra một loạt các thách thức chồng chéo đối với AI y tế trong việc xử lý nhận thức, suy luận và độ sâu hội thoại:
- Nhận thức: Các VLM tiêu chuẩn xử lý đầu vào hình ảnh như một lưới token 2D. Việc xử lý một khối CT như một chồng các khung 2D độc lập sẽ làm mất đi các mối quan hệ không gian giữa các lát cắt định nghĩa các cấu trúc như khối u, tràn dịch và thâm nhiễm—những cấu trúc mà hình dạng, phạm vi và mật độ của chúng chỉ trở nên có ý nghĩa lâm sàng trong ba chiều.
- Lập luận: Ngay cả những mô hình nhận thức đúng một bất thường thường vẫn chỉ đưa ra nhãn chẩn đoán mà không giải thích lý do tại sao. Bác sĩ X-quang không suy nghĩ theo nhãn—they suy nghĩ bằng các đánh giá giải phẫu có hệ thống, chẩn đoán phân biệt và mức độ tin cậy. Một AI không thể tái tạo quá trình lập luận đó thì không thể được kiểm toán, học hỏi từ, hoặc tích hợp an toàn vào các quy trình lâm sàng.
- Độ sâu hội thoại: Một bác sĩ chẩn đoán hình ảnh khi xem xét một phát hiện đáng ngờ sẽ không kết thúc ca bệnh ngay từ cái nhìn đầu tiên. Họ sẽ đặt các câu hỏi tiếp theo, xem xét lại các chẩn đoán phân biệt và đối chiếu các phát hiện giữa các vùng giải phẫu. Hầu hết các mô hình hiện có đều thiếu khả năng hội thoại đa lượt để hỗ trợ loại suy luận lâm sàng lặp đi lặp lại này.
Cung cấp suy luận 3D đầy đủ cho phân tích CT
NV-Reason-CT kết hợp bộ mã hóa transformer thị giác (ViT) 3D đầy đủ chuyên dụng với một mô hình ngôn ngữ được huấn luyện để tạo ra lập luận theo chuỗi suy nghĩ (chain-of-thought) mô phỏng cách các bác sĩ chẩn đoán hình ảnh phân tích các khối CT một cách có hệ thống.
Khác với các phương pháp điều chỉnh bộ mã hóa 2D cho CT bằng cách xử lý các lát cắt một cách độc lập, NV-Reason-CT xử lý khối CT như một đầu vào 3D thực sự. Điều này duy trì tính liên tục giải phẫu xuyên qua các mặt phẳng và cho phép mô hình suy luận về các cấu trúc một cách toàn diện, giống như cách một bác sĩ chẩn đoán hình ảnh sẽ làm khi cuộn qua một nghiên cứu.
Các khả năng chính của mô hình bao gồm:
- Đóng tạo báo cáo có cấu trúc: NV-Reason-CT tạo ra các báo cáo có cấu trúc chi tiết. Nhóm NVIDIA đã tuyển chọn một hệ thống phân loại CT bao gồm 30 bất thường ở ngực và 29 bất thường ở bụng để hướng dẫn và đánh giá mô hình—chẳng hạn như nốt phổi, tràn khí màng phổi, tổn thương gan, nang thận và nhiều hơn nữa—trong định dạng ánh xạ tự nhiên đến các quy trình ghi chép lâm sàng.
- Chuỗi suy luận mô phỏng bác sĩ chẩn đoán hình ảnh: NV-Reason-CT cũng có thể tạo ra các suy luận mô phỏng chuỗi suy nghĩ của bác sĩ chẩn đoán hình ảnh. Mô hình tạo ra suy nghĩ nội bộ từng bước—kiểm tra các vùng giải phẫu một cách có hệ thống, đưa ra các phát hiện liên quan, xem xét các chẩn đoán phân biệt và diễn đạt sự không chắc chắn—theo phong cách của một bác sĩ chẩn đoán hình ảnh giàu kinh nghiệm khi xử lý một nghiên cứu.
- Đàm thoại theo nhiều bước: Các nhà lâm sàng và nhà nghiên cứu có thể đặt các câu hỏi tiếp theo về các phát hiện cụ thể, yêu cầu làm rõ các chẩn đoán phân biệt hoặc tìm hiểu về suy luận của mô hình ở bất kỳ giai đoạn nào. Khả năng đa lượt này biến NV-Reason-CT từ một trình tạo báo cáo thành một đối tác chẩn đoán tương tác.
- Trình mã hóa ViT 3D đầy đủ: Một trình mã hóa thị giác 3D được thiết kế riêng xử lý các thể tích CT một cách bản địa, trích xuất các đặc trưng thể tích mà các phương pháp dựa trên 2D không thể khôi phục. Ngoài ra, các tọa độ lưới token thị giác 3D được truyền đến LLM để tính đến mối quan hệ không gian giữa các token xuyên suốt các lớp LLM thông qua 3D MRoPE. Lựa chọn kiến trúc này cho phép mô hình suy luận về phạm vi không gian, hình thái học mặt cắt ngang và mối quan hệ giữa các lát cắt—nền tảng cảm nhận của việc diễn giải CT chính xác.
Kiến trúc NV-Reason-CT được thiết kế riêng như thế nào cho suy luận thể tích?
Kiến trúc mô hình kết hợp LLM Qwen3.5-4B với 3D ViT (Primus/Colipri). Tất cả các trọng số được huấn luyện lại từ đầu đến cuối trên dữ liệu CT của nhóm bệnh nhân lớn có báo cáo có cấu trúc, các vết suy luận và VQA nhiều bước (được thiết kế nội bộ). Các VLM dựa trên transformer tiêu chuẩn được thiết kế cho hình ảnh 2D. Việc điều chỉnh chúng cho CT bằng cách dẹt một khối thể tích thành một chuỗi các lát cắt 2D sẽ làm mất đi cấu trúc không gian định nghĩa bệnh lý thể tích.
Kiến trúc bộ mã hóa được điều chỉnh từ Primus 3D ViT, được khởi tạo với các trọng số Colipri trước khi huấn luyện; Nó xử lý các khối CT được lấy mẫu lại thành 192³ voxel ở độ phân giải đẳng hướng 2 mm, sử dụng các token patch 8x8x8 không chồng lấn—kết quả là ngữ cảnh token thị giác 24x24x24 = 13.824. Thay vì hợp nhất (hoặc thu nhỏ), tất cả các token thị giác được truyền đến LLM (cùng với các tọa độ lưới 3D của chúng). LLM bao gồm 3D MRoPE để tính đến mối quan hệ không gian 3D của các token thị giác.
Thành phần mô hình ngôn ngữ được huấn luyện để suy luận theo phong cách của bác sĩ chẩn đoán hình ảnh: xem xét có hệ thống các vùng giải phẫu, ghi nhận các phát hiện bình thường cùng với các phát hiện bất thường, thể hiện sự không chắc chắn được hiệu chỉnh và đưa ra kết luận có cấu trúc. Mô hình được thiết kế để phản hồi không như một bộ phân loại, mà như một người giáo viên: giải thích vấn đề, đi qua các bằng chứng và đưa ra chẩn đoán thông qua các bước logic có thể nhìn thấy.
Phương pháp huấn luyện NV-Reason-CT là gì?
Dựa trên cách tiếp cận được giới thiệu với NV-Reason-CXR, NV-Reason-CT tuân theo quy trình huấn luyện hai giai đoạn: tinh chỉnh có giám sát tiếp theo là học tăng cường (RL).
Giai đoạn 1: Tinh chỉnh có giám sát trên dữ liệu suy luận của bác sĩ chẩn đoán hình ảnh
Giai đoạn đầu tiên huấn luyện mô hình trên hỗn hợp dữ liệu, bao gồm báo cáo có cấu trúc, chú thích lập luận của bác sĩ X-quang chuyên gia và VQA tổng quát. Các bác sĩ X-quang đã đóng góp các bản ghi âm suy luận theo chuỗi chi tiết cho các nghiên cứu CT, nắm bắt quá trình xem xét nội bộ của họ, bao gồm những gì họ kiểm tra ở mỗi vùng giải phẫu, những phát hiện nào họ coi là quan trọng, những chẩn đoán phân biệt nào họ cân nhắc và cách họ đưa ra đánh giá cuối cùng.
Chương trình đào tạo kết quả bao gồm khoảng 550.000 ví dụ QA có cấu trúc trên các vùng ngực và bụng, bao gồm QA giải phẫu theo phần, QA phát hiện cụ thể theo bên và vị trí, QA theo mức độ nghiêm trọng và xác định bất thường nhị phân. Các ví dụ từ chối cho các prompt không hợp lệ và các cặp hình ảnh-văn bản không khớp đã được bao gồm để cải thiện độ bền.
Dữ liệu huấn luyện bao gồm CT-RATE, các bộ dữ liệu CT của NIH và CancerVerse. Bộ dữ liệu này được bổ sung bằng dữ liệu suy luận tổng hợp chất lượng cao được chưng cất từ các mô hình ngôn ngữ lớn, sử dụng các chú thích của bác sĩ X-quang chuyên gia làm ví dụ nền tảng. Bộ dữ liệu kết hợp cung cấp cho mô hình tín hiệu phong phú về cách suy luận X-quang có cấu trúc trông như thế nào trên một phạm vi rộng các phát hiện CT.
Giai đoạn 2: RL cho chất lượng suy luận
Giai đoạn thứ hai sử dụng Tối ưu hóa Chính sách Tương đối Nhóm (GRPO) để tinh chỉnh chất lượng suy luận. Một hàm phần thưởng dựa trên độ chính xác của các bất thường và chẩn đoán được xác định sẽ hướng dẫn mô hình tạo ra các lập luận không chỉ có cấu trúc tốt mà còn chính xác về mặt lâm sàng. Phần thưởng GRPO nhận thức được giải phẫu. Mô hình được tăng cường cho độ chính xác trong mỗi vùng giải phẫu thay vì sử dụng một tín hiệu toàn cục duy nhất, điều này cải thiện hiệu chỉnh trên toàn bộ phân bố phát hiện ngực-bụng.
Cách tiếp cận hai giai đoạn này (học các mẫu suy luận trước, sau đó tăng cường tính chính xác) cho phép NV-Reason-CT khái quát hóa trên sự đa dạng của các biểu hiện CT mà không cần các chuỗi suy luận được chú thích đầy đủ cho toàn bộ phân bố huấn luyện.
Kết quả đánh giá hiệu năng
NV-Reason-CT đạt kết quả tốt nhất hiện tại trên các bộ dữ liệu đánh giá công khai hàng đầu cho việc hiểu CT 3D.
Trên CT-RATE, bộ tiêu chuẩn công khai chính cho việc hiểu CT 3D, NV-Reason-CT vượt trội hơn tất cả các baseline đã công bố, bao gồm các mô hình tương phản 3D (VoxelFM, Pillar-0, CT-CLIP, Merlin), các MLLM kết hợp 2D/3D (ClinFusion-8B) và các mô hình biên dựa trên lát cắt (MedGemma 1.5). Đây là lần đầu tiên một mô hình mở duy nhất đạt được hiệu suất cạnh tranh trong cả phân loại CT và tạo báo cáo cùng lúc.
| Mô hình | Loại | Macro-F1 | Macro-AUROC |
|---|---|---|---|
| NV-Reason-CT | VLM sinh 3D bản địa | 0.614 | 0.871 |
| VoxelFM | tiền huấn luyện chỉ hình ảnh 3D | 0.581 | 0.870 |
| Pillar-0 | đối chiếu 3D | 0.544 | 0.861 |
| ClinFusion-8B | MLLM tạo sinh 2D/3D hợp nhất | 0.442 | n/r |
| CT-CLIP | đối chiếu 3D | 0.398 | 0.733 |
| Merlin | 3D tương phản | 0.358 | 0.662 |
| MedGemma 1.5 | Tối đa 85 lát cắt trục | 0.303 | n/r |
Ngoài hiệu suất benchmark, NV-Reason-CT đã nhận được những đánh giá lâm sàng tích cực từ các bác sĩ chẩn đoán hình ảnh của Viện Y tế Quốc gia Hoa Kỳ (NIH), những người đã xác nhận cả chất lượng của các báo cáo có cấu trúc lẫn tính hợp lý lâm sàng của các chuỗi suy luận.
“NV-Reason-CT cung cấp loại suy luận có hệ thống, từng bước phản ánh cách chúng tôi thực sự suy nghĩ khi xem xét một nghiên cứu CT,” ông Baris Turkbey, M.D., F.S.A.R., Bác sĩ cao cấp, Viện Y tế Quốc gia Hoa Kỳ, cho biết. “Việc có thể xem xét quá trình suy nghĩ của mô hình – không chỉ là kết luận của nó – chính là điều giúp chúng tôi có thể tin tưởng và hành động dựa trên các phát hiện của mô hình.”
Xác nhận lâm sàng và tác động thực tế
Giá trị của NV-Reason-CT vượt xa các điểm chuẩn. Các bác sĩ chẩn đoán hình ảnh và nhà nghiên cứu lâm sàng đã xem xét đầu ra của mô hình đều nhất quán nhấn mạnh hai khả năng giúp nó khác biệt so với các hệ thống AI CT trước đây:
- Tiết kiệm thời gian trong báo cáo có cấu trúc: Việc tạo ra một báo cáo chi tiết, có cấu trúc bao gồm hơn 60 bất thường là tốn thời gian, ngay cả đối với các bác sĩ chẩn đoán hình ảnh giàu kinh nghiệm. NV-Reason-CT tạo ra đầu ra này trong vài giây, với lập luận mà các nhà lâm sàng có thể quét nhanh, xác minh và chỉnh sửa—giảm bớt gánh nặng nhận thức của việc báo cáo thường quy trong khi vẫn duy trì sự giám sát của bác sĩ chẩn đoán hình ảnh.
- Tính giải thích được cho phép kiểm toán: Các mô hình AI y tế truyền thống chỉ xuất ra nhãn hoặc điểm số. NV-Reason-CT xuất ra lập luận của nó. Điều này làm cho kết luận của mô hình có thể kiểm toán được theo cách mà các hệ thống hộp đen không thể: một bác sĩ chẩn đoán hình ảnh có thể đọc chuỗi suy luận, xác định nơi lập luận của mô hình phù hợp với lập luận của họ và chỉ ra nơi nó khác biệt. Đây là loại tính minh bạch mà việc áp dụng lâm sàng đòi hỏi.
NV-Reason-CT có thể hỗ trợ nghiên cứu và AI y tế như thế nào?
NV-Reason-CT được thiết kế như một nền tảng để cộng đồng AI y tế rộng lớn hơn có thể xây dựng dựa trên đó.
Các nhà nghiên cứu có thể sử dụng các checkpoint mô hình và công thức hậu huấn luyện để nghiên cứu lập luận chuỗi suy nghĩ trong hình ảnh y tế, tinh chỉnh trên các bộ dữ liệu CT cụ thể của tổ chức, hoặc tích hợp NV-Reason-CT vào các pipeline nghiên cứu đa phương thức. Các mô hình bổ trợ cho phân đoạn và SDG bao gồm NV-Generate-CTMR và NV-Segment-CTMR.
Các công ty AI y tế, bao gồm các nhà cung cấp quy trình làm việc chẩn đoán hình ảnh, các nhà phát triển PACS và các nền tảng hỗ trợ quyết định lâm sàng, có thể điều chỉnh NV-Reason-CT cho các ứng dụng lâm sàng cụ thể. Điều này cho phép tích hợp lập luận CT có cấu trúc vào các quy trình xem xét chẩn đoán hình ảnh hiện có. Các công ty như Aidoc, HOPPR, Rad AI, Mosaic Clinical Technologies và Raidium hoạt động trong các lĩnh vực mà một mô hình 3D CT mở, có khả năng hội thoại và hiệu quả có thể giải quyết một khoảng trống năng lực thực sự.
Ví dụ về việc chạy và kết quả đầu ra của NV-Reason-CT
Ví dụ sau đây tải NV-Reason-CT và thực hiện một lượt suy luận trên một khối CT 3D. Các checkpoint có sẵn trên Hugging Face. Kho GitHub bao gồm các kịch bản suy luận, cấu hình huấn luyện và các công thức hậu huấn luyện.
import torch
from transformers import AutoModelForImageTextToText, AutoProcessor

model_name = "nvidia/NV-Reason-CT"

model = AutoModelForImageTextToText.from_pretrained(
    model_name,
    trust_remote_code=True,
    attn_implementation="sdpa",
    torch_dtype=torch.float16,
).eval().to("cuda")


processor = AutoProcessor.from_pretrained(model_name, trust_remote_code=True)

messages = [
    {
        "role": "user",
        "content": [
            {"type": "image"},
            {"type": "text", "text": "full chest CT reasoning analysis"}
        ]
    }
]

# Create prompt using chat template

text = processor.apply_chat_template(
    messages,
    add_generation_prompt=True,
    tokenize=False,
    enable_thinking=True
)

# Process inputs

inputs = processor(
    text=prompt,
    images3d=["chest_ct.nii.gz"],
    anatomy_region="chest",
    return_tensors="pt",
).to(model.device)

# Generate chain-of-thought reasoning and structured report

with torch.inference_mode():
    generated_ids = model.generate(
        **inputs,
        max_new_tokens=4096,
        do_sample=False,
        use_cache=True,
    )

# Decode

new_tokens = generated_ids[:, inputs.input_ids.shape[1]:]
response = processor.batch_decode(
    new_tokens,
    skip_special_tokens=True,
    clean_up_tokenization_spaces=False,
)[0]

print(response)
Trích đoạn đầu ra
 I will review the CT volume systematically, use the valid technique context,
identify the key imaging findings, and then provide the final labels.

We are going to review this IV contrast-enhanced CT of the chest in a systematic way.
First, one important technical and support-device detail: there is a left-sided port catheter,
and the catheter tip terminates in the superior vena cava, which is an expected central venous position.

I will begin with the lungs and airways. The central airways are patent, so there is no major tracheal
or main bronchial occlusion. However, when we come down into the right lung, the right lower lobe
is the dominant abnormality. There is a large mass-like process in the right lower lobe, and it is associated
with partial collapse of the right lower lobe. This is a meaningful finding because a mass with postobstructive
or associated volume loss is concerning for a malignant process.

There is also an additional mass-like lesion in the right lower lobe [...].

So overall, the dominant thoracic finding is a large right lower lobe mass-associated partial collapse,
with additional right lower lobe mass-like disease and bulky mediastinal and right hilar adenopathy.
The pattern is concerning for thoracic malignancy with nodal involvement. There are also scattered bilateral
ground-glass opacities that remain nonspecific and could be inflammatory, infectious, or neoplastic.
In addition, there is lytic lower thoracic spine disease with moderate spinal stenosis and a few indeterminate
right rib sclerotic lesions.
Cách NV-Reason-CT tích hợp vào hệ sinh thái AI Y tế của NVIDIA
NV-Reason-CT là một phần của dòng mô hình AI y tế mã nguồn mở NVIDIA Medical AI, được thiết kế để phối hợp hoạt động xuyên suốt quy trình chẩn đoán hình ảnh:
- NV-Generate-CTMR: Tổng hợp các thể tích CT và MRI 3D chân thực để tăng cường dữ liệu huấn luyện và nghiên cứu
- NV-Segment-CTMR: Phân đoạn tự động cơ quan và tổn thương từ dữ liệu CT và MR 3D
- NV-Reason-CXR: Suy luận theo chuỗi suy nghĩ cho phân tích X-quang ngực
- NV-Reason-CT: Suy luận theo chuỗi suy nghĩ cho phân tích CT 3D toàn bộ
Cùng nhau, các mô hình này cung cấp các khối xây dựng cho các quy trình AI chẩn đoán hình ảnh đầu-cuối — từ tạo dữ liệu tổng hợp, qua phân đoạn, đến suy luận lâm sàng minh bạch, hội thoại.
Khám phá hệ sinh thái NVIDIA Medical AI để tìm hiểu thêm.
Bắt đầu với NV-Reason-CT cho suy luận chuỗi suy nghĩ của bác sĩ chẩn đoán hình ảnh
NV-Reason-CT đưa lập luận theo chuỗi suy nghĩ (chain-of-thought) vào một trong những phương thức chẩn đoán có mật độ thông tin cao nhất trong y học. Bằng cách kết hợp bộ mã hóa ViT 3D đầy đủ chuyên dụng với mô hình ngôn ngữ được huấn luyện để lập luận, hệ thống tạo ra các báo cáo chẩn đoán có cấu trúc và quá trình suy luận từng bước theo phong cách bác sĩ chẩn đoán hình ảnh cho các khối dữ liệu CT—bao gồm các phát hiện ở ngực và bụng với hỗ trợ hội thoại đa lượt.
Đừng bỏ lỡ thông tin mới nhất bằng cách đăng ký tin tức NVIDIA và theo dõi NVIDIA Healthcare trên LinkedIn, X và YouTube.
Bài viết liên quan
- Thêm các điều khiển thời gian chạy cho các tác nhân AI với NVIDIA OpenShell
- Open Agent Safety Platform: AI Agent cần một lớp an toàn nằm ngoài chính nó
- Thêm các runtime control cho các tác nhân AI với NVIDIA OpenShell
- Xây dựng Agent dựa trên bộ nhớ với NVIDIA NemoClaw
- Tạo quỹ đạo, dấu vết lập luận và nhãn tự động với NVIDIA Alpamayo 2 Super