Một cụm GPU có thể vượt qua mọi bài kiểm tra sức khỏe nhưng vẫn không đủ điều kiện để chạy một tác vụ AI. Ngay cả khi mọi GPU, liên kết mạng và pod đều báo cáo trạng thái bình thường, một tác vụ huấn luyện 512 GPU vẫn có thể hoạt động kém hiệu quả hoặc thất bại. Nguyên nhân có thể là do một GPU chậm, một liên kết bị suy giảm hiệu suất dưới tải, hoặc một cấu hình âm thầm định tuyến lưu lượng qua một đường dẫn chậm hơn. Các nhà vận hành có thể không phát hiện ra vấn đề cho đến khi đã chạy được vài giờ hoặc cho đến khi một khách hàng gửi yêu cầu hỗ trợ. Khi đó, các nhóm có thể phải mất nhiều ngày để chia đôi cụm (bisecting) nhằm tìm ra nguyên nhân gốc rễ trong khi năng lực xử lý vẫn nằm im.
NVIDIA Cluster Readiness Engine (NVCRE) là một bộ điều khiển Kubernetes mã nguồn mở giúp thu hẹp phạm vi tìm kiếm xuống các nút cụ thể liên quan trước khi các tác vụ sản xuất được triển khai. Nó chạy các tác vụ phân tán thực tế trên các nhóm nút nhận thức được cấu trúc topo, đo lường kết quả và báo cáo những nút nào đã thất bại trong từng bài kiểm tra. Các nhà vận hành không còn cần phải viết thủ công các manifest của Thư viện Truyền thông Tập thể NVIDIA (NCCL), chia đôi các rack thủ công, hoặc phải biết về phần cứng bị suy giảm từ các yêu cầu hỗ trợ của khách hàng. Sẵn sàng hoạt động trở thành một thuộc tính đã được chứng minh của cụm thay vì một giả định.
Cần gì để xác nhận cụm sẵn sàng?
Một cụm GPU trở nên sẵn sàng theo từng giai đoạn. Nó trải qua các bước khởi động, chạy thử, tiền sản xuất và sản xuất, trong đó mỗi giai đoạn đặt ra một tiêu chuẩn khác nhau. Một nút (node) vượt qua bài kiểm tra nhanh (smoke test) chưa chắc đã sẵn sàng để tham gia vào một phiên chạy huấn luyện 512 GPU.
Các nhóm nền tảng thường mã hóa quá trình đó trong một runbook, bảng tính hoặc các script shell bao quanh các bài kiểm tra NCCL. Nó trở thành một hệ thống khác mà họ phải xây dựng và bảo trì cùng với cấu hình node, chia sẻ GPU và điều phối workload.
Một cụm có thể vượt qua các chẩn đoán tiêu chuẩn nhưng vẫn thất bại dưới một tác vụ phân tán thực tế, vì vậy cách tốt nhất để kiểm tra mức độ sẵn sàng là chạy một workload. Trên Slurm, điều đó chỉ cần một lệnh srun duy nhất. Kubernetes không có tương đương tích hợp sẵn, do đó cùng một bài kiểm tra yêu cầu các yêu cầu tài nguyên GPU và truy cập bộ nhớ trực tiếp từ xa (RDMA), các cài đặt NCCL phù hợp với mạng fabric, một volume bộ nhớ chia sẻ đủ lớn và một cách để đảm bảo rằng tất cả các pod khởi động cùng lúc.
NVCRE lấp đầy những khoảng trống này trên Kubernetes. Nó chạy các tác vụ làm lộ ra các vấn đề phần cứng thực tế và chỉ ra chính xác node nào gây ra mỗi sự cố.
communication/nccl-all-reduce
Status:       Failed
Runtime:      42m 18s
Scale:        full-scale
Nodes/Job:    8

Failed Nodes:
  gpu-node-07  ThresholdViolation
  gpu-node-12  HardwareFailureDetected

Summary
Categories:   1/2 passed
Failed Nodes: 2
Result:       FAILED
Cách NVCRE hoạt động
API là bề mặt sản phẩm. Các định nghĩa tài nguyên tùy chỉnh (CRD) xác định từng tài nguyên, do đó bạn có thể kiểm tra bằng kubectl và quản lý thông qua các quy trình GitOps.
API phân tầng
API có ba tài nguyên được sắp xếp theo phân cấp.
- Chứng nhận: Tài nguyên bạn tạo ra. Nó chỉ định các nút cần kiểm tra và các danh mục cần chạy.
- Quy trình: Quản lý một danh mục. Nó áp dụng các ghi đè về danh mục, nền tảng và GPU; quản lý số lần lặp; đặt mục tiêu điều phối; và tạo tác vụ con.
- Tác vụ: Chạy tải việc cho nhóm nút đích, giám sát sức khỏe của các nút và ghi lại các phép đo và sự cố.
Một chứng nhận tạo ra một luồng công việc cho mỗi danh mục, và mỗi luồng công việc tạo ra công việc con của nó.
Kết quả sau đó được lan truyền lên phía trên. Công việc ghi lại các nút nào đã thất bại và lý do tại sao, luồng công việc báo cáo kết quả kiểm tra, và chứng nhận nhóm các kết quả theo danh mục.
Cấp phân cấp đó gán mỗi sự cố cho một nút và danh mục cụ thể. Ví dụ, một lần chạy báo cáo rằng gpu-01 gặp lỗi phần cứng trong quá trình NCCL và gpu-02 không đạt được mục tiêu băng thông.
Xác thực cụm
Ví dụ sau đây cho thấy cách một chứng chỉ đặt tên cho các mục tiêu và các danh mục cần chạy.
apiVersion: nvcre.nvidia.com/v1alpha1
kind: Certification
metadata:
  name: gpu-cluster-cert
spec:
  target:
    nodeSelector:
      nvidia.com/gpu.present: "true"
  categories:
    - domain: communication
      variant: nccl-all-reduce
    - domain: training
      variant: nemotron5-8b
$ kubectl apply -f certification.yaml
$ kubectl get certifications.nvcre.nvidia.com -w
Danh mục tích hợp hiện tại bao phủ ba lĩnh vực: năm biến thể giao tiếp NCCL (all-reduce, all-gather, all-to-all, loopback và loopback trên NVIDIA NVSwitch), bộ chẩn đoán cấp 4 của NVIDIA Data Center GPU Manager (DCGM) và tiền huấn luyện NVIDIA NeMo với các mô hình NVIDIA Nemotron 5 có 8B và 56B tham số. Mỗi mục bao gồm các giá trị mặc định nhận thức nền tảng.
NVCRE phát hiện kiến trúc GPU và nền tảng đám mây từ các nút đích và suy ra phần còn lại của cấu hình, bao gồm số lượng GPU trên mỗi nút, môi trường NCCL và mạng lưới cụ thể cho từng nền tảng.
Tiêu chí đạt dưới dạng biểu thức
Tiêu chí đạt và không đạt sử dụng Common Expression Language (CEL) và được đánh giá dựa trên các chỉ số đo được. Không có ngưỡng nào được cài đặt mặc định. Các giá trị dưới đây là ví dụ minh họa cho các hệ thống thuộc lớp NVIDIA GB200 NVL72.
  categories:
    - domain: communication
      variant: nccl-all-reduce
      options:
        thresholds:
          busBandwidthGBps: "value >= 900"
    - domain: training
      variant: nemotron5-8b
      options:
        thresholds:
          goodputRatio: "value >= 0.9"
          avgTFLOPsPerGPU: "value >= 800"
Khi một chỉ số đo được không đạt mục tiêu, NVCRE sẽ đặt điều kiện ValidationFailed, được ghi nhận riêng biệt với việc bản thân lần chạy có thành công hay không. Một tác vụ hoàn tất nhưng không đạt mục tiêu vẫn được báo cáo là thất bại.
Kiểm thử ở quy mô mà các lỗi xuất hiện
Một số lỗi chỉ hiển thị ở một quy mô nhất định, do đó chiến lược nhóm được xác định rõ ràng. Trường testScale chọn chiến lược.
- Kiểm tra nội nút (Intra-node) kiểm tra từng nút một cách độc lập.
- Kiểm tra nội rack (Intra-rack) phân vùng các nút theo miền topology bằng nhãn
nvidia.com/gpu.clique. - Full-scale đặt mọi node vào một nhóm duy nhất.
- Diagnose chạy cách ly lỗi thích ứng (được đề cập ở phần tiếp theo).
Chiến lược bạn chọn sẽ quyết định những gì được đo lường. Một bài kiểm tra NCCL trong một miền NVIDIA NVLink đo băng thông NVLink, trong khi cùng bài kiểm tra đó trên ba rack đo mạng scale-out. Hai thứ này đo những thứ khác nhau.
Cách ly lỗi thích ứng
Trường hợp khó khăn nhất trong xác thực đa nút là sự cố không thể quy cho bất kỳ nút đơn lẻ nào. Một lệnh all-reduce trên 64 nút trả về băng thông thấp, và mọi nút trong nhóm đều bị nghi ngờ như nhau. Việc cô lập nguyên nhân thủ công có thể mất hàng ngày công sức kỹ thuật.
NVCRE tự động hóa quá trình cô lập đó. Việc đặt testScale: diagnose sẽ chạy kiểm tra nhóm phân cấp nhận thức topology. Bộ xử lý chia mỗi nhóm bị lỗi thành hai nửa, chạy lại các nửa đó và tiếp tục cho đến khi đạt đến minGroupSize. Các nhóm vẫn bị lỗi ở kích thước đó sẽ được đánh dấu là nghi phạm. maxConcurrent giới hạn số lượng công việc chạy đồng thời để chúng không làm bão hòa fabric đang được đo lường.
Đầu ra chỉ ra một số nhỏ các nút nghi vấn thay vì quy trách nhiệm cho toàn bộ nhóm và nêu rõ lý do mỗi nút bị lỗi.
Chạy bất kỳ tác vụ nào: API WorkloadRun
Việc chạy tác vụ GPU đa nút trên Kubernetes đòi hỏi phát hiện nền tảng, cấu hình runtime cụ thể theo framework, yêu cầu tài nguyên GPU và mạng, cũng như dọn dẹp sau một lần chạy thất bại. Quy trình thiết lập đó lặp đi lặp lại và dễ xảy ra lỗi.
WorkloadRun xử lý việc thiết lập: cung cấp một hình ảnh container, chọn một framework và chỉ định số lượng nút.
apiVersion: nvcre.nvidia.com/v1alpha1
kind: WorkloadRun
metadata:
  name: nccl-all-reduce
spec:
  image: nvcr.io/nvidia/pytorch:26.01-py3
  framework:
    mpi:
      binary: /usr/local/bin/all_reduce_perf_mpi
      args: ["-b", "8", "-e", "32G", "-f", "2", "-n", "100"]
      mpirunPath: /usr/local/mpi/bin/mpirun
  numNodes: 4
  bandwidthMeasurement:
    logProfileRef: nccl-bandwidth
    testType: all_reduce
Trường framework hỗ trợ chính xác một trong số torch (đào tạo phân tán thông qua torchrun), mpi (các bài kiểm tra NCCL và các tác vụ MPI khác), hoặc exec (một lệnh tùy ý). NVCRE tạo ra TrainingRuntime Kubeflow tương ứng, tiêm volume bộ nhớ chia sẻ, thiết lập các biến môi trường NCCL và nền tảng, và kích hoạt mạng mở rộng NVIDIA NVLink khi phần cứng hỗ trợ.
Nếu không có bộ lập lịch gang, bộ lập lịch Kubernetes mặc định sẽ đặt các pod một cách độc lập, và các rank sẽ chờ đợi các đồng cấp của chúng tại điểm hội tụ của framework. Trên một cụm bận rộn, điều đó có thể gây ra deadlock: các pod được đặt một phần sẽ giữ GPU trong khi chờ đợi các đồng cấp không bao giờ đến. Việc thiết lập spec.gangScheduler sẽ đưa mọi pod tác vụ vào một bộ lập lịch nhận thức được gang, chẳng hạn như KAI Scheduler, giữ tất cả các pod cho đến khi toàn bộ gang có thể được đặt cùng một lúc.
Bởi vì WorkloadRun là một CRD thuần túy, các công cụ bên ngoài có thể sử dụng nó để chạy các tác vụ mà không cần áp dụng phần còn lại của NVCRE. NVCRE cung cấp đường dẫn thực thi, và công cụ gọi sẽ cung cấp bài kiểm tra.
Cấu hình, xác thực và giám sát các cụm AI ở quy mô lớn
Một cụm máy chủ phải trả lời ba câu hỏi trên con đường đưa vào sản xuất: Nó được cấu hình đúng chưa? Nó sẵn sàng chạy một tác vụ AI thực tế chưa? Nó có đang hoạt động khỏe mạnh ngay lúc này không? Mỗi lớp khác nhau của NVIDIA DSX OS giải quyết từng câu hỏi.
NVIDIA AI Cluster Runtime (AICR) thiết lập và duy trì cấu hình cụm đã được xác thực. AICR ghi lại các tổ hợp đã được xác thực của trình điều khiển, operator, kernel và cài đặt hệ thống dưới dạng các công thức (recipes) được khóa phiên bản. Các nhóm có thể tái tạo cùng một cấu hình tối ưu trên các cụm khác nhau, xác minh trạng thái trực tiếp và phát hiện sự lệch (drift). Điều này giảm thiểu sự biến động hiệu suất và tránh việc phải mất nhiều ngày tinh chỉnh trong khi các GPU đắt tiền đang nằm im.
NVCRE xác minh rằng một cụm (cluster) đã sẵn sàng để chạy các tác vụ AI thực tế. Lớp chủ động, được điều khiển bởi tác vụ này tạo ra tải, do đó có thể tìm ra các sự cố không tạo ra dữ liệu giám sát (telemetry). Một GPU bị suy giảm hiệu suất sẽ làm chậm một công việc đào tạo đồng bộ xuống tốc độ của rank tệ nhất, và một bài kiểm tra băng thông NCCL có thể xác định vấn đề trong vài phút.
NVIDIA NVSentinel liên tục giám sát sức khỏe của cụm. Với vai trò là lớp thụ động, được điều khiển bởi dữ liệu giám sát, nó theo dõi các tín hiệu mà cụm đã tạo ra, bao gồm các chỉ số DCGM, lỗi Xid, nhật ký hệ thống và các sự kiện bảo trì của nhà cung cấp đám mây. Nó phát hiện các lỗi thời gian thực và có thể điều phối các quy trình cách ly, rút tải và khắc phục. Vì không tiêu tốn thời gian GPU, nó có thể chạy liên tục trong môi trường sản xuất, nơi mà việc kiểm thử chủ động sẽ chiếm GPU từ các tác vụ.
Mỗi dự án tạo ra giá trị độc lập và tích hợp với các dự án khác cho các nhóm vận hành toàn bộ hệ thống.
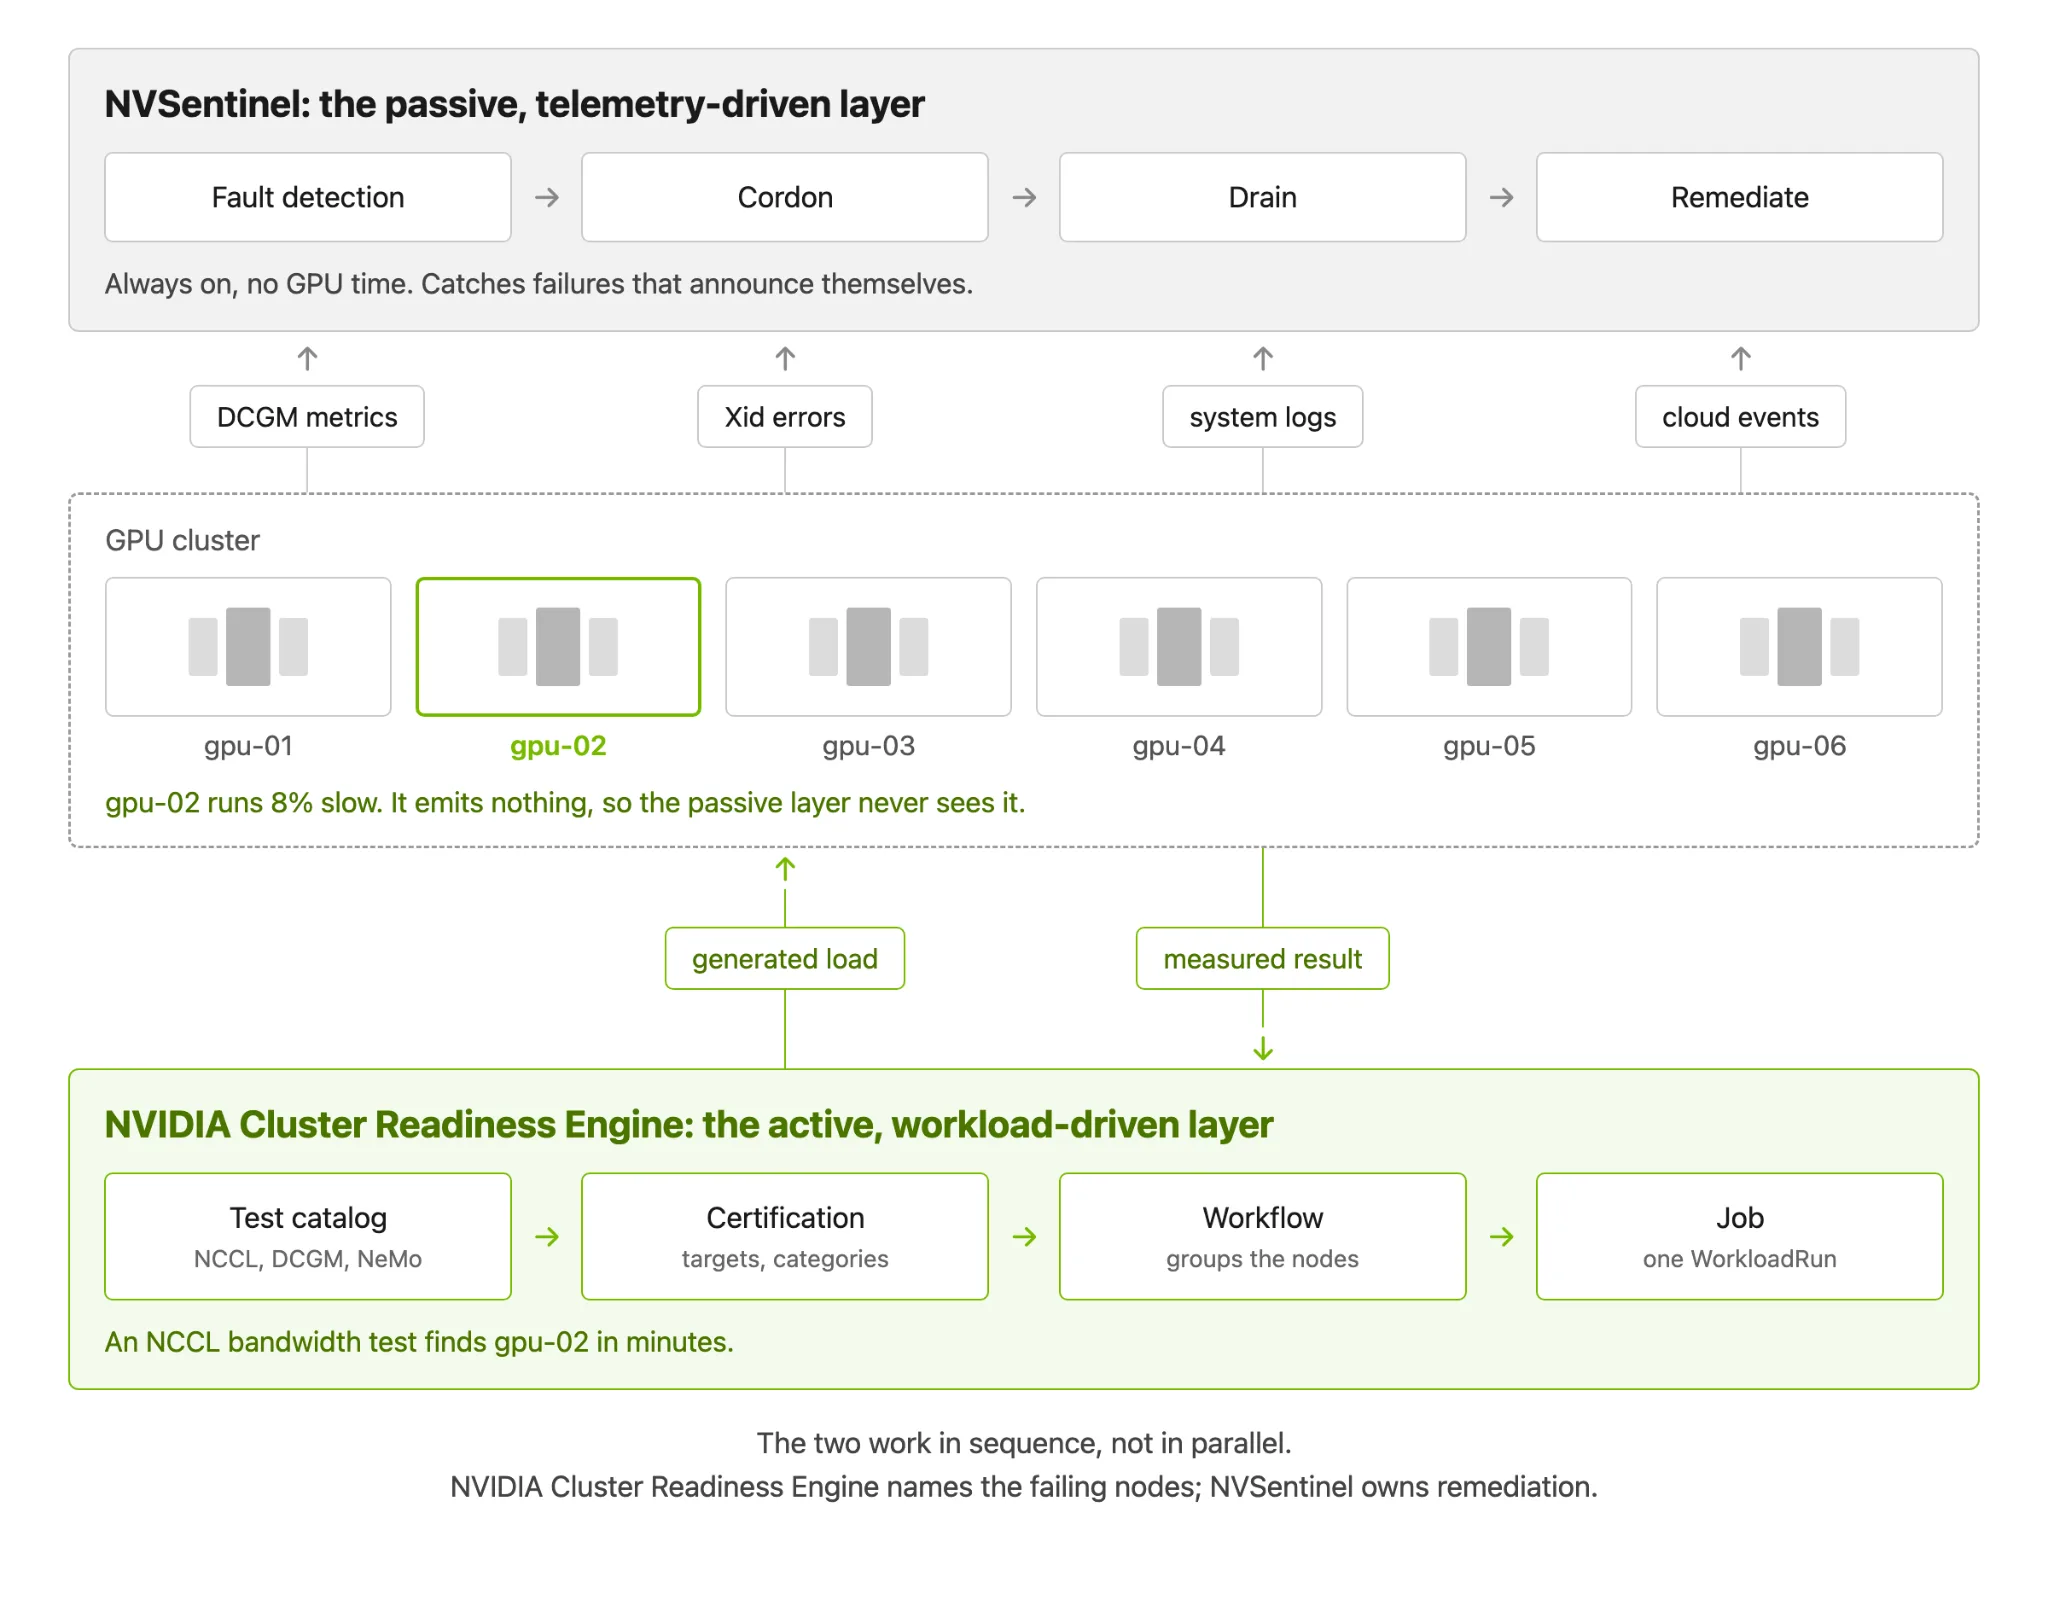
NVCRE ghi lại các nút bị lỗi và lý do. Nó không thực hiện cordon, taint hoặc vá các điều kiện của nút, nhằm tránh các hành động xung đột và việc dọn dẹp không đồng bộ. Trình giám sát chứng nhận NVCRE của NVSentinel có thể chuyển đổi các kết quả chứng nhận thất bại thành các sự kiện sức khỏe. Các chính sách NVSentinel được cấu hình sau đó có thể cách ly và rút dữ liệu khỏi các nút hoặc kích hoạt các biện pháp khắc phục bên ngoài. Một lần chứng nhận thành công sau đó có thể xóa tín hiệu lỗi và gỡ taint.
Hướng dẫn bắt đầu
NVCRE yêu cầu Kubernetes 1.29 trở lên, kubectl, Helm 3.x và NVIDIA GPU Operator trên cụm đích. Các mục danh mục NVIDIA GB200 NVL72 và NVIDIA GB300 NVL72 cũng yêu cầu NVIDIA DRA Driver cho GPU vì các mục này tạo ra các tài nguyên ComputeDomain. Danh mục cấp độ 4 của DCGM yêu cầu dịch vụ DCGM độc lập. Một bộ lập lịch nhận thức gang như KAI Scheduler là tùy chọn nhưng được khuyến nghị trên các cụm bận rộn, dùng chung.
Cài đặt CLI và thiết lập cụm. Lệnh nvcrectl setup init sẽ cài đặt CRDs, controller, Kubeflow Trainer và các hồ sơ nhật ký mặc định.
$ curl -fsSL https://github.com/NVIDIA/cluster-readiness-engine/releases/latest/download/installer | bash
$ nvcrectl setup init
Sau đó, chạy một quy trình xác thực đầu-cuối (end-to-end).
$ nvcrectl certification run --cert-file certification.yaml --wait
$ nvcrectl certification report gpu-cluster-cert -n
Báo cáo dưới đây liệt kê trạng thái của từng danh mục, thời gian chạy, băng thông đo được và bất kỳ nút nào bị lỗi, kèm theo lý do cho mỗi lỗi.
Certification Report

Name:     gpu-cluster-cert
Platform: aws
GPU:      gb300
Nodes:    16

communication/nccl-all-reduce
Status:       Succeeded
Runtime:      3m 56s
Scale:        full-scale
Nodes/Job:    16
MNNVL:        Enabled

Bandwidth:
  Size       AlgBW        BusBW        Samples
  16 GB      473.44 GB/s  932.09 GB/s  9

Summary
Categories:   1/1 passed
Failed Nodes: none
Result:       PASSED
Tham gia phát triển dự án
NVCRE được cấp phép theo Apache 2.0 và được phát triển theo hướng mở. Hãy báo cáo lỗi, yêu cầu tính năng hoặc đề xuất thay đổi trước khi gửi pull request trên GitHub. Bạn cũng có thể đóng góp các mục trong danh mục, bộ thích ứng khối lượng công việc, bài kiểm tra và tài liệu.
Sử dụng engine để xác nhận mức độ sẵn sàng của các cụm GPU trước khi triển khai sản xuất. Quy trình làm việc chung và danh mục kiểm thử của nó được thực hiện nhất quán trên các cụm Kubernetes, với hỗ trợ lộ trình cho các kiến trúc NVIDIA mới, suy luận và xác nhận vòng đời tự động.
Xác nhận trạng thái sẵn sàng của cụm GPU trước khi tác vụ sản xuất tiếp theo được triển khai.
Dự án này là một phần của NVIDIA DSX OS, lớp hệ điều hành của Nền tảng Nhà máy AI NVIDIA DSX.
Bài viết liên quan
- Nâng cao hiệu suất trong huấn luyện LLM quy mô lớn bằng cách sử dụng song song tensor không đồng nhất
- Hướng dẫn tạo LangChain Deep Agents Harness Profile cho NVIDIA Nemotron-3 Ultra để tối ưu hóa hiệu năng hệ thống Agent
- Mở rộng quy mô Inference AI trên nhiều GPU bằng NVIDIA TensorRT với Hỗ trợ Multi-Device Inference
- Xây dựng chatbot AI nội bộ cho doanh nghiệp: Nhanh hơn, đúng ngữ cảnh hơn, kiểm soát tốt hơn
- Kỷ nguyên của Agentic AI: Hạ tầng Blackwell thiết lập tiêu chuẩn hiệu năng mới với Benchmark AgentPerf