CUDA Toolkit 13.5 chuyển hỗ trợ kiến trúc NVIDIA Vera Rubin từ early developer access sang general availability (GA), sẵn sàng cho triển khai production. Bản phát hành đồng thời bổ sung cơ chế lập lịch SM chi tiết qua locality domain và MPS v3, giao tiếp đa GPU trong CUDA Tile, cùng các cập nhật cho CCCL, CUDA Python, thư viện toán học, trình biên dịch và bộ công cụ Nsight.
NVIDIA công bố CUDA 13.5 ngày 04/11/2026. Bên cạnh Vera Rubin, hỗ trợ Windows on Arm (GA từ CUDA 13.4) được mở rộng sang NVIDIA DGX Station for Windows.
Tổng quan thay đổi so với các phiên bản trước
| THÀNH PHẦN | TRƯỚC CUDA 13.5 | CUDA 13.5 |
|---|---|---|
| Vera Rubin | Early developer access | General availability, hỗ trợ production |
| Windows on Arm | GA từ CUDA 13.4 | Mở rộng sang DGX Station for Windows |
| Tile ↔ thư viện SIMT | Chỉ kết hợp qua ranh giới kernel, dữ liệu trung chuyển qua global memory | Gọi hàm thư viện SIMT bên trong Tile kernel, hợp nhất thành một kernel (public preview) |
| Giao tiếp đa GPU trong Tile kernel | Không hỗ trợ | Unicast/multicast pointer và multimem qua NVLink, NVSwitch (NVLink SHARP) |
| MPS SM partition | Cấu hình CUDA_MPS_SM_PARTITION cho từng client |
Gán theo namespace, áp dụng cho mọi client được định tuyến |
| MPS SM sử dụng | Partition cố định | SM lending/borrowing (--shareable, --max-chunks), weighted timeslicing |
cudaMemcpyBatchAsync |
Không ghi được vào CUDA Graph | Hỗ trợ stream capture và explicit graph node |
| cuBLAS BF16, shape không chia hết cho 8 | Hiệu năng thấp hơn FP16 | Dùng chung kernel tối ưu với FP16 (Hopper trở lên) |
| nvJPEG backend tự động | Chỉ xét HYBRID và HARDWARE |
Xét thêm GPU_HYBRID |
cuobjdump symbol table |
Trường hex thô | Cột mô tả Type, Bind, Vis, Other |
| Windows driver model | TCC cho GPU compute | Từ Rubin: WDDM và MCDM; TCC không được hỗ trợ |
Tính năng mới hoàn toàn: cub::DeviceBatchedTopK, deterministic floating-point scan, CUB public tuning API, cuda::args::deferred, nvprune --precompile, Nsight Perf SDK for AI, Nsight Compute Timeline.
Lập lịch và chia sẻ tài nguyên GPU
Nhóm cải tiến này nhắm vào bài toán multi-tenant: nhiều workload huấn luyện, suy luận và thử nghiệm cùng chia sẻ một GPU hoặc một cụm GPU, với yêu cầu cân bằng giữa tính công bằng, độ trễ dự đoán được và hiệu suất sử dụng phần cứng.
Locality domain: supplemental SM
Ở hành vi mặc định, các green-context partition theo locality domain nhận cùng số SM được đảm bảo; phần SM dư nằm ngoài partition.
- Flag
cudaDevSmResourceGroupLocalityDomainSupplementalSms, kết hợp vớicudaDevSmResourceGroupLocalityDomainId, phân bổ phần SM dư vào các domain được chọn để sử dụng toàn bộ SM của thiết bị; đánh đổi là kích thước partition không còn đồng nhất. cudaDevSmResourceSplit()có chế độ discovery, trả về số SM của từng partition để ứng dụng phân chia workload tương ứng.
NVIDIA MPS v3
| TÍNH NĂNG | CƠ CHẾ | TÁC ĐỘNG |
|---|---|---|
| Weighted timeslicing | Timeslice cơ sở nhân hệ số theo từng MPS server; điều chỉnh tần suất context switch | Ưu tiên thời gian thực thi cho workload compute-bound |
| SM partition load balancing | --max-chunks cho phép mượn SM vượt base partition; --shareable=true cho phép cho mượn SM idle; MPS thu hồi SM trước khi tái phân bổ |
Tăng utilization trong khi ứng dụng vẫn thấy base partition ổn định |
| Cgroup-based routing | Ánh xạ subtree cgroup v2 vào MPS namespace; client kết nối qua socket chính của daemon được định tuyến tự động | Tích hợp với container runtime và Kubernetes |
| Per-namespace SM partition | Partition chọn một lần cho mỗi thiết bị trong namespace; ưu tiên hơn CUDA_MPS_SM_PARTITION |
Loại bỏ cấu hình theo từng client |
| Polling-based memory accounting | MPS đọc trực tiếp usage và limit khi ra quyết định eviction | Fallback khi cgroup threshold notification không khả dụng |
Kích hoạt polling (trước khi memory accounting bắt đầu; phát sinh overhead trên mỗi quyết định eviction):
nvidia-cuda-mps-control memacct set force_polling=trueBatched 1D copy trong CUDA Graphs
Các lời gọi cudaMemcpyBatchAsync hiện có được ghi lại qua stream capture mà không thay đổi cú pháp, cho phép replay nhiều transfer trong một graph. Batched-copy node cũng có thể được thêm tường minh; địa chỉ và kích thước tương thích có thể cập nhật mà không thay đổi cấu trúc batch.
Windows driver model trên Rubin
Từ kiến trúc Rubin, CUDA hỗ trợ WDDM và MCDM (compute-only driver model). TCC không được hỗ trợ trên Rubin và các thế hệ sau; công cụ và ứng dụng phụ thuộc TCC cần chuyển sang WDDM hoặc MCDM.
CUDA Tile: giao tiếp đa GPU và Tile-to-SIMT interoperability
Multi-GPU communication trong Tile kernel
Tile kernel hỗ trợ giao tiếp trực tiếp giữa các GPU:
- Unicast pointer: truy cập bộ nhớ của GPU khác qua NVLink.
- Multicast pointer và multimem operation: reduction và store liên GPU trên NVSwitch fabric có NVLink SHARP.
Shared-memory mapping được thiết lập trước khi launch; communication và computation sau đó được fuse trong một kernel, ví dụ GEMM kết hợp cross-GPU reduction.
Tile-to-SIMT interoperability (public preview)
Trước phiên bản này, code Tile và thư viện SIMT chỉ kết hợp được qua ranh giới kernel, dữ liệu phải trung chuyển qua global memory. CUDA 13.5 cho phép Tile kernel (cuTile Python hoặc CUDA Tile C++) gọi device function của thư viện SIMT ngay trong thân kernel.
- Thư viện mục tiêu: NVSHMEM, CCCL Coop, Warp, MathDx (cuFFTDx, cuBLASDx, cuSolverDx, nvCOMPDx); các thư viện sẽ lần lượt kích hoạt interop.
- Tile library (
.tilelib) đóng gói interface và implementation; compiler xử lý thread partitioning, yêu cầu shared memory và synchronization, sinh ra một kernel duy nhất. - C++:
nvcc --tile-preview simt, truyềntilelibcho tile compiler. - Python:
cuda.tile_preview.foreign_calltrong packagecuda.tile_preview.
Giới hạn của preview: chỉ hỗ trợ hàm thư viện; gọi __device__ function do người dùng tự viết từ tile code nằm trong lộ trình phiên bản sau.
CUDA Python: cuda.core 1.2
cuda.core 1.2 bổ sung batched copy, Programmatic Dependent Launch (PDL) và cơ chế cập nhật CUDA Graph linh hoạt hơn. Các API mới mang tính bổ sung, không phá vỡ tương thích với mã hiện có.
Batched copy: copy_batch()
Gộp nhiều buffer copy vào một lời gọi driver, giảm launch overhead khi truyền nhiều tensor nhỏ. CopyOptions kiểm soát thứ tự truy cập nguồn, memory-location hint và hành vi overlap.
Trước đây (minh họa), mỗi bản sao tương ứng một lời gọi:
src_a.copy_to(dst_a, stream=stream)
src_b.copy_to(dst_b, stream=stream)
stream.sync()
cuda.core 1.2:
from cuda.core.utils import copy_batch

# Each source and destination pair must have matching sizes.
# Copies within the batch must not alias.
copy_batch(
    stream,
    srcs=[src_a, src_b],
    dsts=[dst_a, dst_b],
)
stream.sync()
Programmatic Dependent Launch qua LaunchConfig
Trên GPU compute capability 9.0 trở lên, PDL cho phép dependent kernel bắt đầu phần việc độc lập trước khi kernel trước đó trong cùng stream kết thúc, rút ngắn khoảng trống giữa các kernel liên tiếp, ví dụ các lớp trong pipeline suy luận LLM. Kernel cần triển khai PDL synchronization protocol.
# Trước đây: dependent kernel chờ kernel trước hoàn tất
config = LaunchConfig(grid=num_blocks, block=256)
from cuda.core import LaunchConfig, launch
config = LaunchConfig(
grid=num_blocks,
block=256,
programmatic_stream_serialization=True,
)
# The kernel must implement the PDL synchronization protocol.
launch(stream, config, dependent_kernel, *kernel_args)Cập nhật CUDA Graph không cần re-instantiate
Node trong graph definition có thể cập nhật trước khi instantiate; node của executable graph được sửa qua view graph[node] mà không phải instantiate lại. Hỗ trợ kernel parameter, memcpy, memset, child graph, event và host callback.
from cuda.core import LaunchConfig, GraphDefinition

graph_def = GraphDefinition()
node = graph_def.launch(LaunchConfig(grid=1, block=256), kernel, output_a)

graph = graph_def.instantiate()
graph.launch(stream)
stream.sync()

# Update kernel argument in the executable graph
graph[node].update(args=(output_b,))
graph.launch(stream)
stream.sync()
CCCL 3.5
CCCL 3.5 mở rộng mô hình execution environment (cuda::std::execution::env): stream, yêu cầu determinism và tuning policy được truyền qua một đối tượng env thay vì qua tham số riêng lẻ. API CUB truyền thống vẫn được giữ nguyên.
Deterministic floating-point scan
cub::DeviceScan hỗ trợ yêu cầu run-to-run determinism, bảo đảm kết quả lặp lại trên cùng GPU, cùng input và cùng build.
API CUB truyền thống (two-phase temp storage, không có cơ chế yêu cầu determinism):
size_t temp_bytes = 0;
cub::DeviceScan::InclusiveSum(nullptr, temp_bytes, d_input, d_output, num_items, stream);
cudaMalloc(&d_temp, temp_bytes);
cub::DeviceScan::InclusiveSum(d_temp, temp_bytes, d_input, d_output, num_items, stream);
CCCL 3.5:
auto env = cuda::std::execution::env{
    cuda::stream_ref{stream},
    cuda::execution::require(
        cuda::execution::determinism::run_to_run)
};

auto status = cub::DeviceScan::InclusiveSum(
    d_input, d_output, num_items, env);
Public tuning API cho CUB
Trước đây tuning policy của CUB là chi tiết nội bộ. CCCL 3.5 công khai các tham số threads per block, items per thread, vectorization và lựa chọn thuật toán qua cuda::execution::tune(...). Policy selector trả về cub::ReducePolicy hoặc cub::ScanPolicy theo cuda::compute_capability. Ví dụ của NVIDIA dùng 256 threads per block, 20 items per thread trên CC 10.0+ (16 với CC thấp hơn), vec_size = 4, cub::BLOCK_REDUCE_WARP_REDUCTIONS và cub::LOAD_LDG:
auto env = cuda::std::execution::env{
    cuda::stream_ref{stream},
    cuda::execution::tune(ReduceTuning{})
};

cub::DeviceReduce::Sum(d_input, d_output, num_items, env);
Batched Top-K
cub::DeviceBatchedTopK chọn K phần tử nhỏ nhất hoặc lớn nhất độc lập trên nhiều segment, hỗ trợ key và key-value pair, segment size và K thay đổi theo từng segment. Ứng dụng: token selection trong quá trình decode và sparse attention; đã tích hợp vào FlashInfer.
constexpr int segment_size = 4;
constexpr int k = 2;

// segments_in / segments_out: strided iterators over d_input / d_output
cub::DeviceBatchedTopK::MaxKeys(
    segments_in, segments_out,
    cuda::args::constant<segment_size>{},
    cuda::args::constant<k>{},
    num_segments, env);
Data-dependent reduction
cuda::args::deferred cho phép reduction đọc số phần tử trực tiếp từ device memory theo stream order, không cần host transfer. CUDA Graph đã capture có thể xử lý element count khác nhau ở mỗi lần replay mà không phải capture lại.
Thư viện toán học: cuBLAS, cuSPARSE, nvJPEG
Các cải tiến hiệu năng dưới đây có hiệu lực sau khi cập nhật Toolkit, không yêu cầu thay đổi mã gọi thư viện.
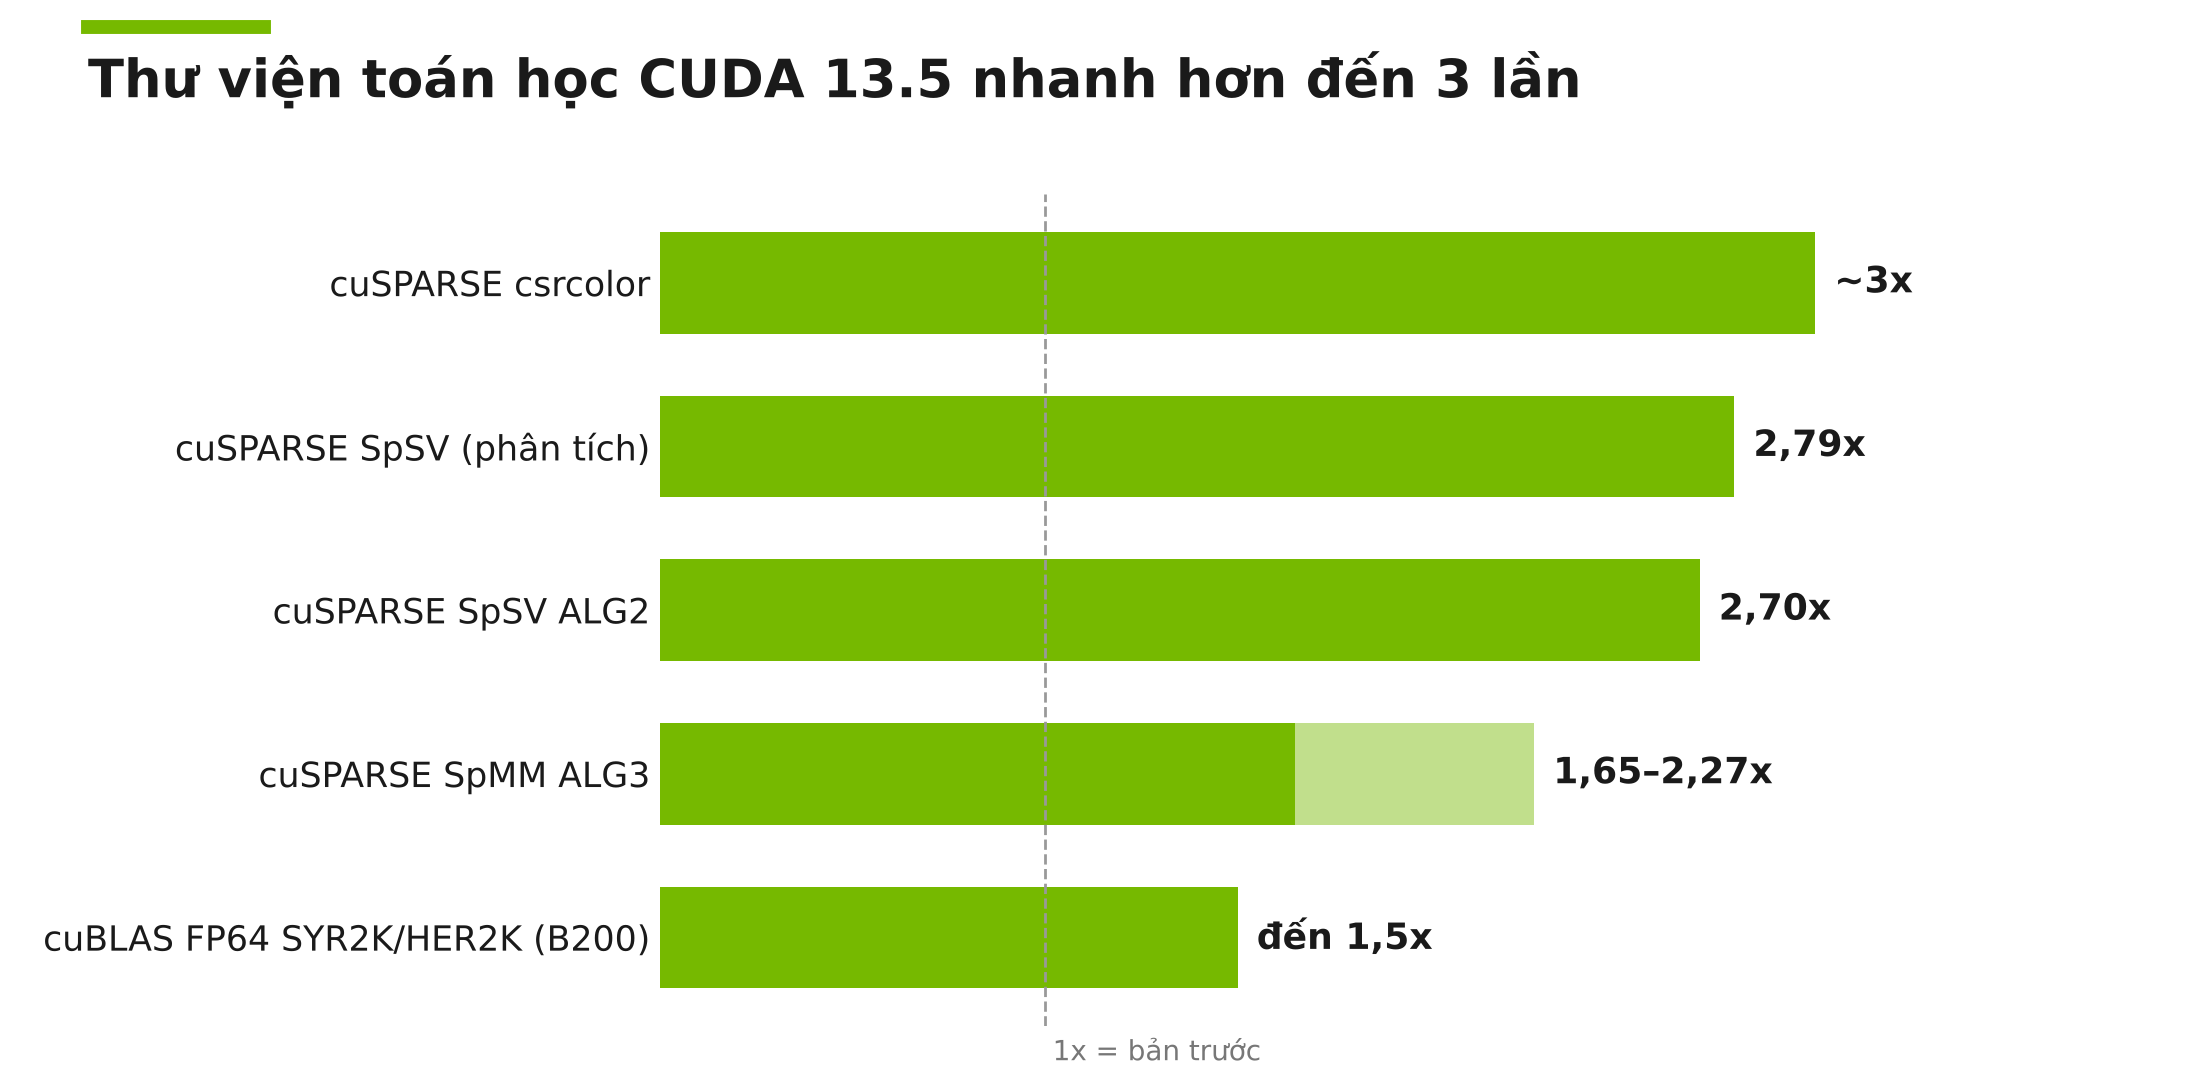
Mức tăng tốc của thư viện toán học trong CUDA 13.5
cuBLAS
- Vera Rubin GEMM: heuristic và kernel tuning mới cho matmul NVFP4 và MXFP8, bao gồm shape huấn luyện MoE, không cần per-shape autotuning.
- Ozaki-II cho FP64 symmetric rank-k update: hỗ trợ {D,Z}SYR{K,2K,KX} và ZHER{K,2K,KX} từ Ampere, đưa Tensor Core vào Cholesky factorization và least-squares solver trên cuSOLVER.
- Native FP64 symmetric update trên Blackwell: SYR2K, HER2K, SYRKX, HERKX nhanh hơn đến 1,5x trên B200 ở double và double-complex.
- BF16 unaligned shape: matmul BF16 có chiều không chia hết cho 8 dùng chung kernel tối ưu với FP16 trên Hopper trở lên, loại bỏ chênh lệch hiệu năng giữa hai định dạng.
- Windows on Arm: functional support cho GPU Blackwell, bao gồm workstation GB300.
cuSPARSE
| TÍNH NĂNG | THAY ĐỔI |
|---|---|
| CSR SpMM ALG3 | 1,65–2,27x ở FP32 và FP64 trên GPU data center |
| SpSV ALG2 (mới) | Solve nhanh hơn ALG1 2,7x (geometric mean) |
| SpSV analysis | Nhanh hơn 2,79x (geometric mean), giảm memory footprint |
| Mixed index | Offset 64-bit + index 32-bit cho SpMV (CSR, SELL), SpMM (CSR), SpSV (SELL), sparse/dense conversion |
| Mixed-precision CSR SpMV | Giá trị FP16/BF16, vector và compute FP32 trong cusparseSpMV |
cusparseSpMVGeneric (experimental) |
SpMV cho ma trận đối xứng chỉ lưu một tam giác |
cusparseSpMatConvert (experimental) |
Chuyển đổi CSR ↔ CSC |
csrcolor |
Graph coloring nhanh hơn khoảng 3x (geometric mean) |
nvJPEG
Throughput của NVJPEG_BACKEND_GPU_HYBRID tăng 10–600% tùy kích thước ảnh và việc sử dụng Huffman table chuẩn. Cơ chế tự chọn backend của nvjpegDecode trước đây chỉ xét NVJPEG_BACKEND_HYBRID và NVJPEG_BACKEND_HARDWARE; từ 13.5 xét thêm NVJPEG_BACKEND_GPU_HYBRID.
Công cụ phát triển và trình biên dịch
Developer tools
| CÔNG CỤ | CẬP NHẬT |
|---|---|
| Nsight Perf SDK for AI (public preview) | Always-on profiling cho workload training và inference chạy dài; lưu GPU/CPU metric và execution context để phân tích sự cố gián đoạn; xem trên Perfetto |
| Nsight Compute 2026.4 | Timeline page với time-resolved metric, làm lộ workload phase, transient stall và utilization shift mà aggregate metric không thể hiện |
| CUDA-GDB | Dừng thực thi theo CUDA Driver log event, lọc theo thread, severity hoặc message pattern |
| GPU core dump | Hỗ trợ capture khi CUPTI tracing đang bật |
| Compute Sanitizer agent skill | Hỗ trợ AI coding agent lựa chọn diagnostic và diễn giải lỗi memory, race condition, synchronization |
| Nsight Cloud | OpenTelemetry trace integration và profiling configuration cho NVIDIA Dynamo qua Nsight Operator |
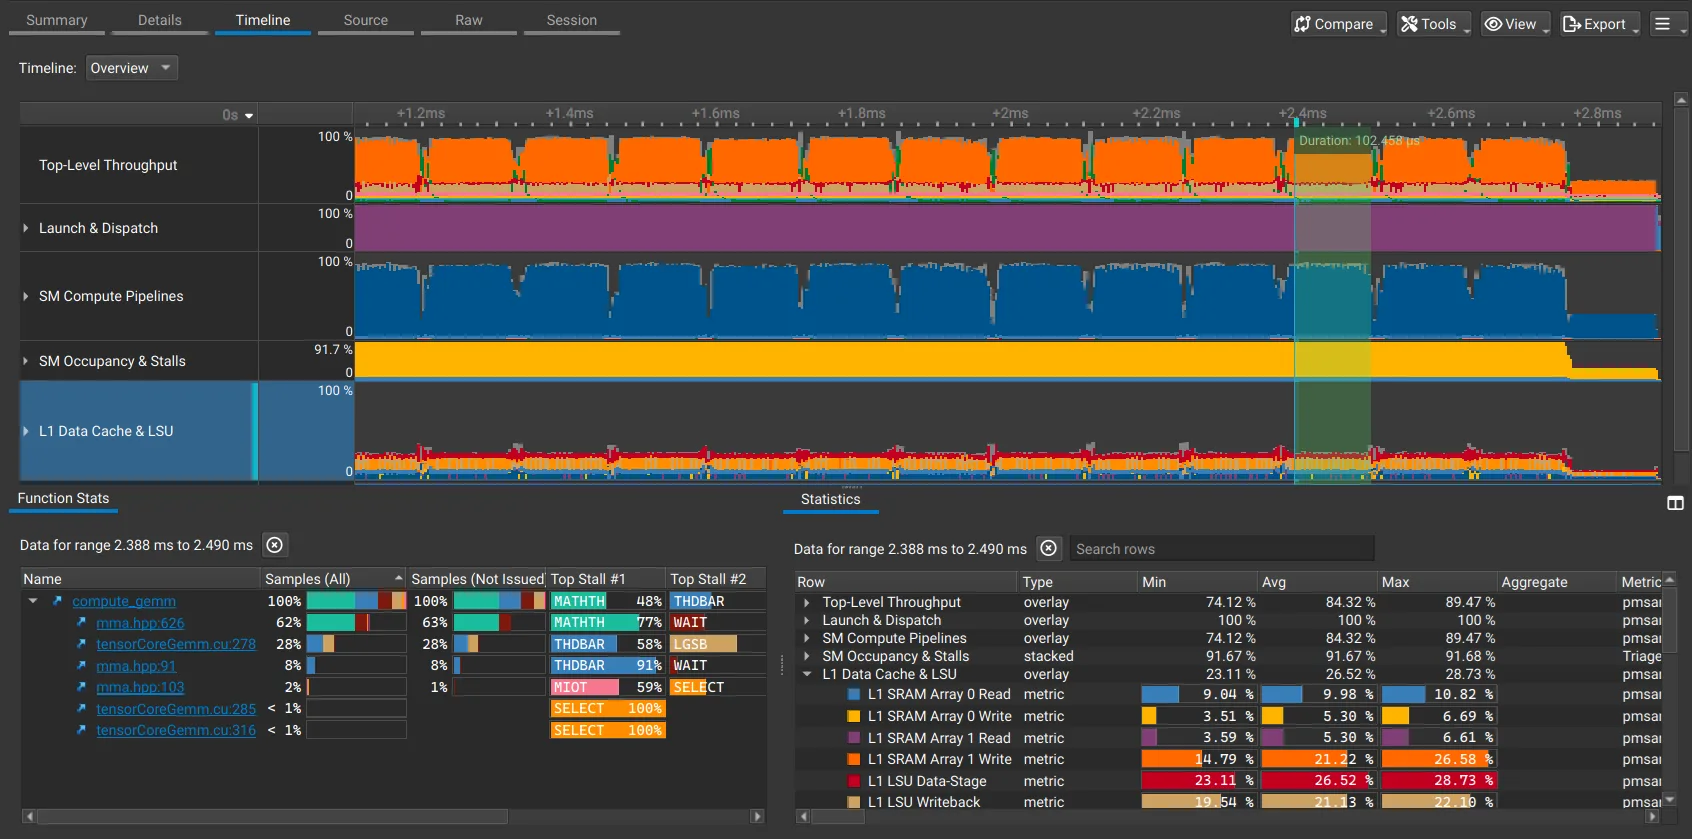
Hình 2. Nsight Compute Timeline page kèm function statistics.
Compilers
| TÍNH NĂNG | TRƯỚC CUDA 13.5 | CUDA 13.5 |
|---|---|---|
nvprune --precompile |
Fat binary chứa PTX chịu JIT overhead khi chạy | Compile PTX và TileIR sang SASS/ELF ngay ở bước prune |
| TMA out-of-bounds addressing | Cần workaround tốn kém để tránh illegal-address với ragged tile | tensormap.replace thay đổi OOB mode trong kernel |
| Cycle-based trigonometry | — | __sin2pif, __cos2pif, __sincos2pif và biến thể PTX .2pi |
| CompileIQ ACF | — | Mở rộng sang PTX Compiler và NVVM library |
cuobjdump symbol |
Trường hex thô | Cột Type, Bind, Vis, Other; giá trị lạ hiển thị UNKNOWN(0xNN) |
cuobjdump --dump-elf-symbols application.cubinKhuyến nghị triển khai theo workload
| WORKLOAD | THÀNH PHẦN LIÊN QUAN | LỢI ÍCH KỸ THUẬT |
|---|---|---|
| Hạ tầng Vera Rubin production | Vera Rubin GA, cuBLAS NVFP4/MXFP8 | Ngăn xếp phần mềm được hỗ trợ chính thức, GEMM tối ưu sẵn cho MoE |
| GPU cluster multi-tenant, Kubernetes | MPS v3 (cgroup routing, per-namespace partition, SM lending), locality domain | Tăng SM utilization, cô lập tài nguyên giữa các tenant |
| LLM inference | cub::DeviceBatchedTopK, PDL, CUDA Graph update, batched copy |
Giảm kernel launch gap và độ trễ decode |
| Distributed training | CUDA Tile multi-GPU, Nsight Perf SDK for AI | Fuse communication và computation, profiling liên tục trên job chạy dài |
| HPC, CAE, mô phỏng | cuSPARSE ALG3/ALG2, Ozaki-II FP64, deterministic scan | Giảm thời gian solve, kết quả tái lập |
| Vision AI | nvJPEG GPU Hybrid | Tăng throughput giải mã ảnh |
| Phân phối phần mềm, cloud | nvprune --precompile |
Loại bỏ JIT overhead trên kiến trúc đích đã biết |
Lưu ý tương thích
- Windows trên Rubin: TCC không được hỗ trợ; chuyển cấu hình sang WDDM hoặc MCDM.
cuobjdump: script parse output--dump-elf/--dump-elf-symbolscần cập nhật theo định dạng cột mới.nvprune --precompile: target phải khớp môi trường triển khai; validate trên từng kiến trúc đích.- MPS polling-based accounting: phát sinh overhead trên mỗi quyết định eviction; chỉ bật khi cgroup notification không tin cậy.
- Public preview: Tile-to-SIMT interoperability và Nsight Perf SDK for AI nên được đánh giá trên môi trường staging trước khi đưa vào production.
Đội ngũ kỹ thuật Nhất Tiến Chung hỗ trợ kiểm tra tương thích, benchmark trên hạ tầng thực tế và xây dựng lộ trình nâng cấp CUDA cho doanh nghiệp.
Lời kết
CUDA 13.5 hoàn thiện nền tảng phần mềm cho thế hệ Vera Rubin, đồng thời nâng cấp khả năng vận hành multi-tenant với MPS v3, mở rộng CUDA Tile sang giao tiếp đa GPU và cải thiện hiệu năng thư viện mà không yêu cầu thay đổi mã nguồn. CUDA Toolkit 13.5 hiện có trên trang CUDA Downloads của NVIDIA, kèm release notes đầy đủ về tính năng, nền tảng hỗ trợ và tương thích.
Hãy liên hệ đội ngũ chuyên gia của Nhất Tiến Chung. Với vai trò NVIDIA Elite Partner tại Việt Nam, chúng tôi đồng hành cùng doanh nghiệp trong đánh giá lộ trình nâng cấp CUDA, cấu hình MPS và chia sẻ GPU cho cụm multi-tenant, tư vấn hạ tầng DGX, RTX PRO và Vera Rubin, từ giai đoạn thử nghiệm đến vận hành production.
Tổng đài: 1900 558879 · Email: sales@nhattienchung.vn
Nguồn
- NVIDIA CUDA 13.5 Brings NVIDIA Vera Rubin GA Support — NVIDIA Technical Blog, Jonathan Bentz, 04/11/2026
- CUDA Toolkit Downloads — NVIDIA
Bài viết liên quan
- NVIDIA RTX Spark hỗ trợ Render thần kinh và nhân vật AI trong game
- Xây dựng mô hình thế giới cho mô phỏng tương tác với NVIDIA Cosmos
- NVIDIA Nemotron 3.5 Super VL: xây dựng agent chuyên biệt với suy luận đa phương thức
- RTX Spark sau 30 ngày: hiệu năng thực chiến và kịch bản triển khai AI cục bộ
- NVIDIA mở thiết kế Vera Rubin tại OCP 2026: Những điểm cần biết