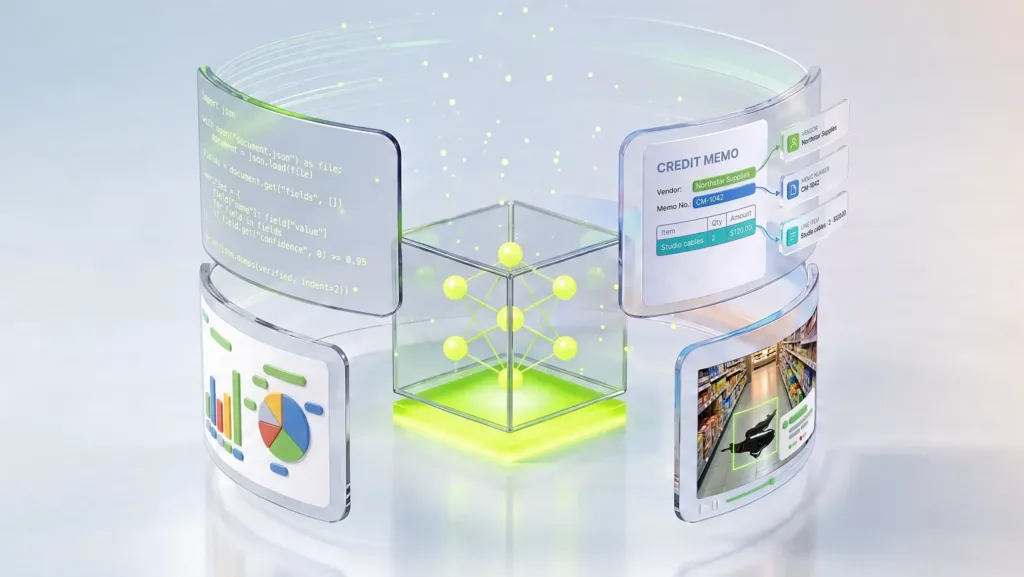
Các agent luôn hoạt động (always-on agent) đang gánh vác những quy trình nghiệp vụ ngày càng dài và phức tạp hơn. Chỉ một yêu cầu thôi cũng có thể đòi hỏi agent phải đọc tài liệu, đối chiếu thông tin từ nhiều nguồn, tuân thủ chính sách của công ty và gọi đến nhiều công cụ khác nhau.
NVIDIA Nemotron 3.5 Super VL là một mô hình đa phương thức mã nguồn mở, có thể tùy chỉnh cho chính những quy trình chuyên biệt như vậy. Mô hình dùng kiến trúc mixture-of-experts (MoE) với 120 tỷ tham số, nhưng chỉ kích hoạt 12 tỷ tham số cho mỗi token, nhờ đó cân bằng được giữa năng lực và hiệu quả suy luận.
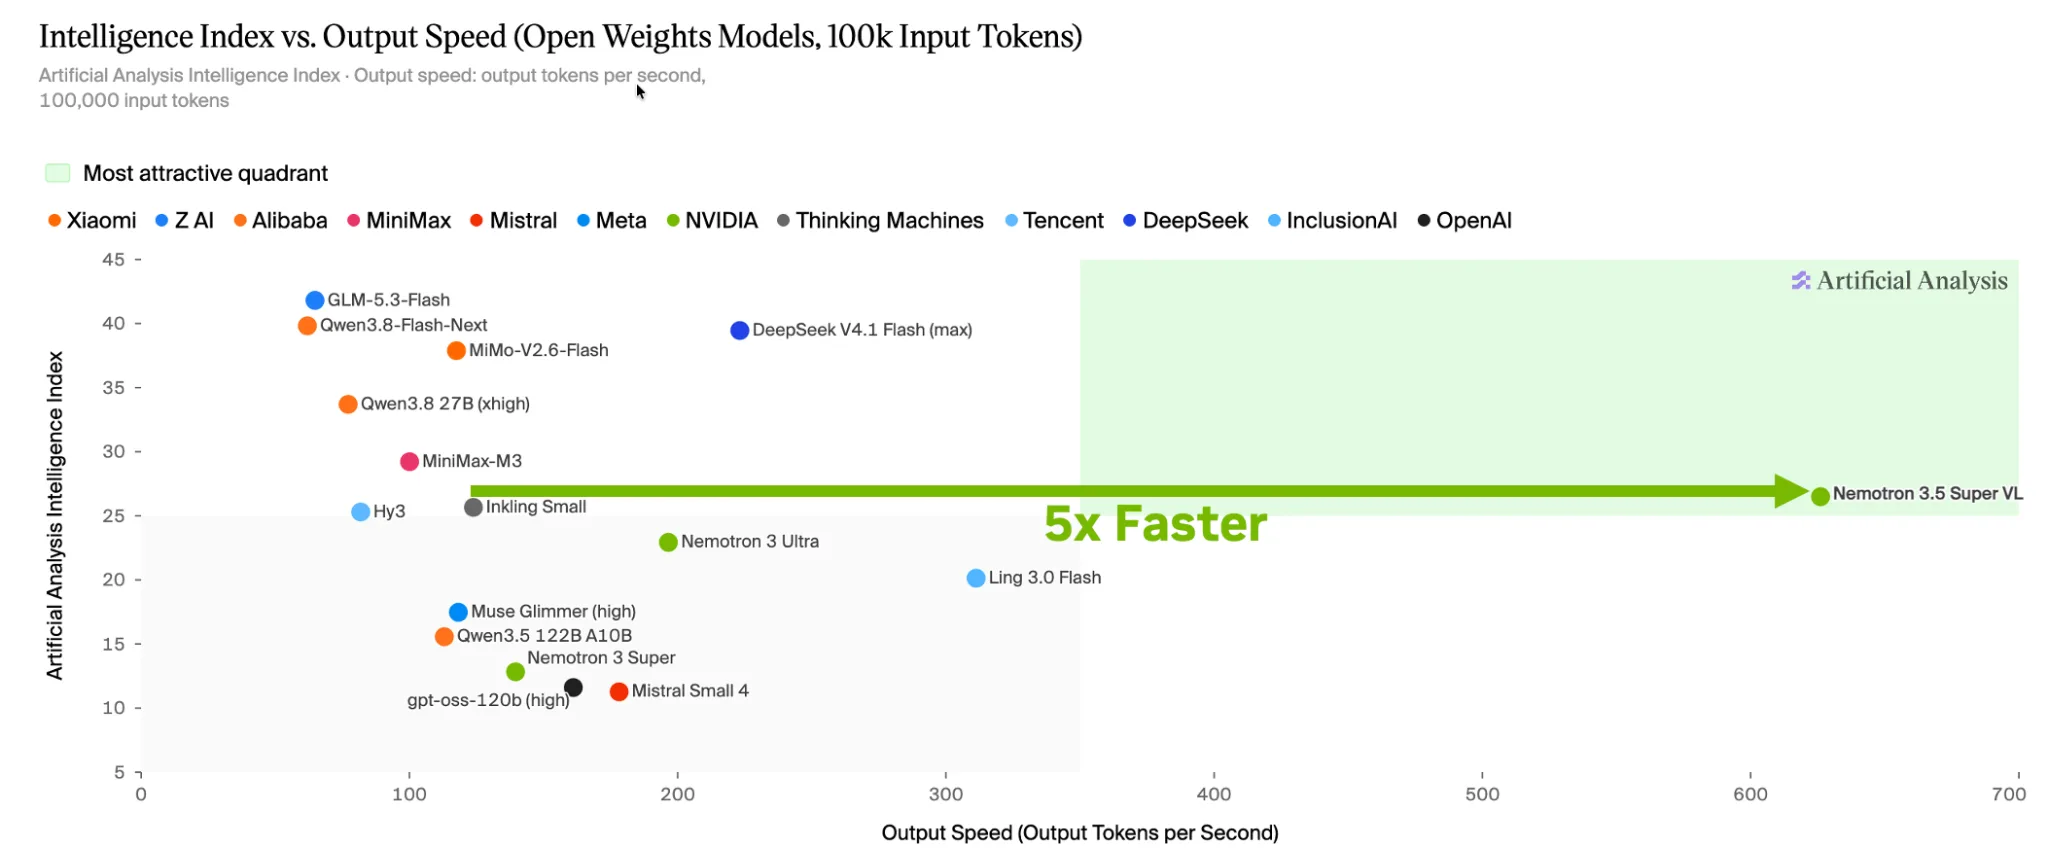
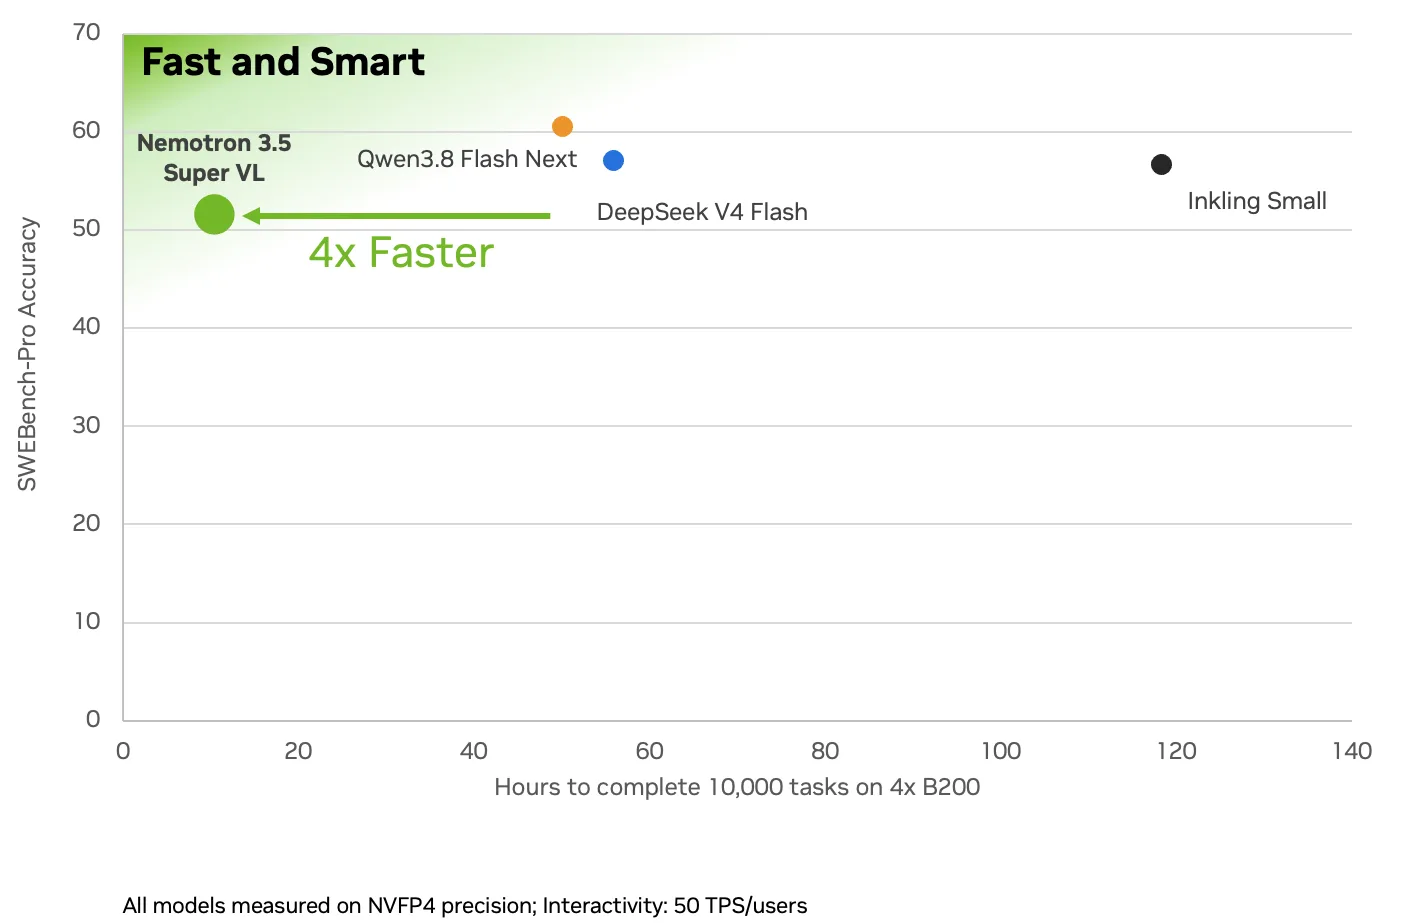
Trên một GPU duy nhất, mô hình đạt thông lượng cao gấp tới 5 lần ở các tác vụ agent so với các mô hình mở khác cùng phân khúc kích thước.
Mô hình gộp chung khả năng suy luận, làm theo chỉ dẫn và sử dụng công cụ với khả năng hiểu văn bản, hình ảnh, tài liệu và video. Nhờ tất cả nằm trong một mô hình duy nhất, các nhóm phát triển có thể xử lý cả tác vụ văn bản lẫn tác vụ thị giác mà không phải triển khai riêng một mô hình ngôn ngữ và một mô hình thị giác-ngôn ngữ, cũng không phải chuyển ngữ cảnh tác vụ qua lại giữa chúng.
Nhà phát triển có thể hậu huấn luyện (post-train) Nemotron 3.5 Super VL bằng NVIDIA NeMo trên dữ liệu, công cụ, chính sách và quy trình làm việc của riêng mình. Bài viết này hướng dẫn cách tận dụng nền tảng đó để xây dựng agent doanh nghiệp chuyên biệt, đồng thời mô tả các kỹ thuật huấn luyện và suy luận đứng sau nó.
Vì sao chọn Nemotron 3.5 Super VL cho các agent chuyên biệt?
Agent cần hiểu cả nhiệm vụ lẫn môi trường mà nó hoạt động. Một agent chăm sóc khách hàng phải nắm chính sách đổi trả của công ty. Agent nghiên cứu phải nối được các bằng chứng rải rác ở nhiều nguồn, còn agent xử lý tài liệu phải đọc hiểu được bảng biểu, biểu đồ và bố cục trang.
Nemotron 3.5 Super VL kết hợp suy luận với hiểu thị giác trong nhiều quy trình agent, chẳng hạn:
- Lập trình: Kiểm thử và xác thực mã, phân tích lỗi và đề xuất cách sửa.
- Nghiên cứu trên web: Tìm kiếm qua nhiều trang, liên kết thông tin và kiểm chứng câu trả lời.
- Trí tuệ tài liệu: Trích xuất thông tin từ bảng biểu, biểu đồ và bố cục trang để tạo bản tóm tắt và báo cáo.
- An ninh mạng: Phát hiện lỗ hổng và phân loại mối đe dọa để ưu tiên khắc phục.
- Hiểu video: Trích xuất thông tin phục vụ tìm kiếm, kiểm duyệt nội dung và phân tích sự cố.
Trong một hệ thống gồm nhiều mô hình, Nemotron 3.5 Super VL đảm nhận những công việc chuyên sâu, nhiều bước, đòi hỏi suy luận, dùng công cụ và hiểu đồng thời cả văn bản lẫn hình ảnh. Các mô hình nhỏ hơn như NVIDIA Nemotron 3.5 Lightning lo các tác vụ văn bản khối lượng lớn, còn những mô hình tiên phong như NVIDIA Nemotron 3 Ultra giải quyết các bài toán lập kế hoạch và điều phối phức tạp.
Tùy chỉnh Nemotron 3.5 Super VL theo dữ liệu, công cụ và chính sách của từng lĩnh vực
Agent chuyên biệt phải học cách một tổ chức vận hành. Thuật ngữ ngành, giao diện công cụ, quy trình tác nghiệp và các yêu cầu về chính sách quyết định agent có hoàn thành nhiệm vụ được hay không.
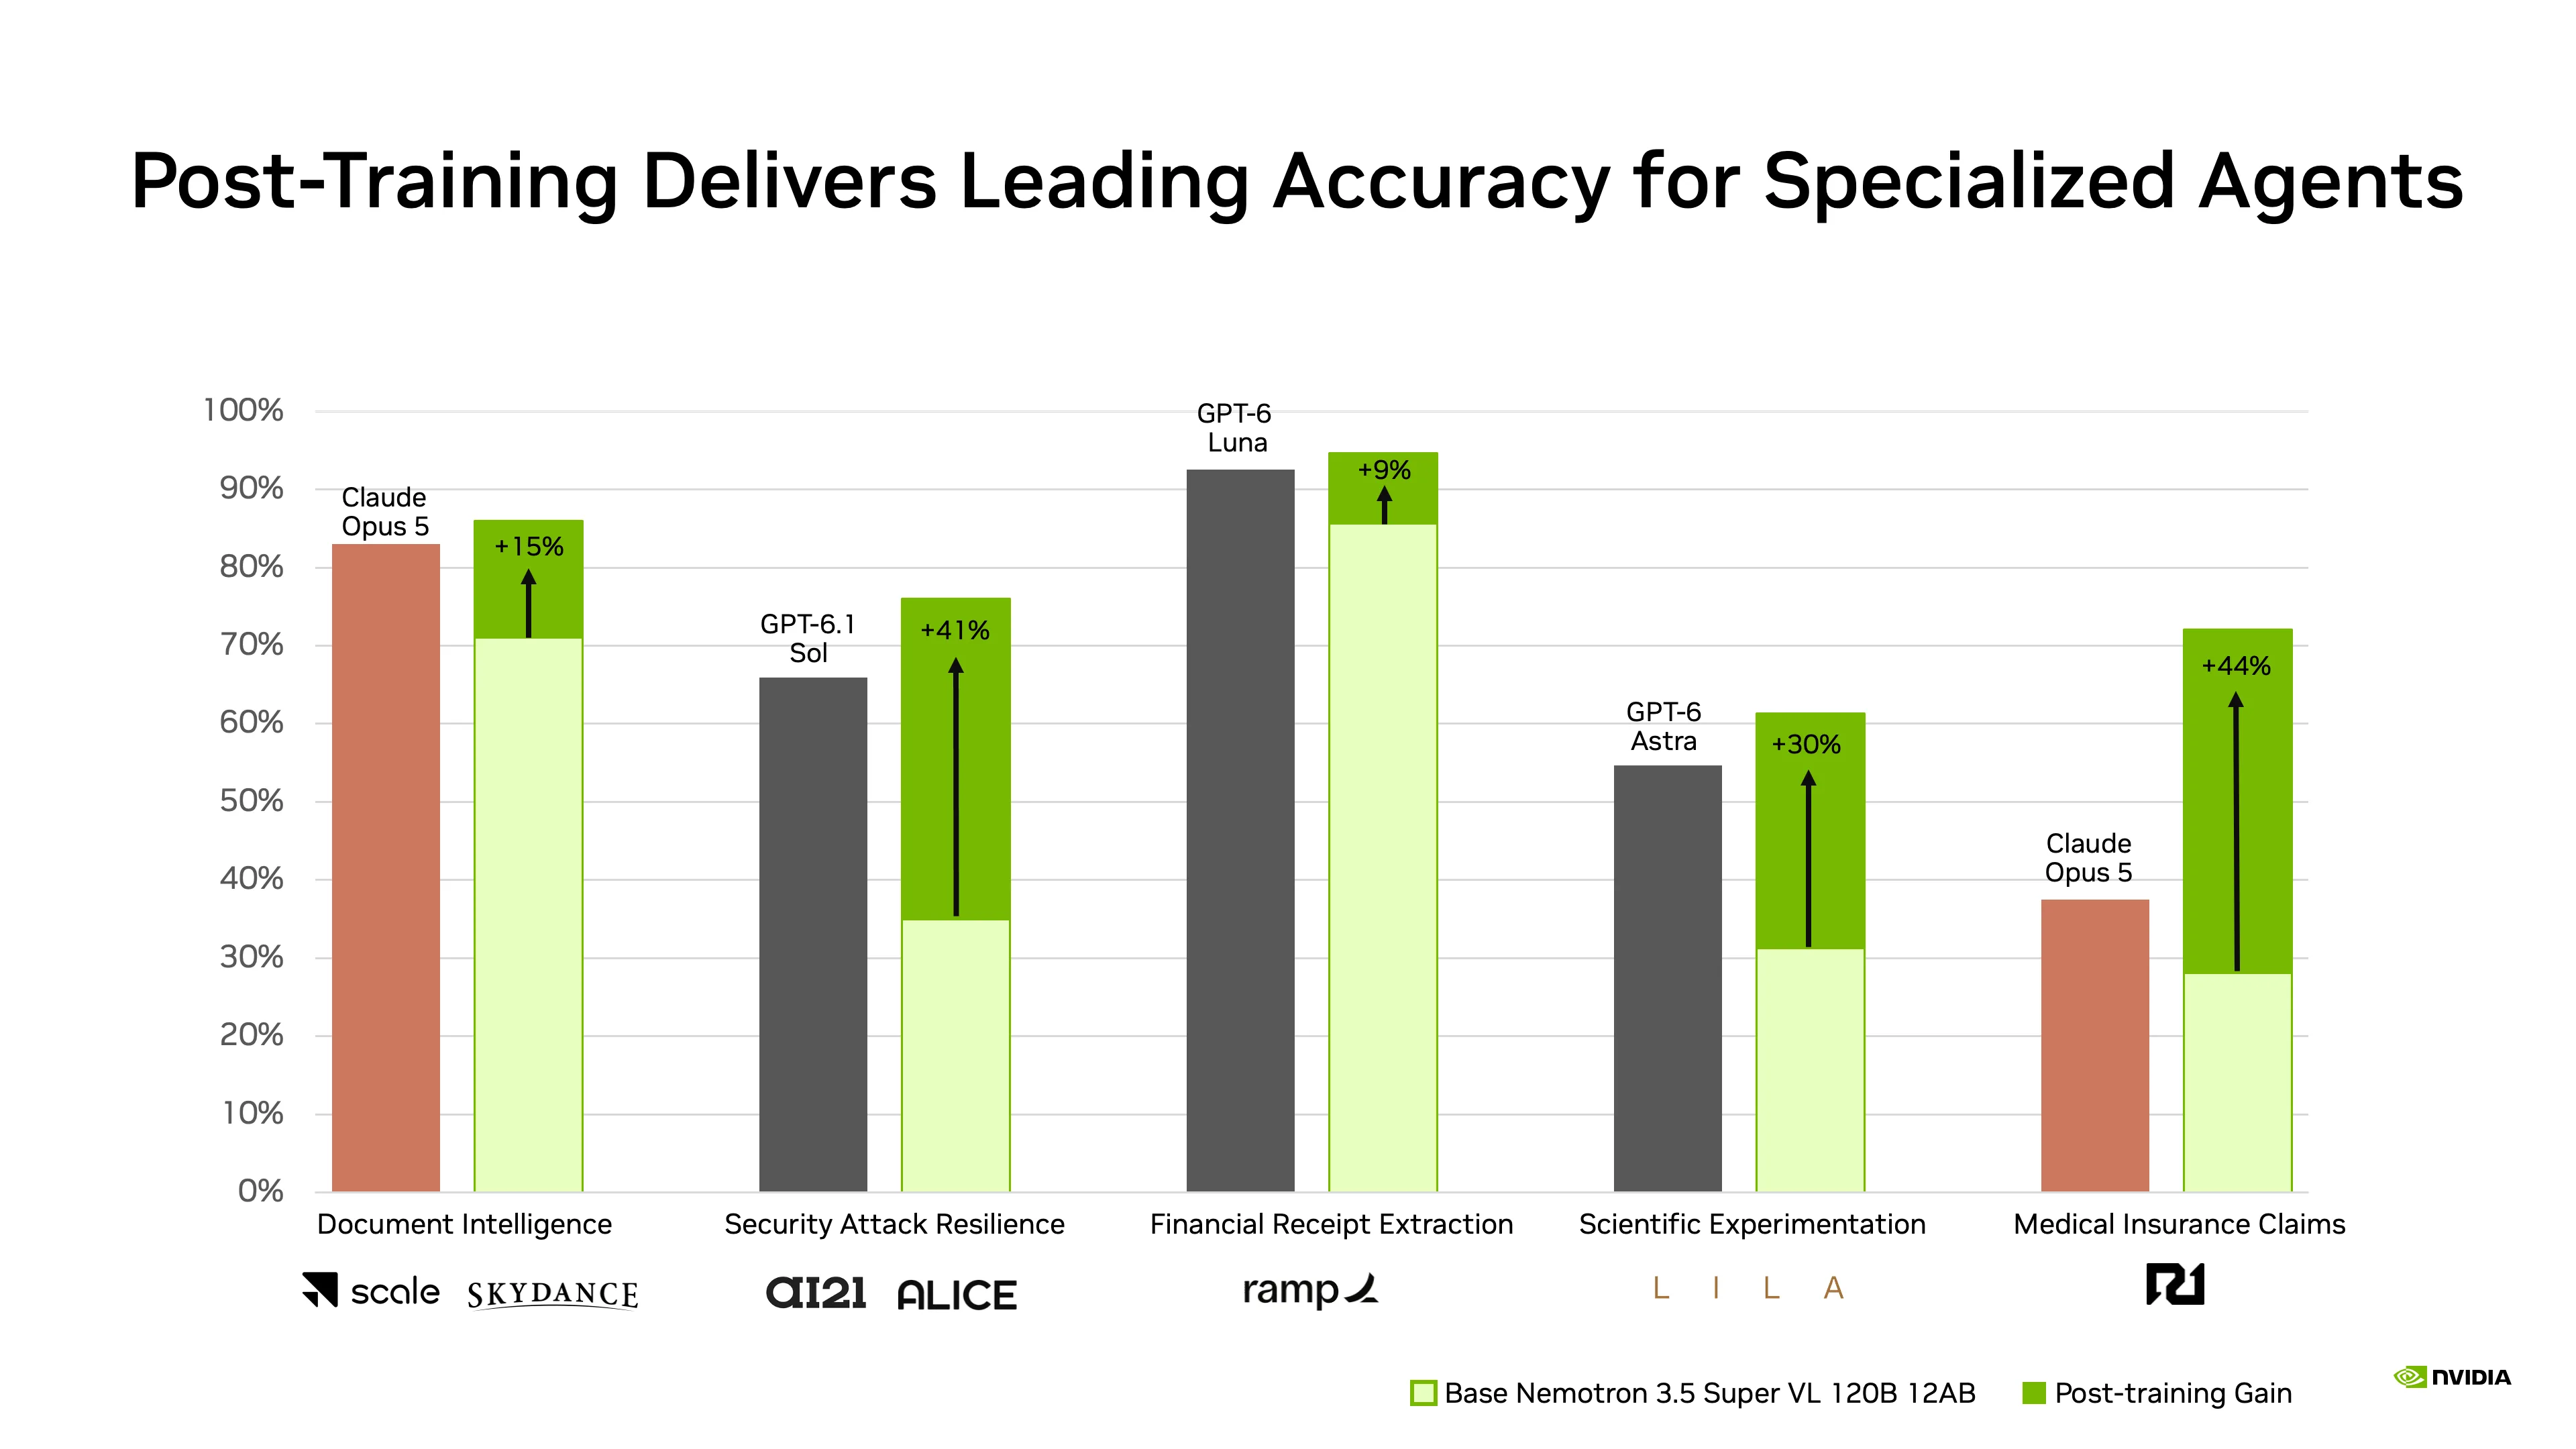
Các tổ chức trong nhiều ngành, từ an ninh mạng, tài chính đến y tế, đang hậu huấn luyện Nemotron 3.5 Super VL để vượt các mô hình tiên phong về cả độ chính xác lẫn hiệu quả trong quy trình sản xuất của họ. Một vài ví dụ:
- Scale AI, nhà cung cấp dữ liệu và công nghệ AI, đã hậu huấn luyện Nemotron 3.5 Super VL để tự động hóa xử lý tín dụng nhà cung cấp cho Skydance Corporation, một công ty truyền thông và giải trí. Chi phí suy luận cho tác vụ này dự kiến giảm 40 lần và độ trễ giảm 5 lần.
- Ramp, nhà cung cấp nền tảng vận hành tài chính, đang dùng mô hình để chuyển ảnh hóa đơn thành JSON có cấu trúc gồm thông tin đơn vị bán, ngày tháng và dữ liệu thanh toán. Ramp kỳ vọng thông lượng cao hơn tới 50% và độ trễ thấp hơn 10 lần.
- AI21 và Alice đã hậu huấn luyện Nemotron 3.5 Super VL cho tình báo mối đe dọa và phân tích lỗ hổng, cải thiện độ chính xác 41%.
Các nhóm có thể dùng bộ thư viện mã nguồn mở NVIDIA NeMo để hậu huấn luyện mô hình theo những yêu cầu này. NVIDIA NeMo AutoModel hỗ trợ tinh chỉnh có giám sát (SFT) và thích ứng hạng thấp (LoRA) để dạy mô hình các hành vi đặc thù theo lĩnh vực. Học tăng cường (RL) giúp nâng hiệu năng trong các môi trường agent mô phỏng đúng quy trình của tổ chức.
Cùng với việc ra mắt Nemotron 3.5 Super VL, NVIDIA phát hành các bộ dữ liệu mở trên Hugging Face. Chúng gồm dữ liệu sử dụng công cụ và hội thoại cho agent, bộ dữ liệu suy luận tài chính và gọi công cụ (tool-calling), dữ liệu làm theo chỉ dẫn và trò chuyện, dữ liệu chuyển đổi và dịch ngữ cảnh dài, dữ liệu về tính công bằng, cùng 40 bộ dữ liệu thị giác-ngôn ngữ. Những bộ dữ liệu này có thể bổ sung cho dữ liệu riêng của tổ chức trong SFT và RL.
Với dữ liệu đa phương thức, hãy bắt đầu từ các tài nguyên NeMo Data Designer về hỏi đáp trên biểu đồ và hiểu tài liệu dài. Tham khảo NVIDIA NeMo RL và NVIDIA NeMo Gym để huấn luyện bằng RL và đánh giá trong môi trường mô phỏng.
Tổ chức có thể tinh chỉnh và triển khai trọng số mở của mô hình tại chỗ (on-premises), trong trung tâm dữ liệu hoặc trên các đám mây được hỗ trợ, tùy theo yêu cầu về hạ tầng và dữ liệu. Tài nguyên tùy chỉnh có trong sổ tay hướng dẫn Nemotron 3.5 Super VL trên GitHub.
Kết hợp hiểu văn bản và hình ảnh trong cùng một quy trình
Nemotron 3.5 Super VL gộp khả năng hiểu văn bản, hình ảnh, tài liệu và video với suy luận và làm theo chỉ dẫn, để trả lời những câu hỏi trải rộng trên tất cả các loại đầu vào này.
Dữ liệu huấn luyện thị giác của mô hình bao gồm biểu đồ, bảng, nhận dạng ký tự quang học (OCR), tài liệu nhiều trang và video. Một quy trình SFT hai giai đoạn huấn luyện cả thành phần ngôn ngữ lẫn thị giác, kết hợp bằng chứng hình ảnh với dữ liệu suy luận, hội thoại, an toàn, ngữ cảnh dài và các quỹ đạo hành động của agent.
Trong bài toán trí tuệ tài liệu, cùng một mô hình có thể đọc một biểu đồ, liên hệ nó với một bảng ở chỗ khác trong tài liệu rồi tóm tắt cả hai. Nhà phát triển có thể tùy chỉnh quy trình theo loại tài liệu và tiêu chí đánh giá của riêng mình.
Dữ liệu huấn luyện đa dạng tạo bằng NeMo Data Designer giúp mô hình hiểu tốt hơn các biểu đồ phức tạp. Trên CharXiv, một benchmark về suy luận trên biểu đồ, mô hình đạt 80,8%, so với 63% của Nemotron 3 Nano Omni. Khi được giải thích thêm bằng mã Python, kết quả lên tới 84%. Phương pháp và bài học rút ra được trình bày trong bài phân tích chuyên sâu về hiểu biểu đồ và pipeline hỏi đáp biểu đồ mã nguồn mở.
Mô hình được xây dựng với sự hỗ trợ và chuyên môn của các tổ chức trong Nemotron Coalition. Chẳng hạn, các bộ dữ liệu chất lượng cao từ Perplexity giúp cải thiện và tinh gọn giai đoạn huấn luyện giữa (mid-training), còn các môi trường từ Prime Intellect giúp xây dựng những mô hình giáo viên (teacher model) tốt hơn.
Nemotron 3.5 Super VL cũng nằm trong nhóm mô hình mã nguồn mở dẫn đầu trên bảng xếp hạng OCRBench v2.
Độ chính xác và hiệu quả trong các tác vụ agent
Nemotron 3.5 Super VL được đánh giá trên Hermes, LangChain, OpenClaw, OpenCode, Pi, Codex và Claude. Ngoài các tác vụ lập trình, các nhà cung cấp framework agent còn dùng bộ đánh giá riêng của họ để kiểm tra nhiều loại tác vụ agent khác nhau. Trên Hermes Bench và bộ đánh giá hành vi của LangChain, Nemotron 3.5 Super VL đạt điểm cao hơn Nemotron 3 Ultra.
| Mô hình | Hermes Bench | LangChain Evals |
|---|---|---|
| Nemotron 3 Ultra | 56,33% | 84,3% |
| Nemotron 3.5 Super VL | 63,44% | 87,05% |
Với agent chạy liên tục, hiệu quả quyết định một hệ thống triển khai có thể hoàn thành bao nhiêu việc. Thông lượng, lượng token tiêu thụ, số lần gọi công cụ và số bước cần để ra được kết quả đúng đều ảnh hưởng đến thời gian hoàn thành tác vụ.
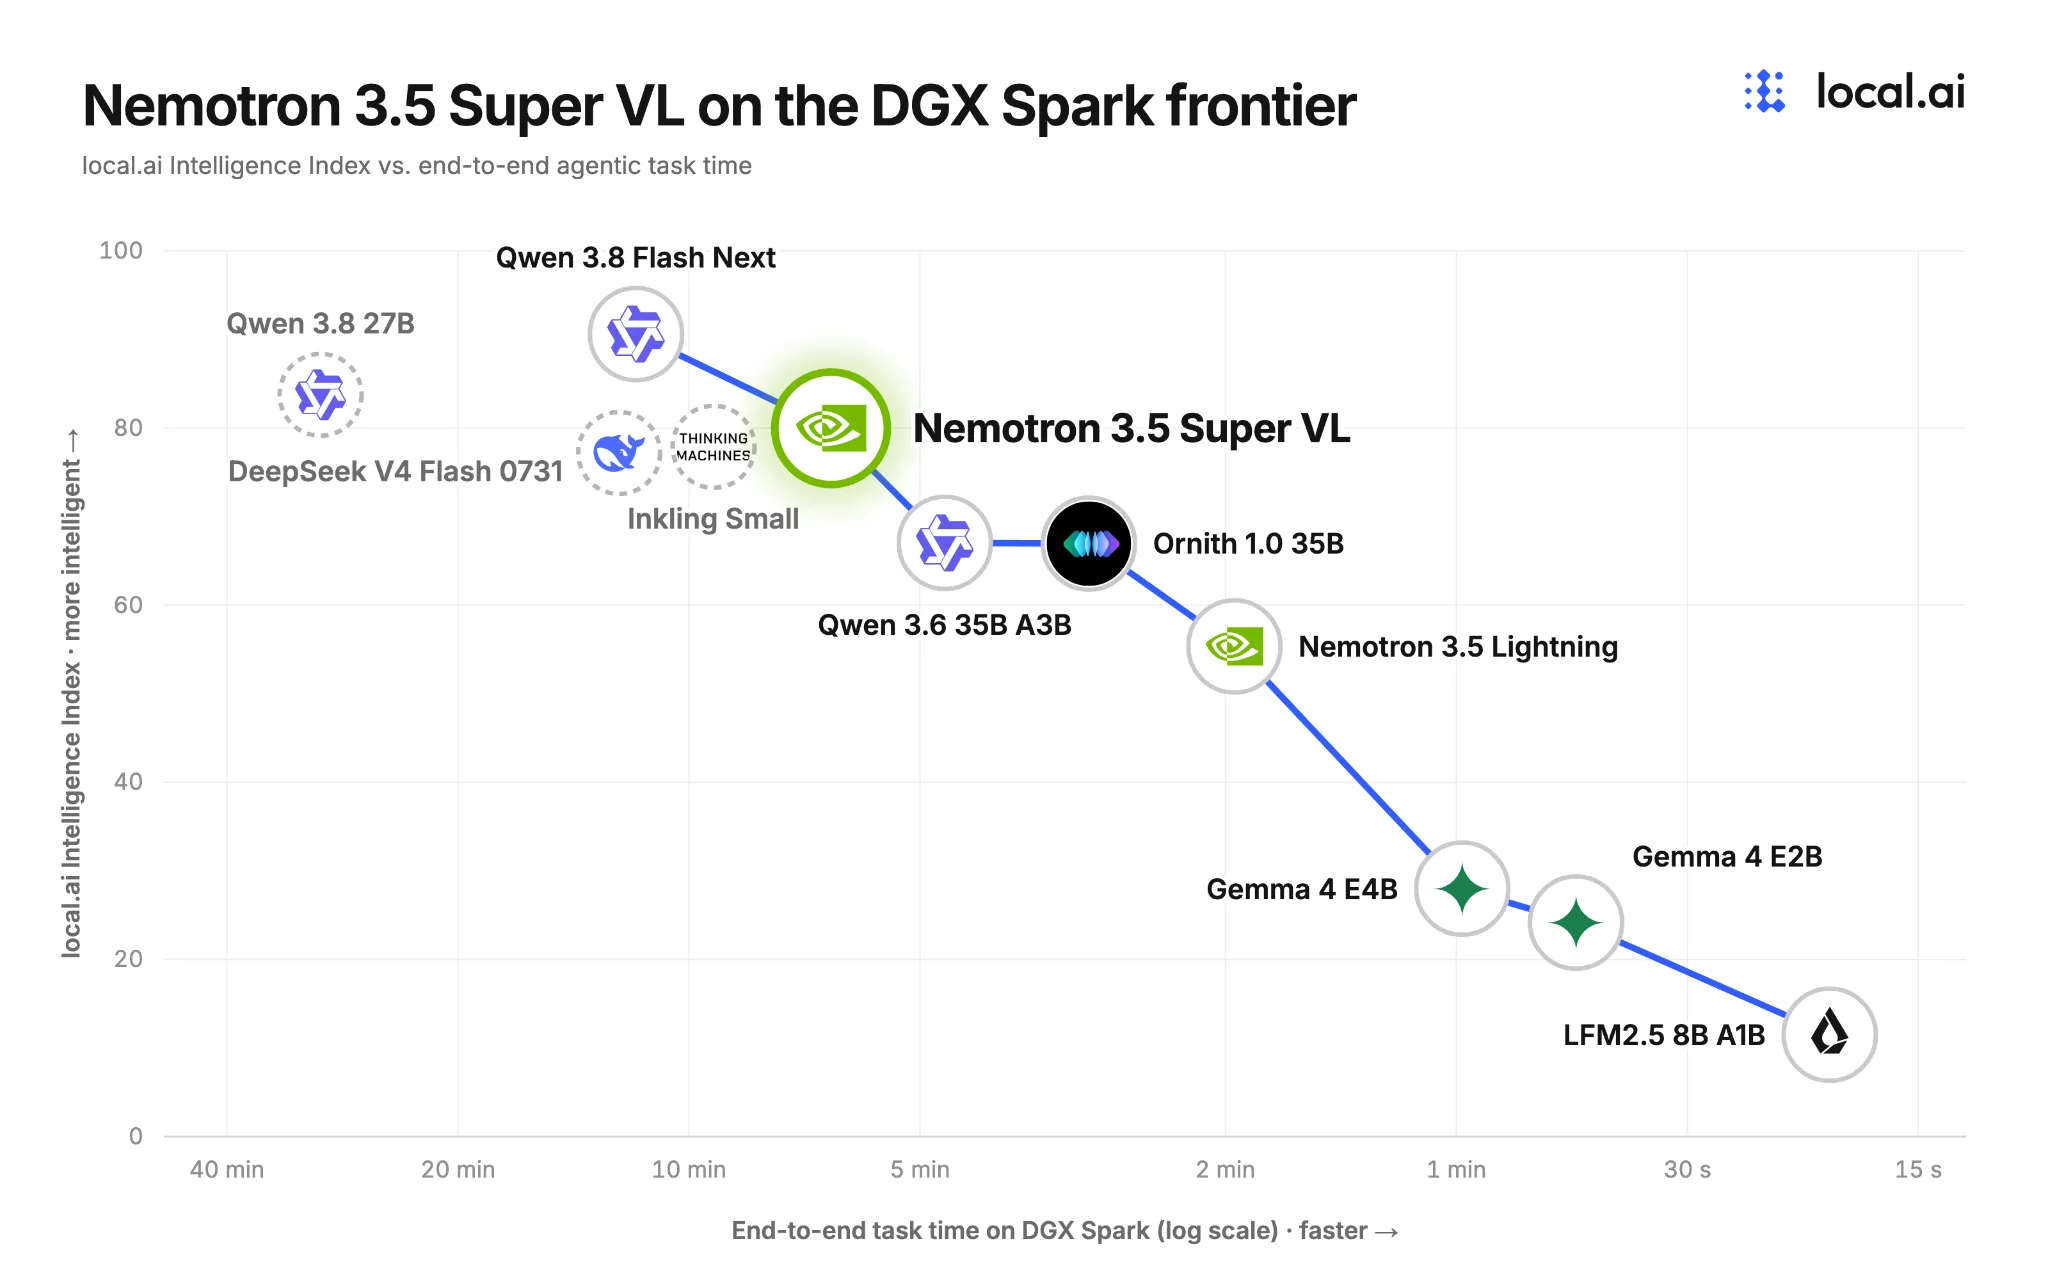
Mô hình cũng được tối ưu để chạy cục bộ trên NVIDIA DGX Spark. Một đánh giá độc lập của EXO Labs xếp Nemotron 3.5 Super VL vào biên Pareto về độ chính xác và thời gian hoàn thành tác vụ.
Bên trong Nemotron 3.5 Super VL
Mô hình được xây dựng trên một nền tảng vững chắc, kết hợp kiến trúc lai, giải mã suy đoán, tái sử dụng ngữ cảnh và độ chính xác hỗn hợp để giảm khối lượng tính toán suy luận qua những lần gọi agent lặp đi lặp lại.
Xây dựng mô hình nền vững chắc
Nemotron 3.5 Super VL được chưng cất từ Nemotron 3 Ultra. Năng lực lập trình của Ultra, cộng với hàm mất mát SkewReverse dùng trong quá trình chưng cất, giúp nâng độ chính xác ở các tác vụ lập trình.
Trong giai đoạn hậu huấn luyện, kỹ thuật chưng cất on-policy đa giáo viên (MOPD) kết hợp hướng dẫn từ các giáo viên chuyên biệt cho cả văn bản lẫn thị giác. Mô hình sinh ra câu trả lời, rồi các giáo viên chấm điểm chúng về suy luận, theo dõi video, dùng công cụ thị giác và mức độ phù hợp.
Việc huấn luyện bổ sung trên các ví dụ về hành động của agent, kho mã nguồn và tác vụ kỹ thuật phần mềm giúp mô hình làm tốt hơn trong các tác vụ agent. Nemotron 3.5 Super VL vượt Nemotron 3 Super trên SWE-bench và Terminal-Bench ở nhiều cấu hình đánh giá khác nhau.
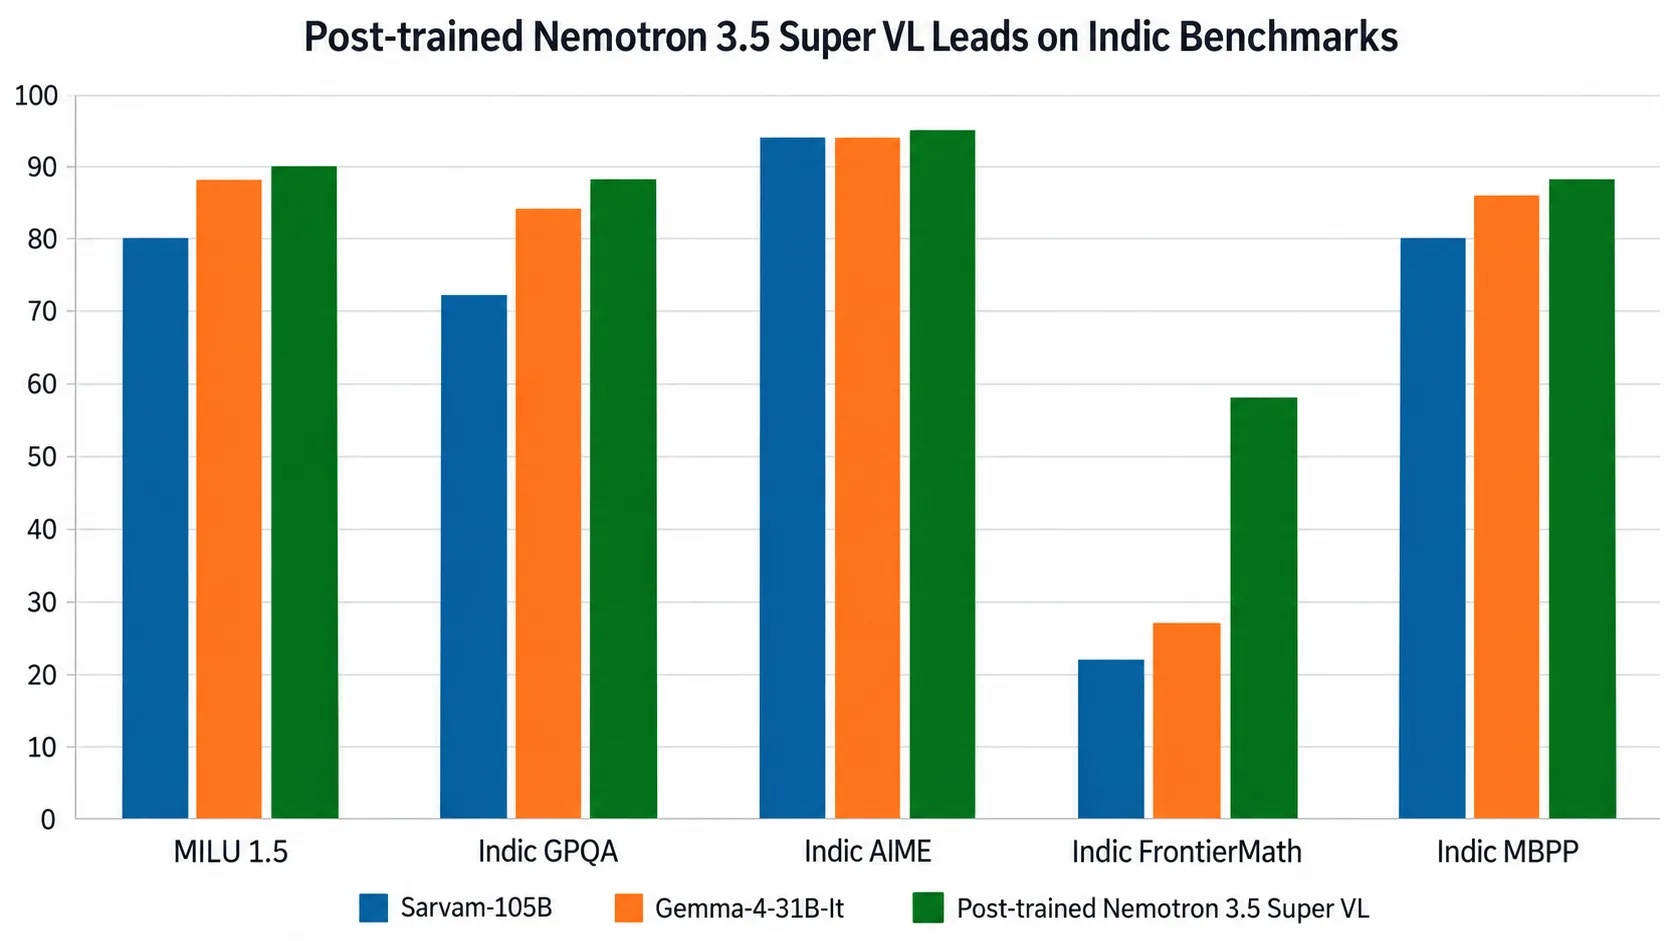
Giai đoạn tiền huấn luyện tiếp tục (continued pretraining) với dữ liệu tự nhiên và tổng hợp chất lượng cao giúp cải thiện khả năng tiếng Ấn Độ (Indic), đồng thời góp phần nâng điểm tổng thể sau hậu huấn luyện. Giai đoạn này bổ sung 10 tỷ token Indic, lấy từ một tập con 12 ngôn ngữ của Nemotron-pretraining-Indic-v1 và văn bản Indic tự nhiên.
NVIDIA đang phát hành trọn bộ dữ liệu này, khoảng 2,8 nghìn tỷ token thuộc 22 ngôn ngữ Ấn Độ, được phát triển cùng IIT Madras và phòng thí nghiệm AI4Bharat của trường. Kết quả dưới đây là của Nemotron 3.5 Super VL sau hậu huấn luyện.
Nhà phát triển có thể dùng NeMo để xây tiếp trên nền tảng này và tùy chỉnh Nemotron 3.5 Super VL cho ứng dụng của mình, điều chỉnh khả năng suy luận và agent theo dữ liệu, công cụ và quy trình riêng.
LiLiCorr: Kỹ thuật giải mã suy đoán mã nguồn mở
LiLiCorr cải thiện giải mã suy đoán song song bằng cách đánh giá đồng thời các token ứng viên trên toàn bộ bản nháp, qua đó nắm bắt được những phụ thuộc mà các dự đoán token độc lập bỏ sót. Một mạng nhẹ tính điểm tương thích trong một lượt chạy duy nhất để tạo ra bản nháp nhất quán hơn, chỉ để lại bước chọn cuối cùng chạy tuần tự với chi phí thấp.
Trên DGX Spark, LiLiCorr là bộ tạo bản nháp (drafter) được khuyến nghị cho suy luận độ trễ thấp với Nemotron 3.5 Super VL. Nó sinh token nhanh hơn tới 2,3 lần so với giải mã không dùng suy đoán.
NVFP4 và độ chính xác hỗn hợp
Mô hình dùng NVIDIA Model Optimizer để lượng tử hóa sau huấn luyện và chưng cất có nhận biết lượng tử hóa (QAD). Công thức NVFP4 dùng trọng số và kích hoạt 4-bit trên kiến trúc NVIDIA Blackwell. Cùng một checkpoint có thể chạy trên các nền tảng không phải Blackwell với trọng số 4-bit và kích hoạt 16-bit. Những thành phần nhạy cảm được giữ ở độ chính xác cao hơn.
NVFP4 làm mô hình gọn hơn, còn QAD giúp giữ độ chính xác khi hạ độ phân giải số. Trong quá trình QAD, mô hình đã lượng tử hóa học cách khớp đầu ra với mô hình BF16 gốc, nhờ đó thu hẹp khoảng cách độ chính xác do lượng tử hóa gây ra. QAD cũng cho phép lưu bộ đệm khóa-giá trị (KV cache) ở định dạng NVFP4 thay vì FP8 mà vẫn đạt mục tiêu về độ chính xác. Vì QAD diễn ra trong lúc huấn luyện, nó không làm tăng chi phí suy luận.
Dự đoán đa token
Dự đoán đa token (MTP) trang bị cho Nemotron 3.5 Super VL một bộ tạo bản nháp nội bộ, đề xuất nhiều token để mô hình chính xác nhận trong một lượt truyền thẳng. Chấp nhận nhiều token cùng lúc giúp giảm số bước xác nhận tốn kém cần để sinh ra một câu trả lời.
Một giai đoạn học tăng cường riêng cho MTP giúp bộ tạo bản nháp bám sát hơn với mô hình cuối cùng.
Tái sử dụng ngữ cảnh giữa các lượt của agent
Agent liên tục gửi lại cho mô hình cùng một bộ chỉ dẫn hệ thống, định nghĩa công cụ và lịch sử hội thoại. Bộ đệm tiền tố (prefix caching) tái sử dụng phần tính toán của những đầu vào chung đó.
Các tối ưu phục vụ (serving) của mô hình giữ lại cả bộ đệm attention lẫn trạng thái đệ quy Mamba. Các điểm checkpoint Mamba bổ sung giúp giảm lượng phát lại (replay) cần để khôi phục đầu vào cho giải mã suy đoán, còn cơ chế xác nhận nội bộ giúp tránh những lượt chạy mô hình thừa trong lúc xử lý prompt.
Đơn giản hóa triển khai sản xuất với NVIDIA NIM và NVIDIA Dynamo
NVIDIA NIM đóng gói mô hình kèm theo engine suy luận đã tối ưu, cấu hình đã kiểm chứng và API chuẩn, sẵn sàng triển khai trên đám mây và trong trung tâm dữ liệu. NIM được cập nhật liên tục về bảo mật, tính năng và hiệu năng. Hỗ trợ doanh nghiệp được cung cấp thông qua NVIDIA AI Enterprise. Bắt đầu với NIM.
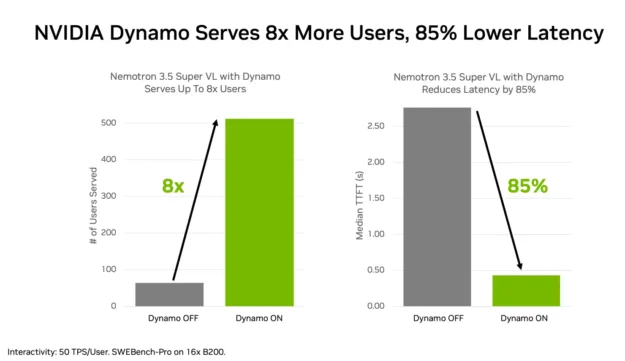
NVIDIA Dynamo cung cấp các tối ưu suy luận phân tán để tăng thông lượng và giảm độ trễ, gồm định tuyến nhận biết KV cache, quản lý bộ nhớ KV cache và phục vụ tách rời (disaggregated serving).
Trên 16 GPU NVIDIA B200, ở mức 50 token/giây cho mỗi người dùng, định tuyến nhận biết KV (KV-aware routing) kết hợp với gắn kết phiên (session affinity) và chuyển KV cache ra bộ nhớ ngoài (KV cache offload) có thể phục vụ số người dùng gấp 8 lần, đồng thời giảm 85% độ trễ tới token đầu tiên. Bắt đầu với các công thức triển khai Dynamo.
Bắt đầu với Nemotron 3.5 Super VL
Hãy xây dựng agent chuyên biệt với suy luận đa phương thức và khả năng dùng công cụ. Tùy chỉnh mô hình cho quy trình riêng của bạn, rồi triển khai trong môi trường được hỗ trợ.
Bản phát hành gồm các checkpoint mô hình nền, sau hậu huấn luyện và lượng tử hóa NVFP4, kèm công thức huấn luyện, dữ liệu và môi trường học tăng cường.
Xem báo cáo kỹ thuật Nemotron 3.5 để biết chi tiết về mô hình, và Hugging Face hoặc ModelScope để xem hướng dẫn triển khai. Để dùng bản mô hình được lưu trữ sẵn, xem OpenRouter.
Bài viết liên quan
- RTX Spark sau 30 ngày: hiệu năng thực chiến và kịch bản triển khai AI cục bộ
- Từ cuDSS đến FOX Blueprint: Ngăn xếp GPU và thư viện NVIDIA trong kỹ thuật – sản xuất công nghiệp châu Âu
- Chạy các mô hình AI Frontier-Class trên 8 nodes NVIDIA DGX Spark
- NVIDIA Nemotron 3.5 Super VL hỗ trợ các tác nhân chuyên biệt với khả năng suy luận đa phương thức
- 5 bước tạo tài nguyên SimReady cho robot với các mô hình AI tiên phong