Các đài quan sát và kính viễn vọng, laser và nguồn sáng tia X, cùng các thiết bị thông lượng cao khác tạo ra dữ liệu hình ảnh nhanh hơn so với khả năng xử lý của các quy trình dựa trên CPU để hỗ trợ ra quyết định kịp thời. Nút thắt tính toán hiếm khi chỉ là một kernel chậm. Đó là toàn bộ con đường từ dữ liệu trong cảm biến đến quyết định: đọc dữ liệu thô, khớp các hàm phân bố điểm hoặc phản hồi của detector, trừ hoặc giảm, khớp, phân loại và cảnh báo.
Các cơ sở hiện đại thường xuyên tích lũy hàng petabyte dữ liệu đa chiều trong một chiến dịch khảo sát hoặc thí nghiệm duy nhất. Với các triển khai ưu tiên CPU, có thể mất từ vài giờ đến vài tháng—đôi khi là một năm hoặc hơn—để có được kết quả có giá trị khoa học từ dữ liệu mà thiết bị tạo ra chỉ trong vài giây. Những sự chậm trễ này khiến các nhà khoa học và kỹ sư khó khăn hơn trong việc rút ra thông tin và thúc đẩy nghiên cứu của họ. Điều còn thiếu là một con đường bản địa GPU bao phủ mọi giai đoạn từ cảm biến đến quyết định, chứ không phải một phiên bản nhanh hơn của bất kỳ bước nào.
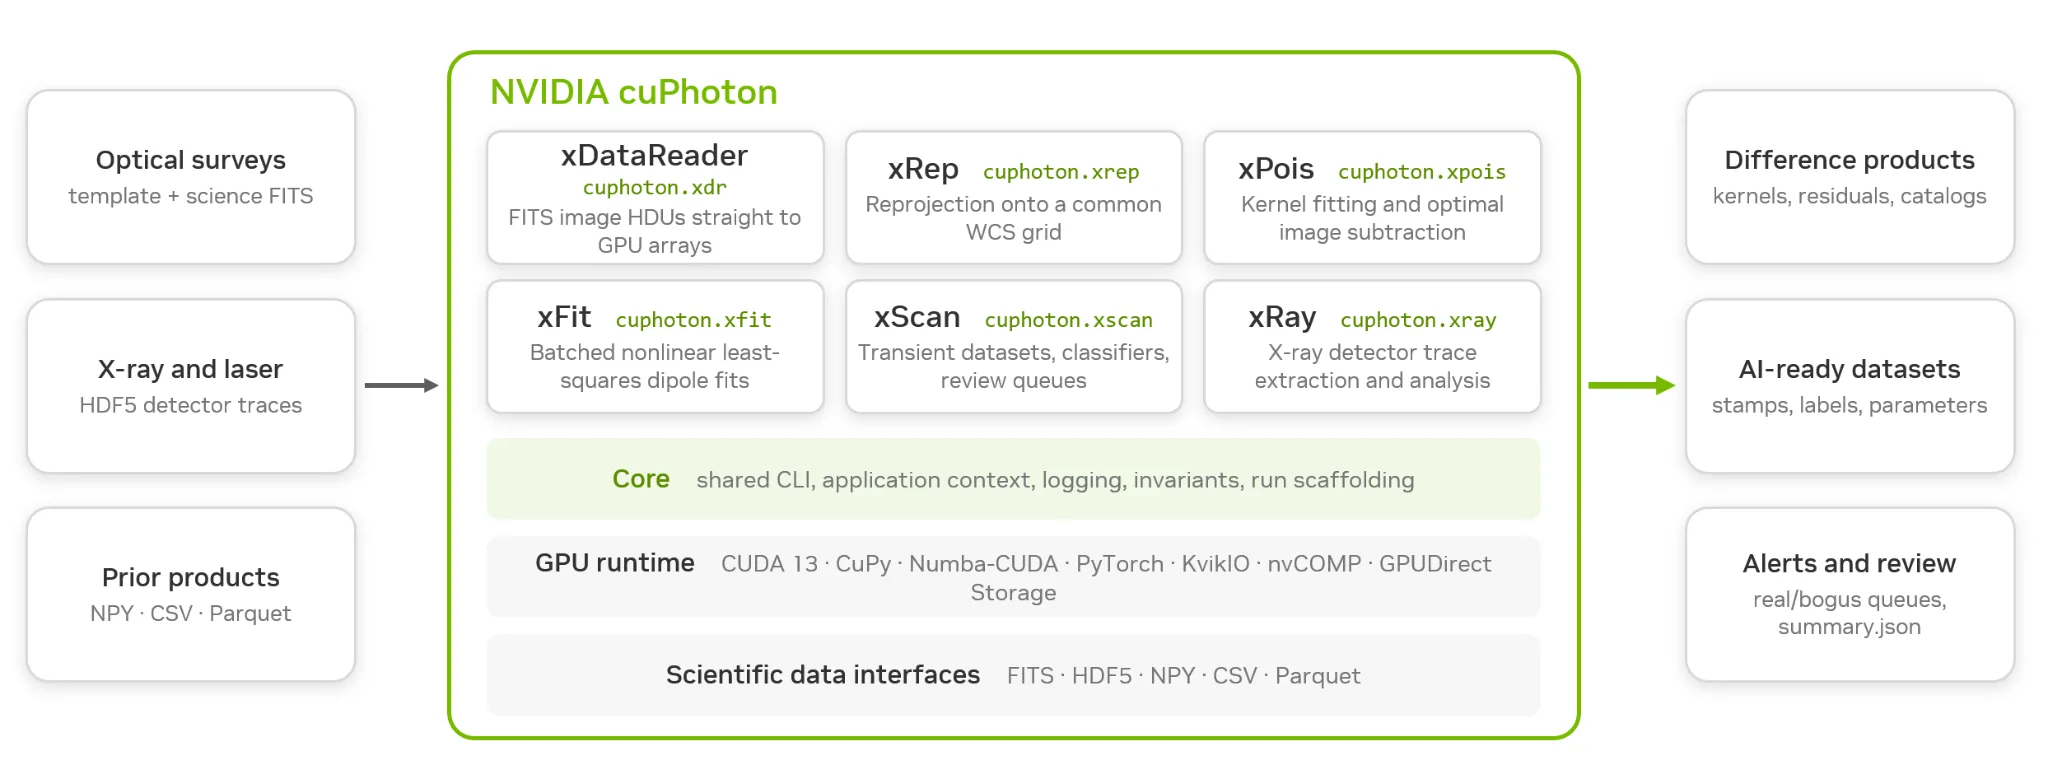
NVIDIA cuPhoton là một bộ công cụ NVIDIA CUDA-X mã nguồn mở gồm các khối xây dựng được tăng tốc bằng GPU cho lộ trình đó, bao phủ các trường hợp sử dụng từ thiên văn học phổ và quang học đến phân tích laser/tia X theo miền thời gian. Bằng cách giữ dữ liệu hình ảnh trên GPU từ khi đọc cảm biến cho đến khi phân loại, cuPhoton rút ngắn thời gian chờ xuống còn vài giây, tạo ra một vòng lặp chặt chẽ mà các nhà nghiên cứu có thể chạy tương tác, giúp rút ngắn thời gian đến nhận thức và cho phép các cơ sở theo kịp lượng dữ liệu mà các thiết bị của họ đang tạo ra.
Tăng tốc các hiểu biết khoa học từ nhiều tháng xuống còn vài phút với cuPhoton
Trong các lĩnh vực thiên văn học, khoa học tia X và các lĩnh vực thông lượng cao khác, NVIDIA cuPhoton cung cấp các công cụ để tải, xử lý và phân tích các bộ dữ liệu đa chiều khổng lồ. Ví dụ sau kết hợp các module của cuPhoton thành một quy trình đầu-cuối.
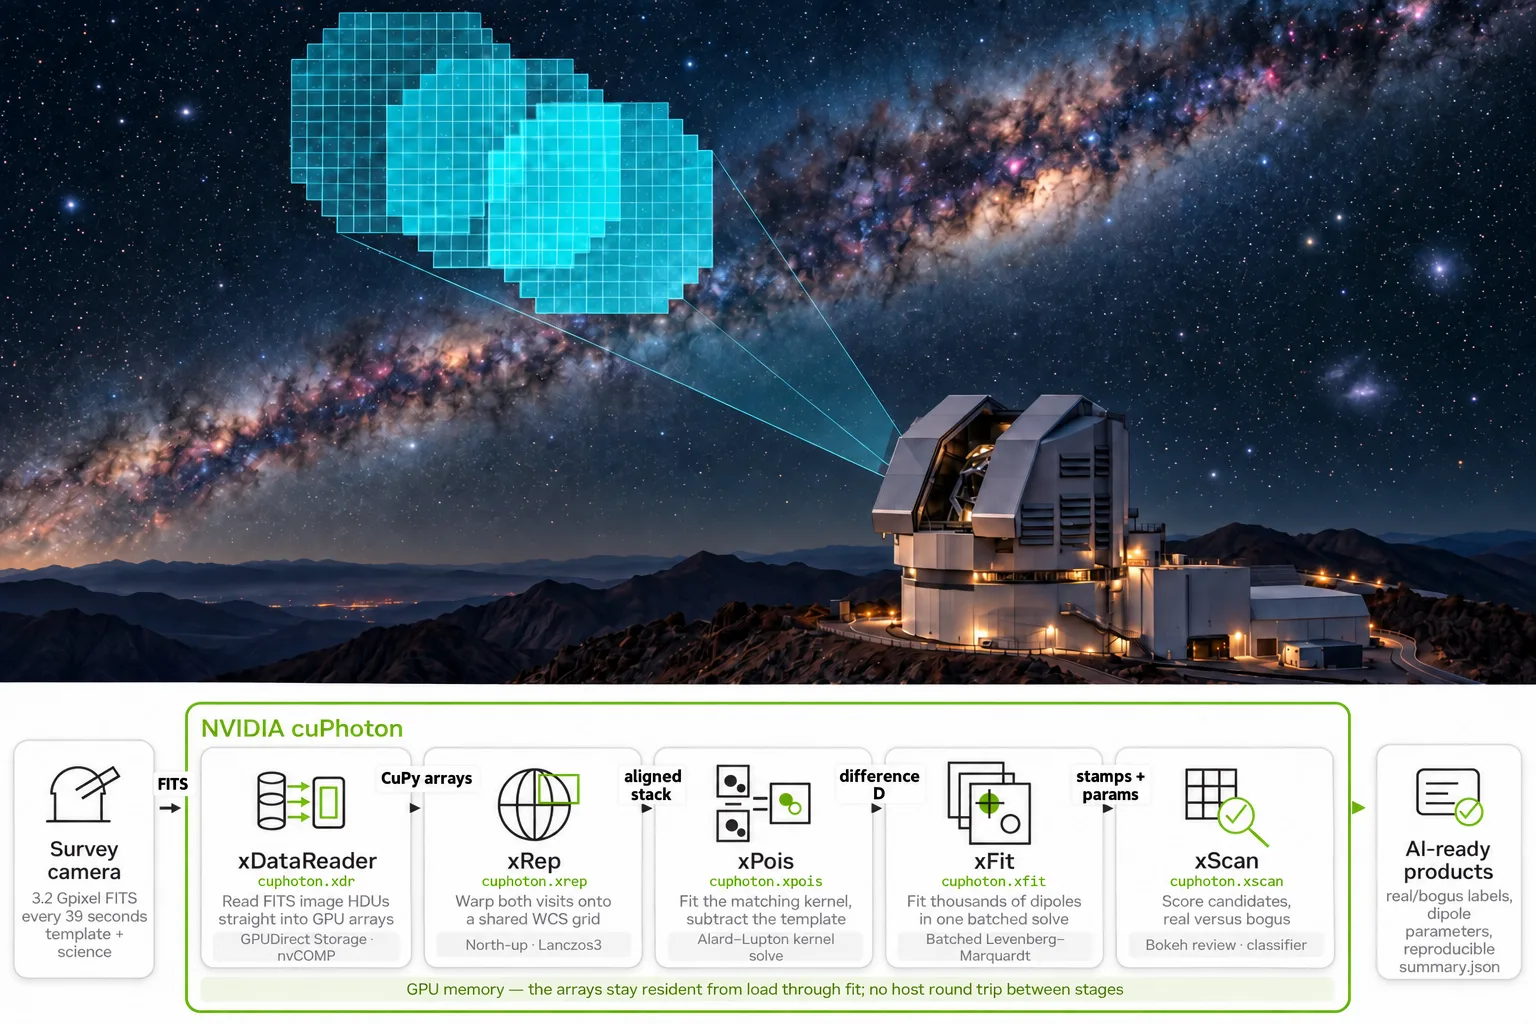
Viện Quan sát Vera C. Rubin của NSF-DOE là một ví dụ nổi bật về các cơ sở khoa học hiện đại có nhu cầu cao về việc trích xuất nhanh các thông tin khoa học. Mỗi 39 giây sau khi trời tối, LSSTCam của Viện Quan sát Vera C. Rubin ghi lại một phơi sáng mới 3,2 gigapixel của bầu trời phía nam. Quy trình Xử lý Nhanh (Prompt Processing) so sánh mỗi khung hình với một mẫu tham chiếu của cùng vùng bầu trời. Trong khoảng 60 đến 120 giây, nó phải phân loại khoảng 10.000 phát hiện là các hiện tượng thiên văn tạm thời hoặc các sản phẩm giả như tia vũ trụ, vệt vệ tinh và lỗi xử lý. Trong suốt một đêm, điều này tương đương với tối đa 20 terabyte hình ảnh và 10 triệu đối tượng ứng viên.
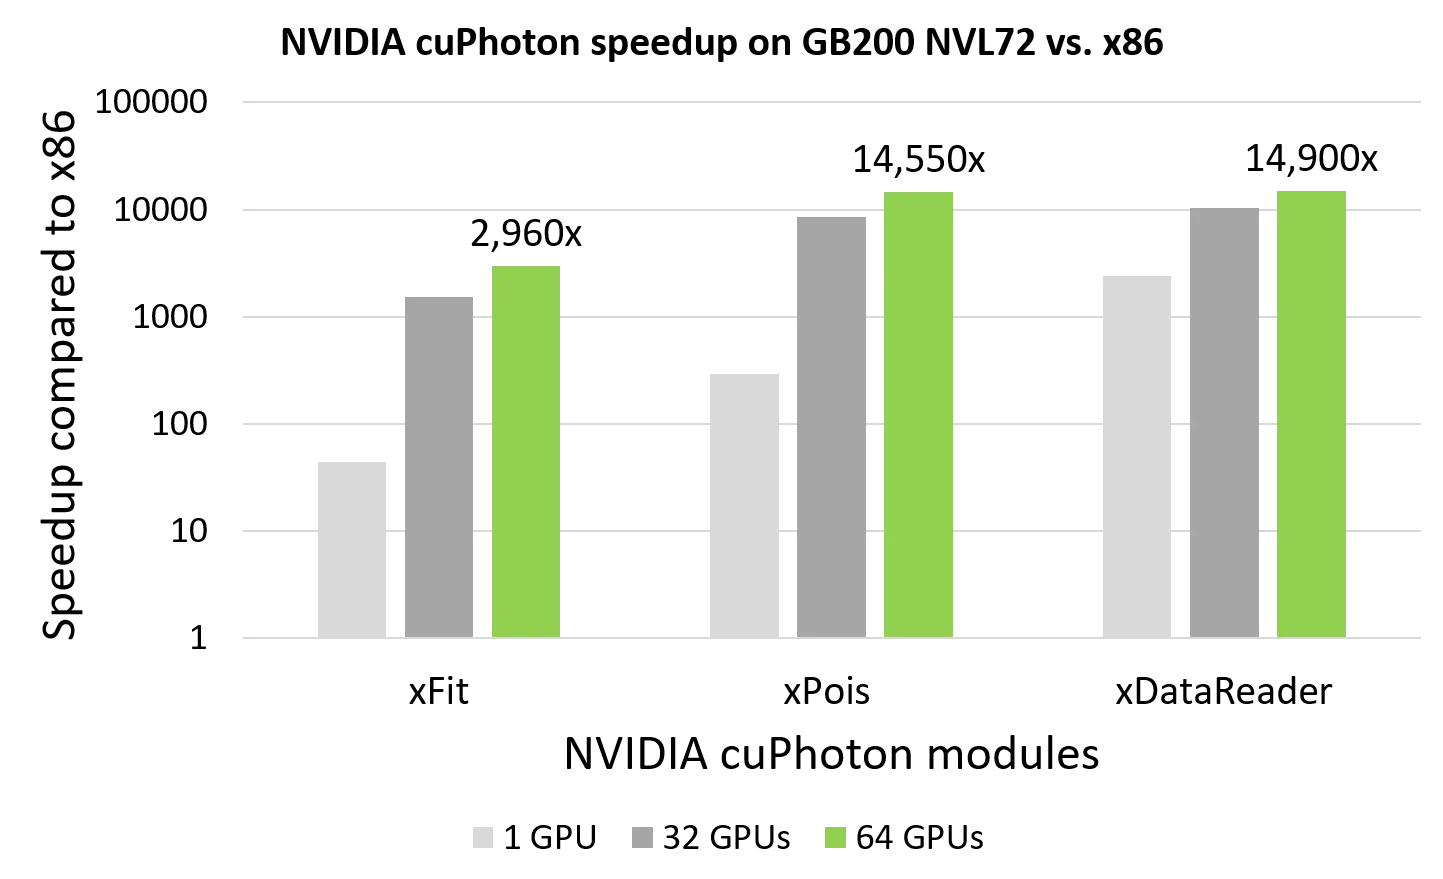
NVIDIA cuPhoton mở rộng trên các hệ thống NVIDIA Grace Blackwell và NVIDIA Vera Rubin đa GPU, đa nút. Trên các khối công việc đại diện liên quan đến hàng trăm terabyte dữ liệu sử dụng nhiều GPU, cuPhoton đã tăng tốc quá trình tải và đọc hình ảnh lên tới 14.900 lần và xử lý tín hiệu lên tới 14.550 lần, biến nhiều tháng thời gian tính toán thành vài phút. Phân tích dữ liệu trước đây mất chín tháng đã được chứng minh chỉ trong bốn giờ trên Python được tăng tốc bằng GPU. Đối với các bộ dữ liệu nhỏ hơn ở mức kilobyte, toàn bộ quy trình cuPhoton được thực hiện trong thang thời gian mili giây hoặc thậm chí micro giây. Hình 3 so sánh mức tăng tốc cho các thao tác cuPhoton riêng lẻ so với mức cơ sở CPU x86; các kết quả này không phải là mức tăng tốc của quy trình đầu-cuối.
Hướng dẫn chi tiết về một quy trình khoa học mẫu
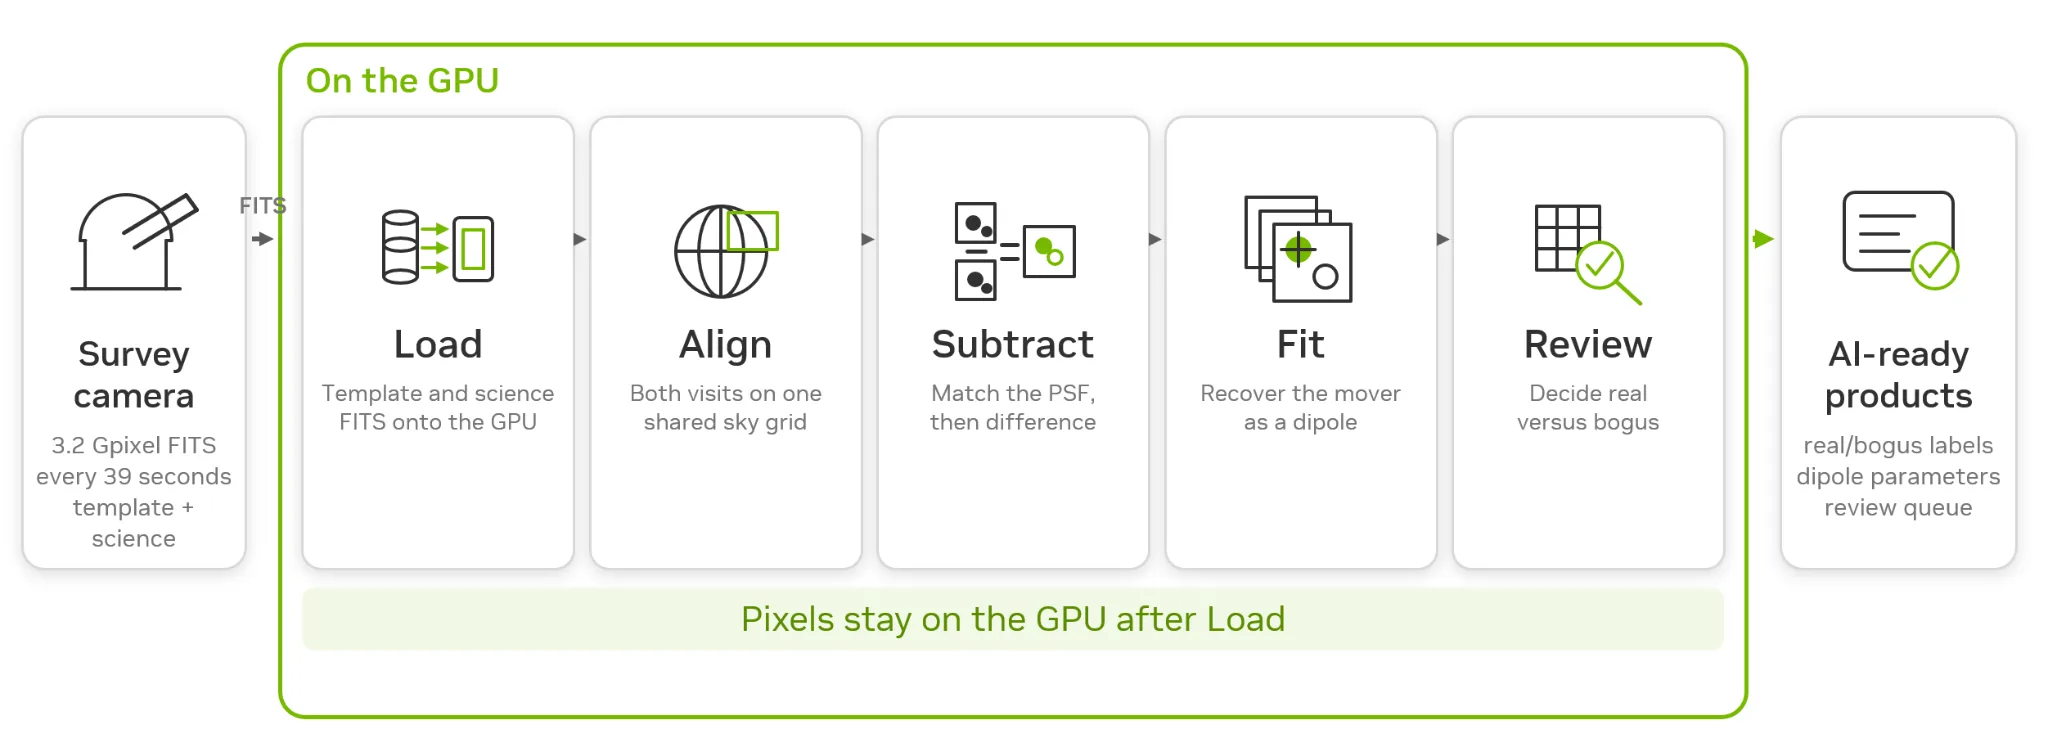
Bài viết này hướng dẫn chi tiết một quy trình khoa học thực tế, sử dụng một cặp ảnh thiên văn tổng hợp có động lực học vật lý. Các ví dụ sau được giữ ở quy mô nhỏ để có thể chạy trên NVIDIA DGX Spark hoặc trạm làm việc một GPU. Cùng một quy trình này có thể mở rộng trên các trạm làm việc và cụm máy nhiều GPU; việc khởi chạy đó sẽ được trình bày sau trong bài viết này. Hình 4 cho thấy các giai đoạn của quy trình được đề cập trong các phần tiếp theo.
- Nạp dữ liệu phơi sáng hiện tại và dữ liệu tham chiếu vào bộ nhớ GPU.
- Căn chỉnh: Đặt cả hai lần quan sát trên một lưới bầu trời chung để cùng một ngôi sao rơi vào cùng một pixel.
- PSF-match and subtract: Khớp các hàm phân bố điểm (PSF)—các mô hình mô tả cách ánh sáng được phân bố trên các pixel—trong phơi sáng hiện tại và một tham chiếu trước đó của cùng một khu vực. Sau đó, trừ đi tham chiếu. Một vật thể di chuyển sẽ để lại một cặp mô hình gồm các pixel dương và âm được gọi là lưỡng cực.
- Đặt một mô hình PSF kép vào lưỡng cực để ước tính vị trí của vật thể di chuyển.
- Trực quan hóa kết quả: hiển thị nhân khớp PSF, phần dư trừ và lưỡng cực được khôi phục.
Thực thi quy trình làm việc
Ví dụ sau đây sử dụng các bộ dữ liệu tổng hợp nhỏ để bạn có thể kiểm tra trên máy của mình. Các con số hiệu năng cao nhất được trích dẫn trước đó thay đổi tùy theo khối lượng công việc, bộ dữ liệu, cách triển khai và phần cứng. Mức tăng tốc lớn nhất là của các thao tác riêng lẻ và không nên được hiểu là hệ số cho toàn bộ quy trình từ đầu đến cuối.
Hướng dẫn này bao gồm năm thành phần của cuPhoton: xDataReader, xRep, xPois, xFit và xScan. Bộ công cụ cũng bao gồm xRay để phân tích đầu dò tia X trong miền thời gian.
Đầu tiên, sao chép kho mã và làm theo quy trình cài đặt trong README. Lệnh cài đặt (uv sync --locked --extra dev --extra gpu --extra viz) tạo ra một môi trường Linux cố định hỗ trợ hệ sinh thái NVIDIA CUDA 13: CuPy, PyTorch, Numba-CUDA, KvikIO và NVIDIA nvCOMP, cùng với các thư viện trực quan hóa (Bokeh và Pillow). Bản sao chép này cũng bao gồm CLI của cuPhoton, các module được sử dụng trong hướng dẫn này và examples/run_quickstarts.py, tạo ra các đầu vào tổng hợp và ghi các kết quả chạy vào quickstart-output/.
Thiết lập thư mục làm việc
Làm theo README để tạo môi trường GPU CUDA 13 đã khóa. Đường dẫn FITS của xDataReader cần thêm phần mở rộng native; từ thư mục checkout, chạy bash src/cuphoton/xdr/src/build.sh (hướng dẫn xDataReader). cuPhoton 0.1.3 hỗ trợ Python 3.12–3.14 và CUDA 13 trên Linux.
Việc xây dựng xDataReader từ mã nguồn yêu cầu trình biên dịch C++17, các tiêu đề phát triển CUDA và cuFile, cùng một cài đặt phát triển CFITSIO có khả năng tái nhập. Xem hướng dẫn xDataReader để biết các bước thiết lập.
git clone --branch v0.1.3 --depth 1 https://github.com/NVIDIA/cuPhoton.git
cd cuPhoton
export WORK_DIR="$PWD/blog-run"
mkdir -p "$WORK_DIR"/{fits,npz,figs}
Thực hiện từng đoạn mã Python theo trình tự trong một phiên tương tác duy nhất (chẳng hạn như Jupyter, IPython, hoặc một kịch bản tích hợp) bắt đầu từ thư mục gốc. Các phần sau sẽ tái sử dụng các biến được giữ trong bộ nhớ: images, aligned, reference, target, fit, stamp, model và result. Đảm bảo WORK_DIR vẫn được định nghĩa trong suốt quá trình thực thi. Nếu thành phần xDataReader native chưa được xây dựng, hãy tạm dừng và thực thi bash src/cuphoton/xdr/src/build.sh.
Kịch bản quy trình làm việc hoàn chỉnh có sẵn trong kho lưu trữ cuPhoton. Đối với các lần chạy tự động từ một terminal mới, hãy gọi run_imaging_pipeline.py thông qua uv run python. Đối với notebook tương tác, hãy mở run_imaging_pipeline.ipynb trong Jupyter.
Load FITS directly onto the GPU
Hệ thống Vận chuyển Hình ảnh Linh hoạt (FITS) là định dạng dữ liệu tiêu chuẩn trong thiên văn học và vật lý thiên văn. Thông thường, bạn đọc dữ liệu bằng Astropy trên CPU và sau đó gọi cupy.asarray để chuyển mảng kết quả vào bộ nhớ GPU. Việc phân tích cú pháp và giải nén diễn ra trên host, tiếp theo là truyền qua PCIe trước khi bất kỳ kernel khoa học nào được thực thi. (Với tốc độ dữ liệu terabyte mỗi giờ, chuỗi xử lý này tạo ra chi phí chuyển dữ liệu đáng kể và là nơi đầu tiên ngân sách độ trễ cảnh báo bị tiêu hao.)
Để giải quyết nút thắt cổ chai này, xDataReader tăng tốc quá trình giải nén, đọc và nạp dữ liệu FITS trực tiếp vào GPU. Cụ thể, xDataReader chia nhỏ khối lượng công việc như sau: CFITSIO lập kế hoạch các phạm vi byte trên CPU, KvikIO đọc chúng (sử dụng NVIDIA GPUDirect Storage khi khả dụng), nvCOMP giải nén các ô GZIP trên GPU, và CuPy lưu trữ kết quả. Nó hỗ trợ các HDU ảnh không nén có 2–16 trục và ảnh hai chiều với nén ô GZIP_1 hoặc GZIP_2. Nén Rice và lượng tử hóa số dấu phẩy động có nhiễu (dithered) không được hỗ trợ.
GPUDirect Storage khả dụng với trình điều khiển và hệ thống tệp tương thích. Trên các máy CUDA 13 khác, KvikIO có thể sử dụng đường dẫn tương thích PCIe của nó. API Python không thay đổi. batch_to_device vẫn trả về các mảng CuPy; cuphoton.xdr.is_gds_active() báo cáo đường dẫn hiện tại.
API công khai là batch_to_device. Mặc định, nó sử dụng chỉ mục HDU 1, phần mở rộng đầu tiên, phải chứa một hình ảnh được hỗ trợ. Đối với hình ảnh trong HDU chính, hãy truyền hdu_indices=(0,). Hàm trả về một mảng CuPy chồng xếp cho mỗi HDU được yêu cầu. Các tệp được nhóm vào một cuộc gọi phải khớp về hình dạng và dtype ở mỗi HDU được chọn.
Example:
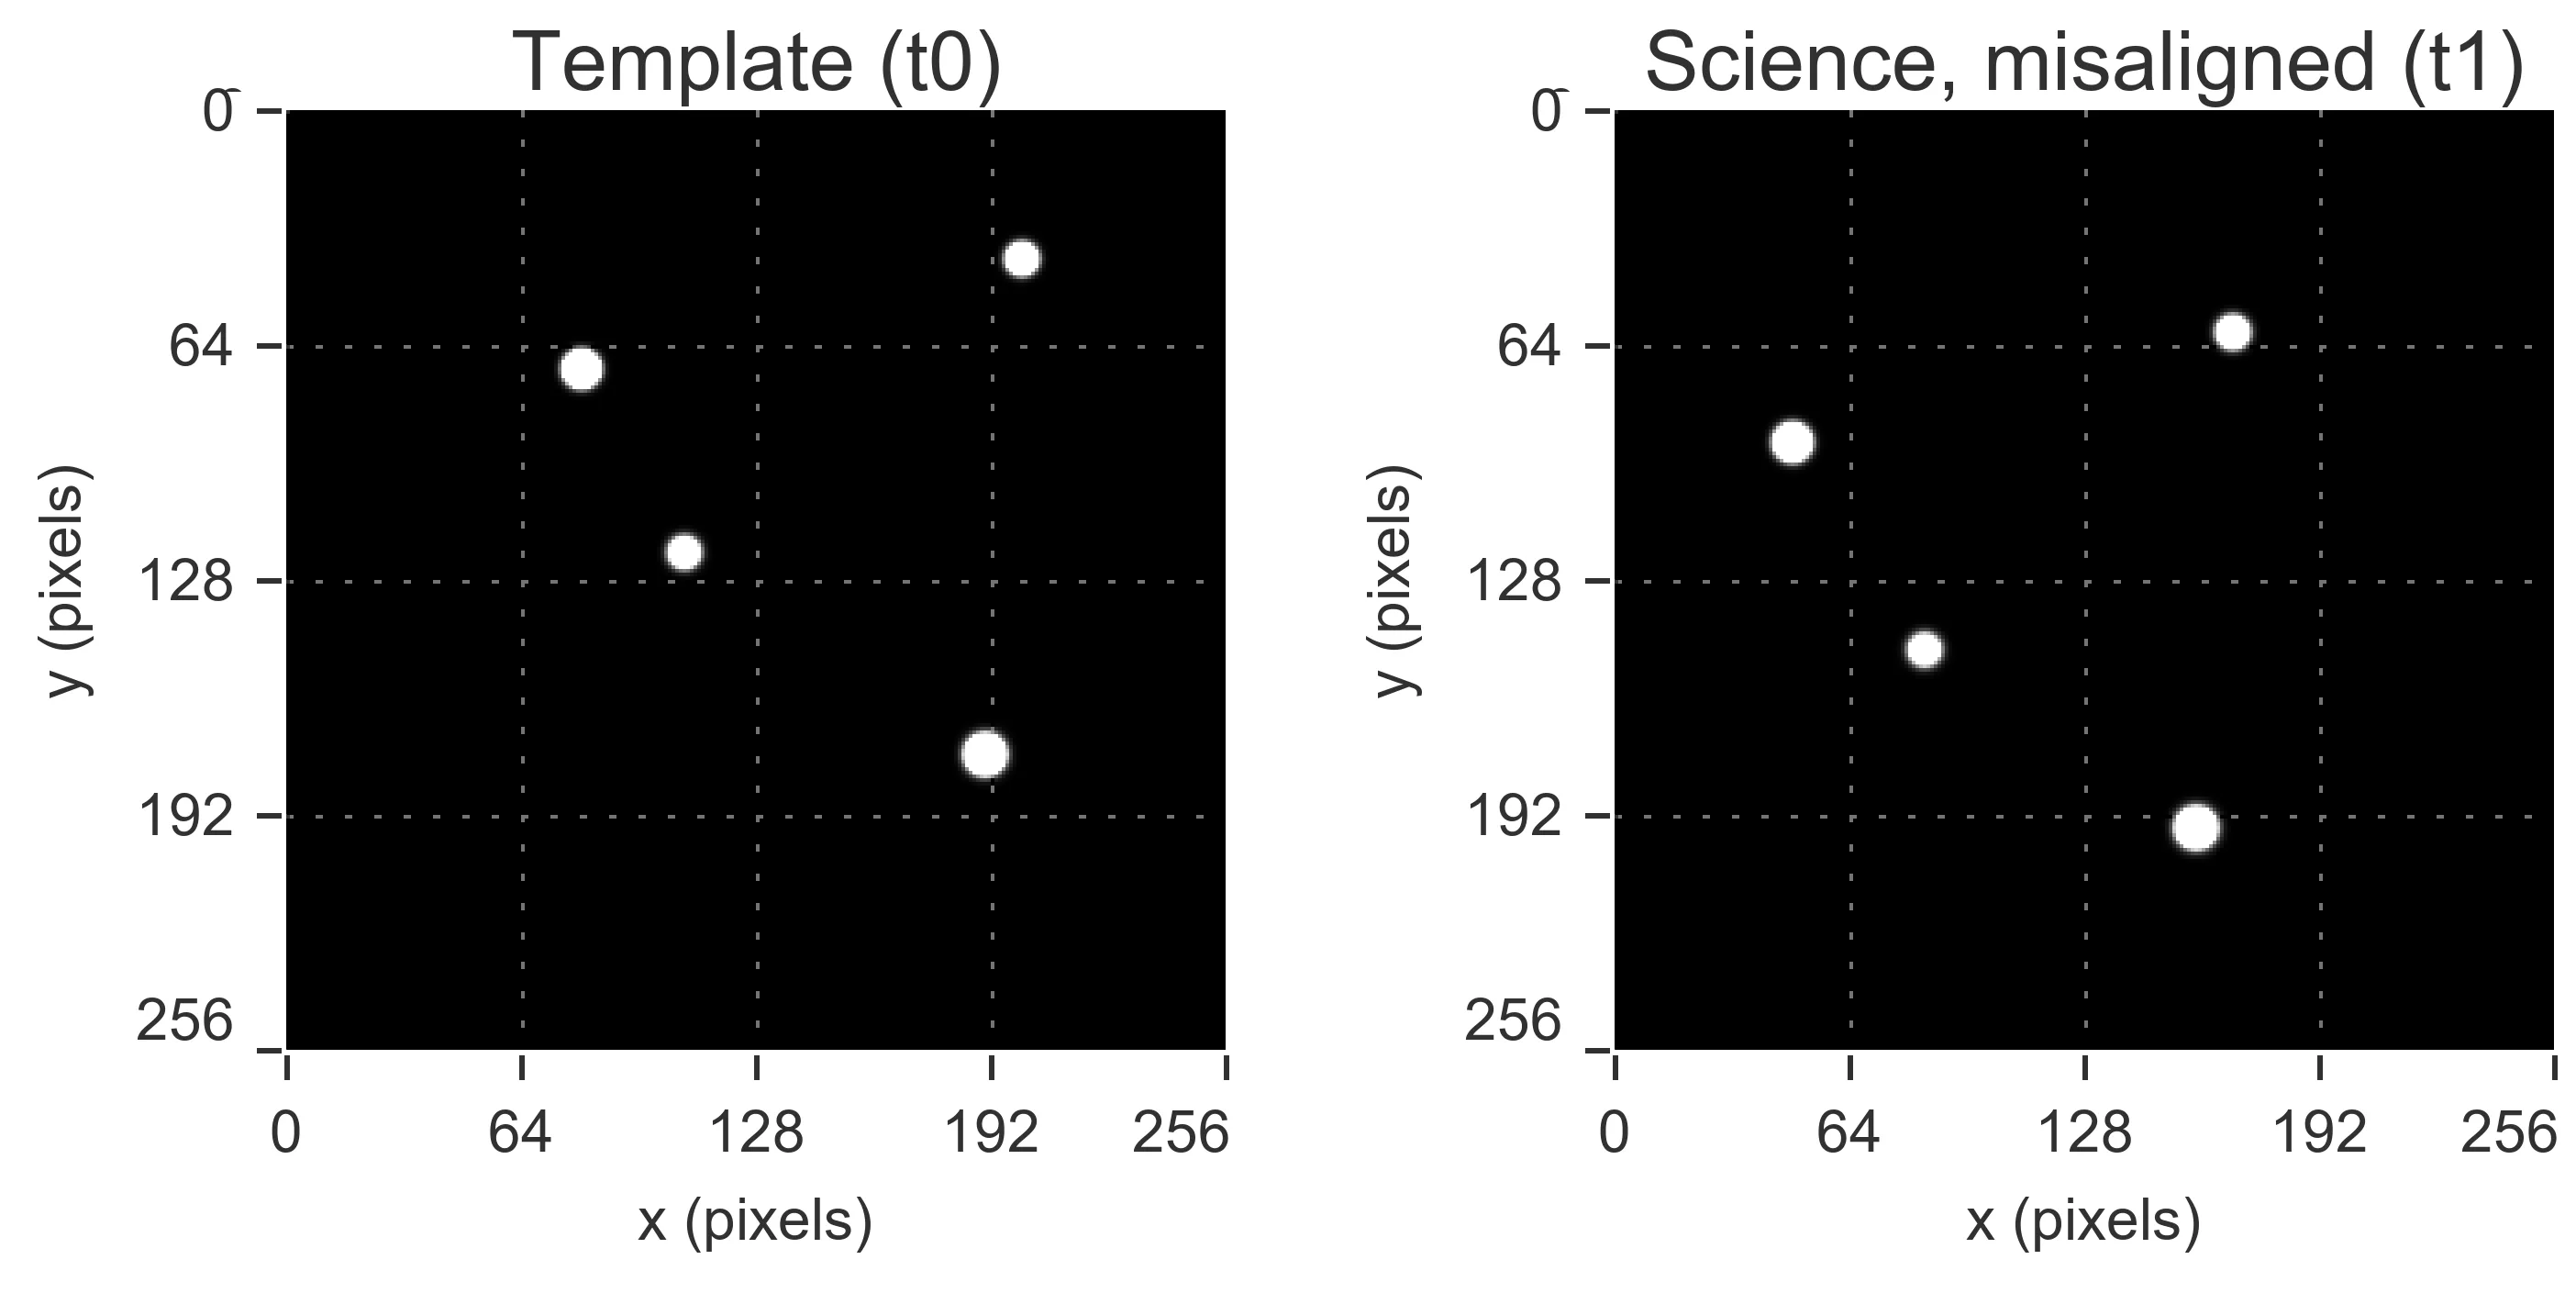
Mã nguồn sau ghi hai khung hình tổng hợp kích thước 256×256 mô phỏng một khuôn mẫu tham chiếu và một lần phơi sáng khoa học sau đó: ba ngôi sao tĩnh cùng một nguồn mờ hơn đã di chuyển vài pixel. Nguồn di chuyển duy nhất chính là lưỡng cực (dipole) mà bạn cần khôi phục sau khi trừ đi. Khung hình khoa học cũng hơi mờ hơn, như thể điều kiện nhìn (seeing) kém hơn. Ví dụ sau đó dịch chuyển ảnh khoa học để mô phỏng sai lệch hướng ngắm và cập nhật tiêu đề để cả hai khung hình vẫn mô tả cùng một vùng bầu trời. Hai tệp không chia sẻ lưới pixel cảm biến, nhưng Hệ tọa độ thế giới (WCS) trong tiêu đề của chúng ánh xạ cả hai sang cùng các tọa độ bầu trời.
Khối Python đầu tiên là khung nền tảng. Dán nó một lần và giữ phiên làm việc mở. Nó nhập tất cả những gì các phần sau cần và đặt WORK cùng các hằng số cảnh mà hai tệp FITS đó được viết với. Tệp script có thể tải xuống (run_imaging_pipeline.py) ghi các tệp với tọa độ bầu trời trong phần tiêu đề và định nghĩa các trình trợ giúp PNG được sử dụng ở cuối.
import os
from pathlib import Path

import numpy as np
from astropy.io import fits
from PIL import Image
from scipy.ndimage import gaussian_filter
from scipy.ndimage import shift as ndshift

from cuphoton.xdr import batch_to_device
from cuphoton.xfit import GaussianDipoleModel, fit_dipoles
from cuphoton.xpois import GaussianBasisComponent, solve_constant_kernel
from cuphoton.xrep import (
    BBox,
    Grid,
    build_stack_spec_from_fits,
    make_north_up_wcs,
    reproject_stack,
)

SHAPE = (256, 256)
STARS = (
    (70.0, 80.0, 45.0, 2.10),
    (175.0, 190.0, 32.0, 2.40),
    (40.0, 200.0, 22.0, 2.00),
)
MOVER_OLD = (120.0, 108.0, 14.0, 2.10)  # y, x, amp, sigma
MOVER_NEW = (126.5, 116.0, 14.0, 2.10)
CRVAL = (150.0, 2.0)
PIXEL_SCALE = 0.2  # arcsec / pixel
SCIENCE_SHIFT = (20.0, -32.0)  # dy, dx; large enough to see by eye
SEEING_SIGMA = 0.65  # extra Gaussian blur applied to the science frame
Khung nền tảng đó vẫn nằm trong bộ nhớ. Lệnh gọi sản phẩm là batch_to_device: nó đọc cả hai HDU hình ảnh lên GPU và trả về một mảng CuPy được xếp chồng.
(images,) = batch_to_device(
    [WORK / "fits" / "template.fits", WORK / "fits" / "science.fits"],
    hdu_indices=(1,),
)
Một lần chạy thành công sẽ in ra hình dạng mảng (2, 256, 256), kiểu dữ liệu của nó và thiết bị GPU mà nó được đặt lên—xác nhận cả hai khung hình đã được đưa lên thiết bị. Các mảng đó vẫn nằm trên lưới pixel gốc của từng tệp. Các ngôi sao tĩnh không nên thẳng hàng; đó là sự không khớp được cố ý đặt vào, không phải lỗi của trình tải.
Nội suy và căn chỉnh: Căn chỉnh cả hai lần quan sát trên cùng một lưới bầu trời
Hai lần quan sát cùng một vùng bầu trời thường không chia sẻ cùng một lưới pixel. Dither, quay và tỷ lệ bản đồ đặt cùng một ngôi sao ở các tọa độ (x, y) khác nhau trong khung mẫu và khung dữ liệu khoa học. WCS trong tiêu đề FITS là bản đồ ánh xạ từ các pixel đó lên bầu trời. xPois khớp các hàm phân bố điểm (PSF) trên các mảng đã được đăng ký. Trừ trước, và mọi ngôi sao tĩnh sẽ trở thành phần dư; vật thể chuyển động không còn là một lưỡng cực sạch nữa.
xRep lấy mẫu lại các hình ảnh hai chiều lên một lưới thiên văn chung hướng Bắc. build_stack_spec_from_fits đọc cả hai nghiệm WCS và xây dựng một vùng chân dung đích duy nhất. reproject_stack biến dạng mọi thành viên lên lưới đó. backend="auto" ưu tiên CuPy, sau đó là CUDA PyTorch, rồi đến CPU nếu không có GPU. Nội suy mặc định là Lanczos-3.
Khối tiếp theo giữ nguyên dữ liệu FITS được ghi ở trên—gồm các pixel detector gốc cùng với độ dịch chuyển CRPIX đã cài đặt—và đặt cả hai lần quan sát lên cùng một lưới. Sau khi biến dạng, các ngôi sao tĩnh nên nằm đúng trên mẫu. Đối tượng di chuyển phải là nguồn duy nhất thay đổi vị trí trên bầu trời.
native, spec = build_stack_spec_from_fits(
    [WORK / "fits" / "template.fits", WORK / "fits" / "science.fits"],
    hdu=1,
    grid=Grid.from_wcs(wcs_t),
    output_bbox=BBox(0, 0, SHAPE[1], SHAPE[0]),
    interpolation="lanczos3",
    mapping_grid_step=16,
)
aligned = reproject_stack(native, spec, backend="auto")
In aligned.images.shape và aligned.backend. Dự kiến sẽ có một chồng hai khung hình và backend GPU trên CUDA 13. Nếu các ngôi sao tĩnh vẫn cách nhau vài pixel, thì WCS không mô tả đúng độ dịch chuyển bạn đã cài đặt, hoặc lưới đích không bao phủ cả hai vùng phủ sóng.
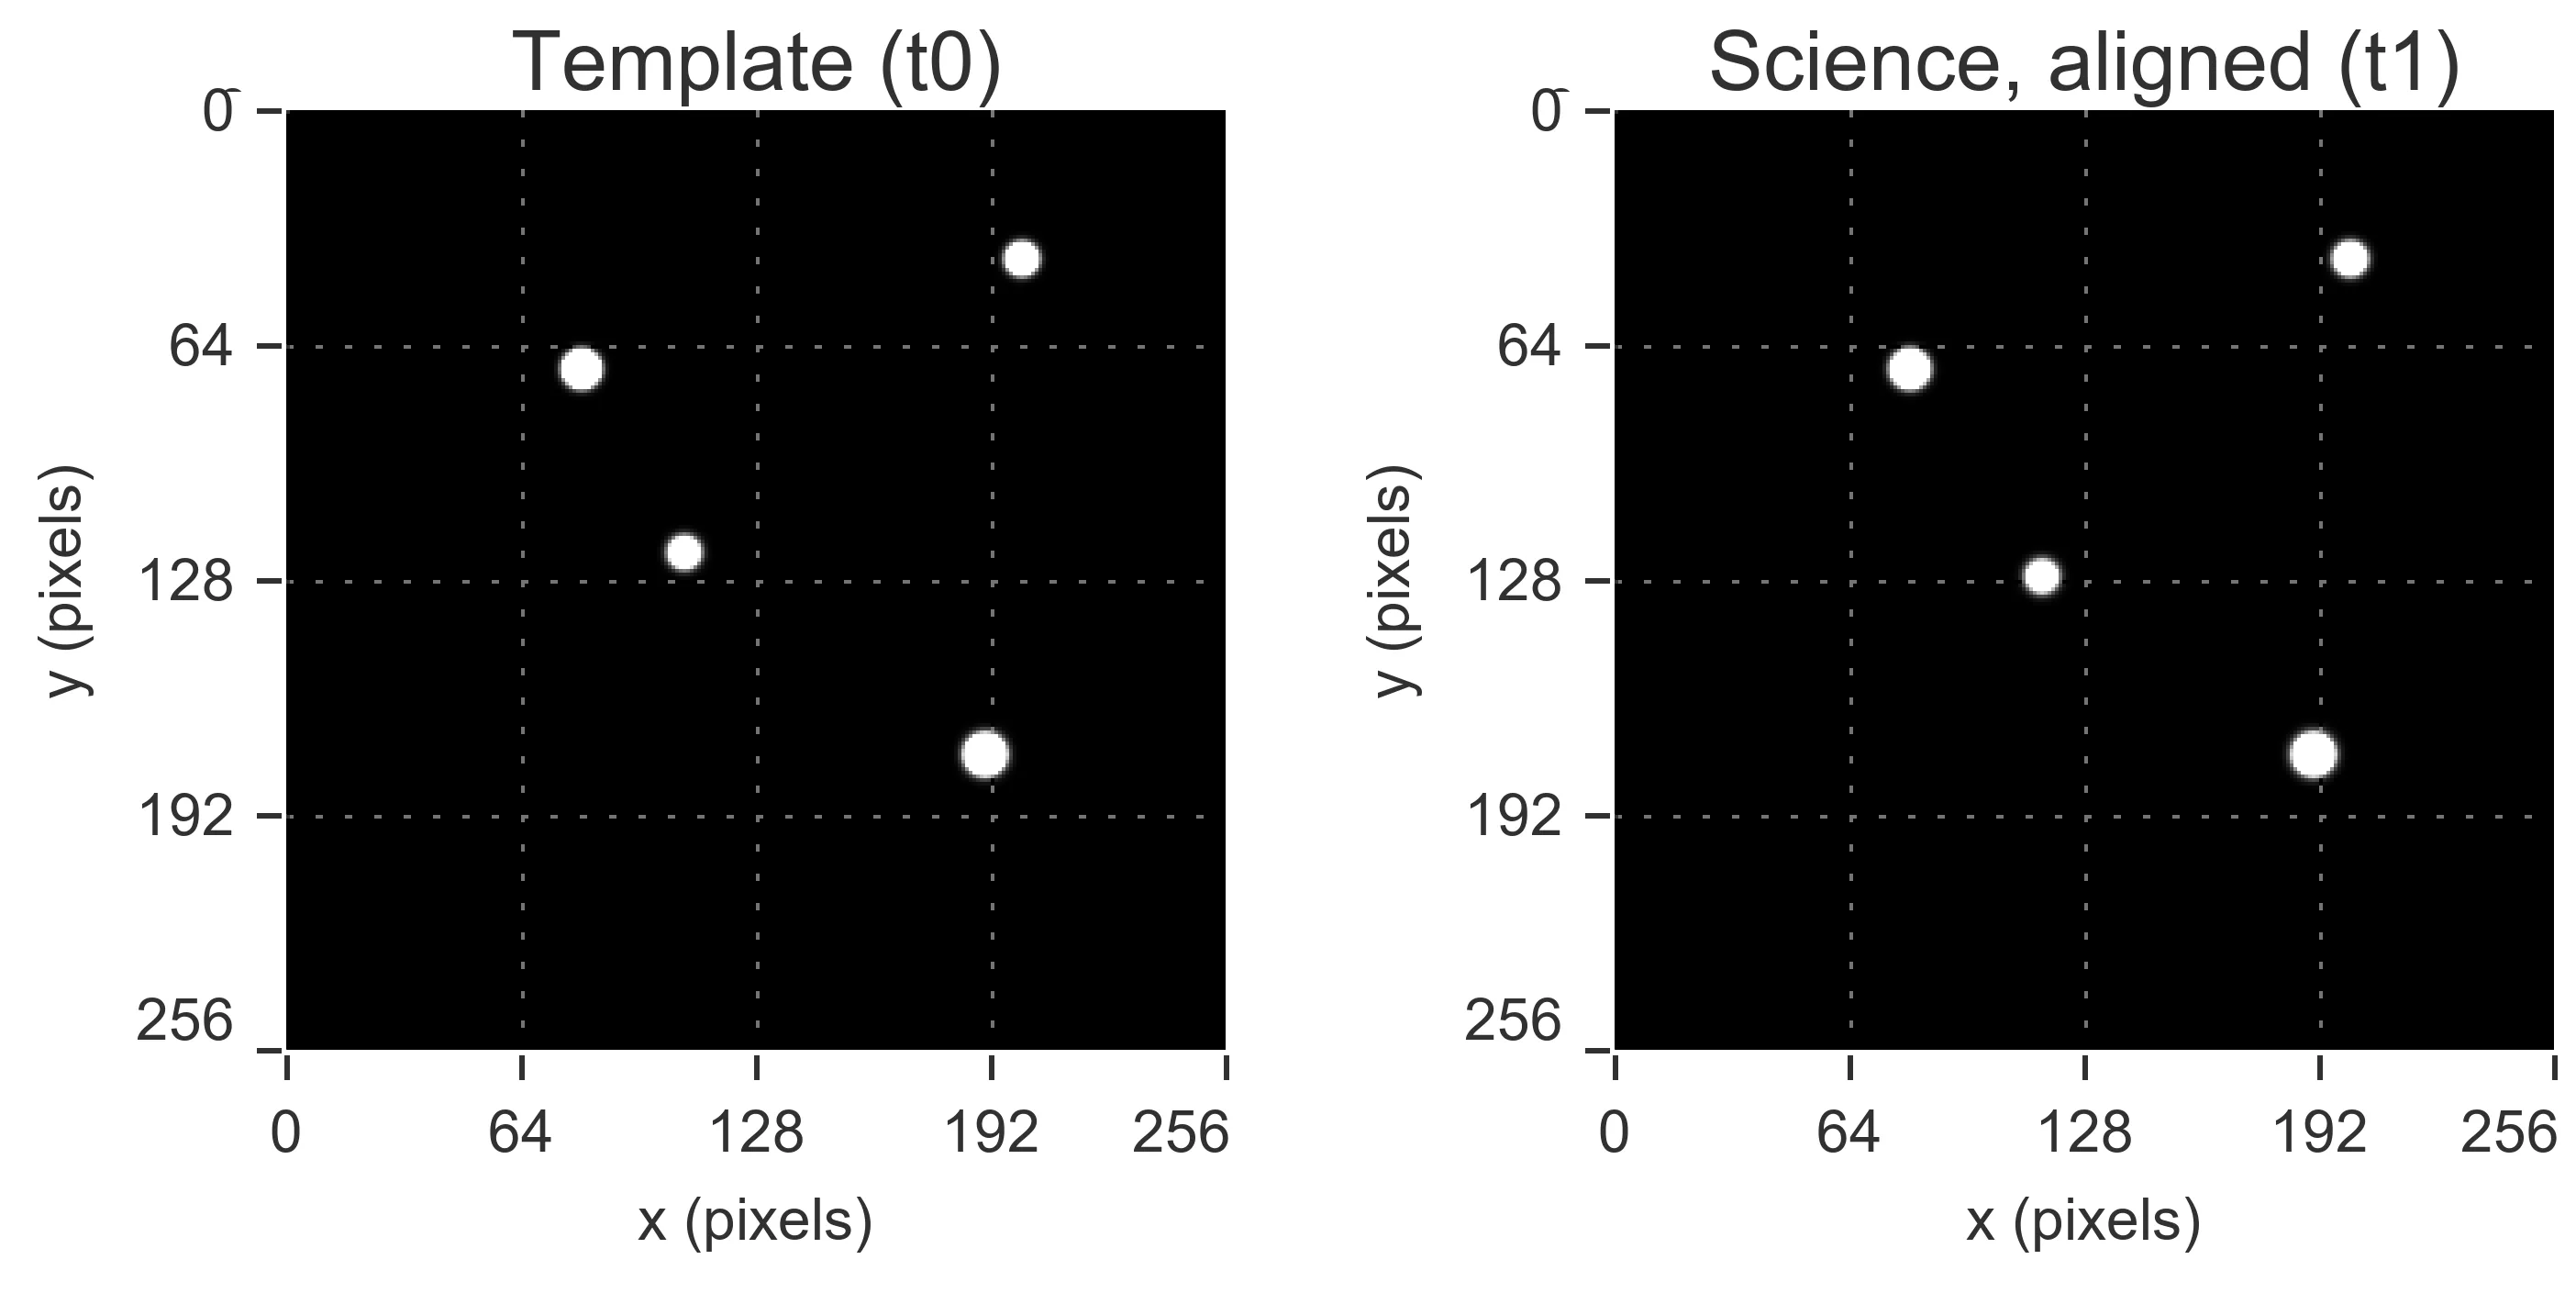
reproject_stack. Các sao tĩnh được khớp đúng trong khi nguồn chuyển động được cấy vẫn bị lệchTrùng khớp PSF và phép trừ
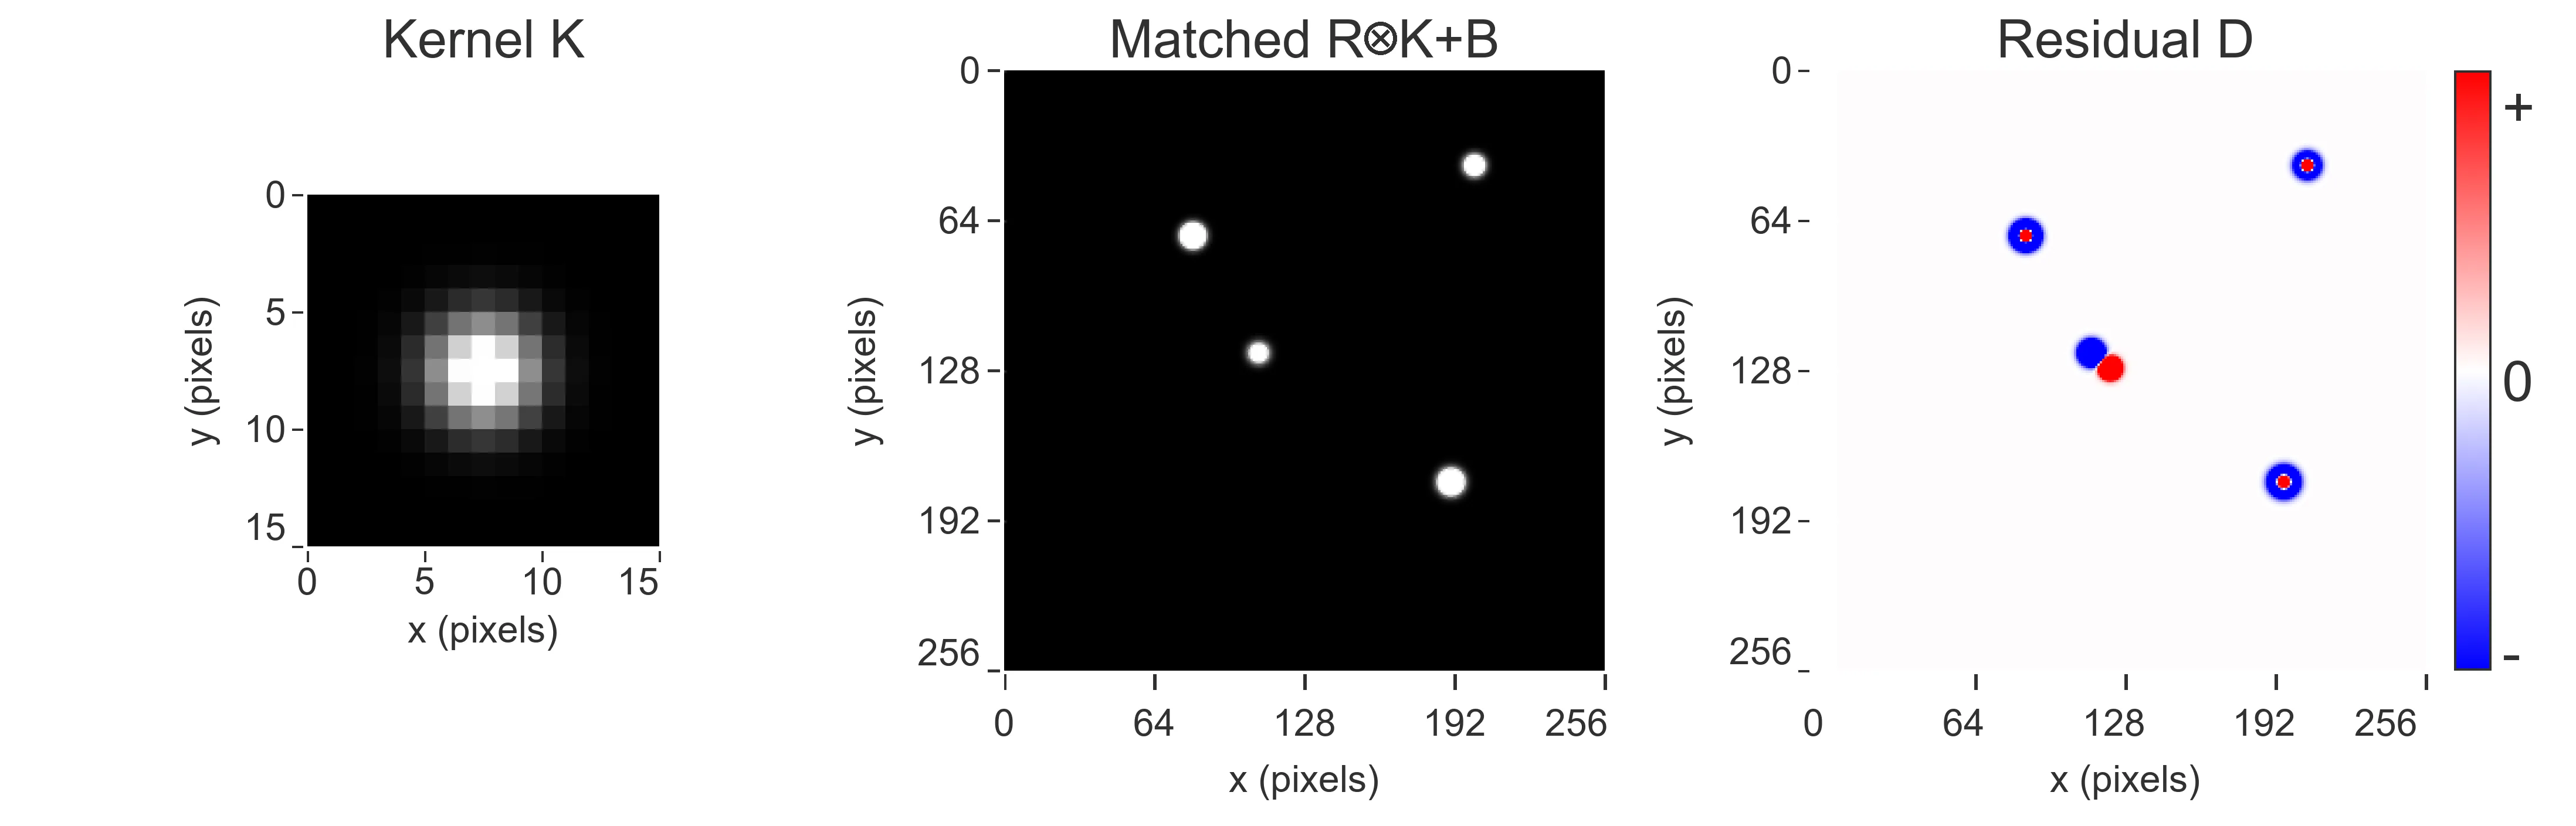
Hiệu số thô giữa ảnh khoa học và mẫu chuẩn bị bị chi phối bởi các phần dư quanh mọi ngôi sao sáng do sự khác biệt trong độ mờ của khí quyển (seeing). Phép trừ ảnh tối ưu, theo Alard và Lupton, thay vào đó giải quyết một nhân cuộn gọn K và một nền vi phân B để mẫu chuẩn tham chiếu R nhận được PSF khoa học và khớp với phơi sáng khoa học, T:
T ≈ R ⊗ K + B,
trong đó ⊗ chỉ phép cuộn. Mô hình kết quả sau đó được trừ khỏi phơi sáng T để tạo ra hiệu số D:
D = T − (R ⊗ K + B).
Sử dụng cơ sở nhân (kernel) đa thức Gaussian, xPois tính toán nhân tích chập (convolution kernel) cần thiết để trừ ảnh tối ưu. Đối với việc giải nhân hằng số (constant-kernel solve) được sử dụng ở đây, backend="auto" chọn backend khả dụng đầu tiên theo thứ tự sau: CuPy, Numba-CUDA, CPU. Việc giải hệ số nhỏ (small coefficient solve) vẫn được thực hiện trên host; các pixel thì không. Việc viết lại cơ sở bảo toàn thông lượng (flux-conserving basis rewriting) giữ cho tổng của nhân gần bằng một. Hãy kiểm tra tổng này khi đánh giá sự bảo toàn thông lượng. Một nhân hoạt động tốt sẽ gọn gàng và xấp xỉ đối xứng. Một vòng sáng hoặc một hố âm lớn có nghĩa là cơ sở không thể biểu diễn sự không khớp của seeing (seeing mismatch), hoặc một ngôi sao bão hòa (saturated star) đã đi vào quá trình khớp (fit) mà không bị che (unmasked).
Khối tiếp theo giữ reference và target từ ngăn xếp đã căn chỉnh và khớp một nhân 15×15. Vì xRep đặt các lần thăm quan trên một WCS duy nhất, một nhân gọn gàng nên hấp thụ được sự sai lệch về độ mờ (seeing). Ba ngôi sao tĩnh nên triệt tiêu lẫn nhau. Vật thể di chuyển nên vẫn tồn tại như một thùy dương tại t1 và một thùy âm tại t0.
fit_mask = np.ones(SHAPE, dtype=bool)
fit_mask[105:142, 93:132] = False
fit = solve_constant_kernel(
    reference,
    target,
    [GaussianBasisComponent(sigma=SEEING_SIGMA, degree=0)],
    kernel_shape=(15, 15),
    background_degree=0,
    flux_conserve=True,
    fit_mask=fit_mask,
    backend="auto",
)
In fit.backend, kernel.sum(), chi2 và fit_pixel_count. Tổng nhân gần 1.0 và phần dư mà các vòng tròn của ngôi sao sáng đã sụp đổ có nghĩa là việc khớp đã thành công. Nếu các ngôi sao vẫn chiếm ưu thế trong D, thì hoặc là các hình ảnh chưa được đăng ký—sử dụng cuphoton.xrep để đặt chúng trên một WCS chung—hoặc là cơ sở nhân quá hẹp so với sự khác biệt về độ mờ. Trên GPU CUDA 13, fit.backend nên là cupy và RMS phần dư nên nằm thấp hơn nhiều so với biên độ đỉnh của ngôi sao khoảng 45 trong cảnh này.
Khớp các lưỡng cực
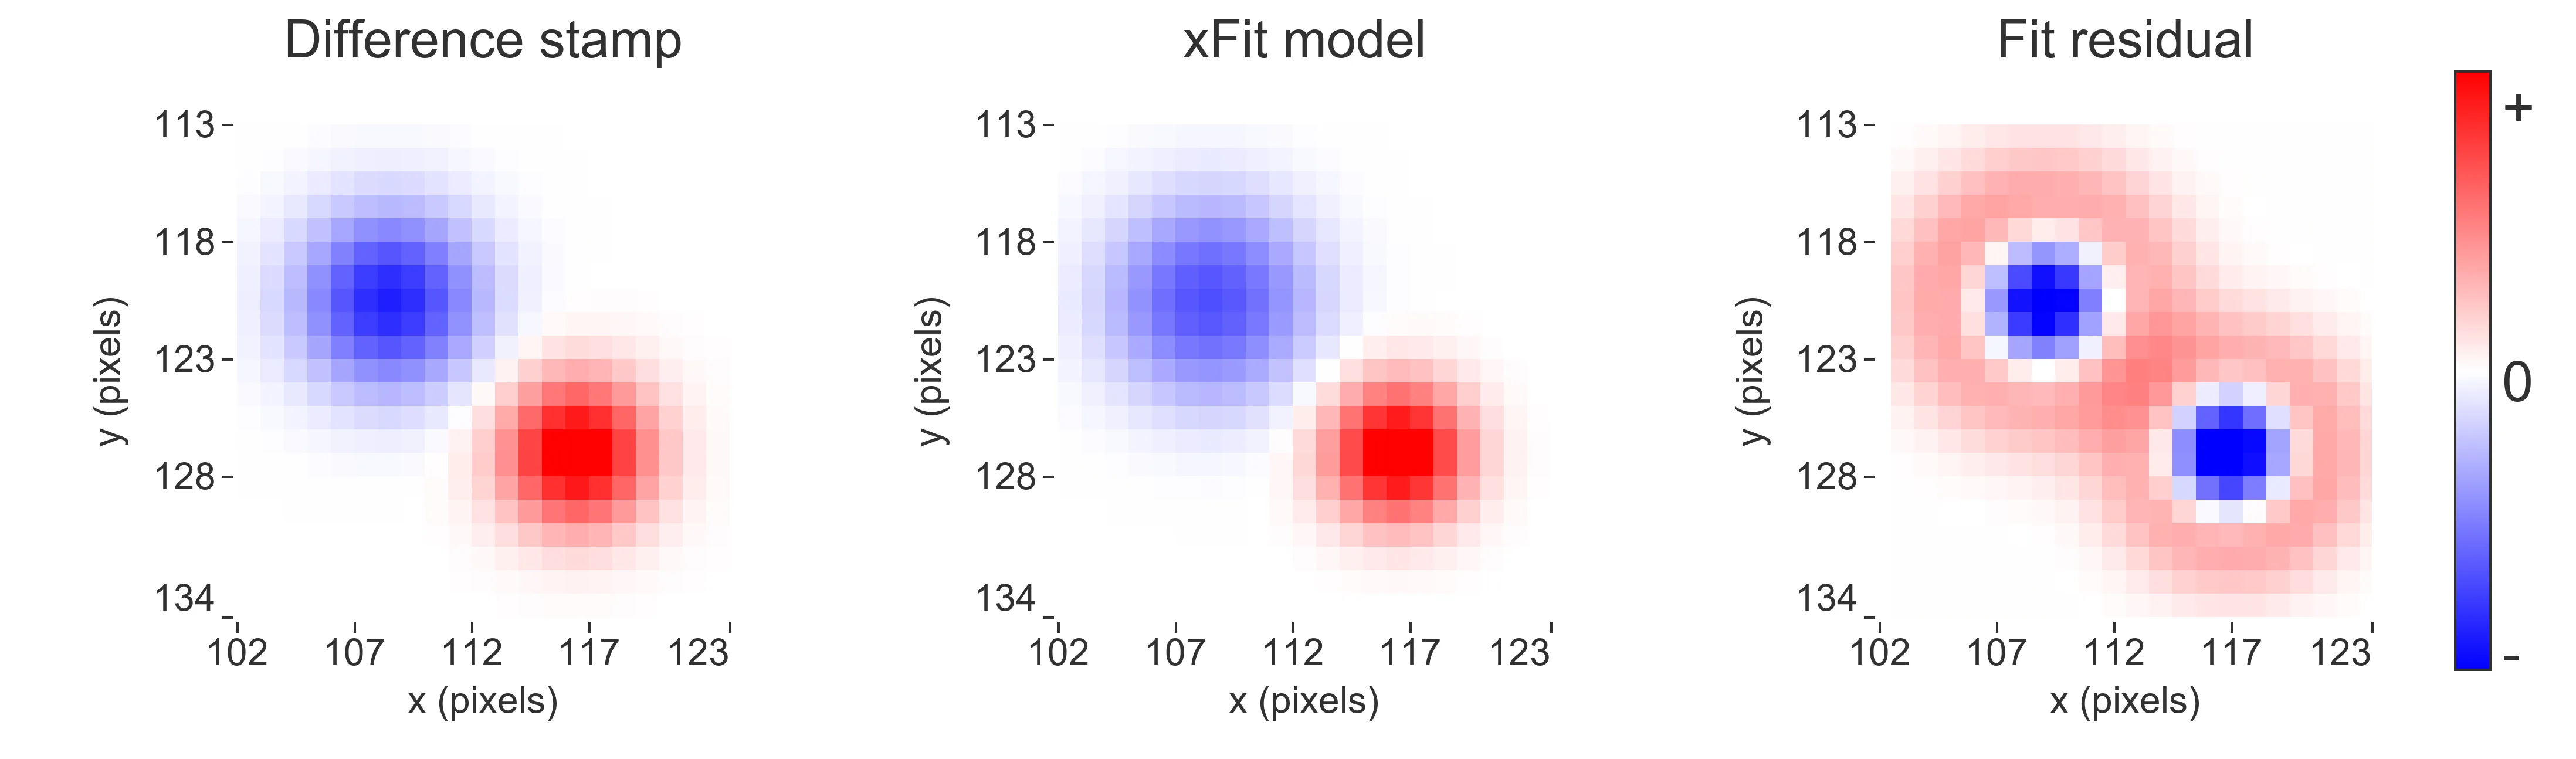
Các vật thể chuyển động, chẳng hạn như tiểu hành tinh, và các lỗi đăng ký hình ảnh có thể tạo ra các mẫu lưỡng cực. Đây là các vùng thông lượng dương và âm ghép đôi trong một hình ảnh chênh lệch. Việc xử lý từng ứng viên riêng lẻ có thể trở thành nút thắt cổ chai. Một quy trình có thể cần giải hàng nghìn bài toán tối ưu hóa bình phương tối thiểu trên các con dấu hình ảnh nhỏ cho mỗi lần phơi sáng.
Trong ví dụ này, GaussianDipoleModel của xFit mô hình hóa mỗi con dấu như một sự chênh lệch giữa hai thành phần Gaussian elip được xoay. Cả hai thành phần đều được đánh giá tại cùng các tọa độ pixel (x,y) và chia sẻ biên độ, độ rộng và hướng. Hai tâm (x⁺, y⁺) và (x-, y-) thay đổi độc lập:
m(x, y) = G(x, y; x⁺, y⁺) − G(x, y; x⁻, y⁻)
xFit cũng hỗ trợ các mô hình dựa trên các PSF được lấy mẫu do người dùng cung cấp thông qua StampDipoleModel.
Bộ giải Levenberg–Marquardt của xFit phân rã nhiều hệ Gauss–Newton có điều chỉnh cùng lúc trên CuPy. Các phép khớp đã hội tụ sẽ không tiếp tục tham gia vào các lần lặp bộ giải tiếp theo, giúp giảm thiểu các công việc không cần thiết. Lệnh đồng bộ sẽ trả về kết quả của lô sau khi các phép khớp còn lại hoàn tất. Độ rộng được tối ưu trong không gian log và được trả về dưới dạng độ lệch chuẩn pixel dương; Jacobian phân tích là mặc định cho mô hình Gaussian. Các mảng được trả về là NumPy có thể di chuyển—bao gồm tham số, hiệp phương sai và sai số chuẩn—do đó bộ phân loại không bao giờ phải nhập bộ giải CuPy.
Đoạn mã sau cắt một con tem 21×21 xung quanh đối tượng di chuyển được cấy trong phần dư xPois và bắt đầu quá trình khớp từ một giá trị ban đầu hơi sai. In các tâm được khôi phục cùng với các vị trí đầu vào đã biết. So sánh các tâm được khôi phục với các vị trí đầu vào đã biết để kiểm tra độ chính xác của phép khớp.
STAMP = 21
half = STAMP // 2
cy, cx = 123, 112  # midpoint of the planted mover
stamp = fit.residual[cy - half : cy + half + 1, cx - half : cx + half + 1]

# Seed the fit from the observed stamp extrema, in centered x/y coordinates.
y_pos, x_pos = np.unravel_index(np.argmax(stamp), stamp.shape)
y_neg, x_neg = np.unravel_index(np.argmin(stamp), stamp.shape)
initial = np.array(
    [
        [
            stamp.max(),
            2.0,
            2.0,
            0.0,
            x_pos - half,
            y_pos - half,
            x_neg - half,
            y_neg - half,
        ]
    ]
)

model = GaussianDipoleModel((STAMP, STAMP), dtype=np.float64)
result = fit_dipoles(
    stamp[None], model=model, initial=initial, backend="auto"
)
Trên dữ liệu tổng hợp này, hãy mong đợi converged: True. Các giá trị (x_pos, y_pos) và (x_neg, y_neg) được khôi phục nên nằm trong phạm vi một phần nhỏ của một pixel so với vị trí dịch chuyển đã được đặt trước. Dấu hiệu còn sót lại có cấu trúc trong phần dư khớp thường có nghĩa là con dấu (stamp) vẫn chứa một ngôi sao tĩnh hoặc các tâm ban đầu nằm ở thùy (lobe) sai.
Xem lại các con dấu
Các ví dụ ở trên xác thực quy trình làm việc trên một cảnh tổng hợp được kiểm soát với một vật thể di chuyển được đặt sẵn và dữ liệu thực tế đã biết. Các quan sát thực tế không cung cấp sự đơn giản hay sự chắc chắn đó. Một lần hướng kính viễn vọng (lượt quan sát) có thể tạo ra tới 10.000 ứng viên, và một đêm hoàn chỉnh sẽ tạo ra hàng triệu, khiến việc kiểm tra từng ứng viên trở nên không thực tế. Bước tiếp theo là ưu tiên các ứng viên để con người xem xét.
cuphoton xscan review-queue xếp hạng các ứng viên—dựa trên độ bất định của mô hình, dựa trên các lỗi đã biết, hoặc như một cuộc kiểm toán bộ dữ liệu trực tiếp—và giới hạn số lượng ứng viên để con người xem xét. Sử dụng cuphoton xscan review-bokeh để kiểm tra mức độ phơi sáng tìm kiếm (quan sát hiện tại), mẫu tham chiếu, hiệu số thô và phần dư xPois, với các nhãn Real / Bogus / Unsure cho từng ứng viên.
Hình 9 hiển thị giao diện xem xét với một ví dụ về nhiễu, giúp bạn kiểm tra bố cục trước khi sử dụng với một quan sát. Dữ liệu FITS quan sát không có trong kho lưu trữ git. Sao chép một ví dụ trong examples/xscan/, đặt các đường dẫn cục bộ và làm theo README cùng hướng dẫn xScan để xây dựng hàng đợi xem xét và khởi động ứng dụng.
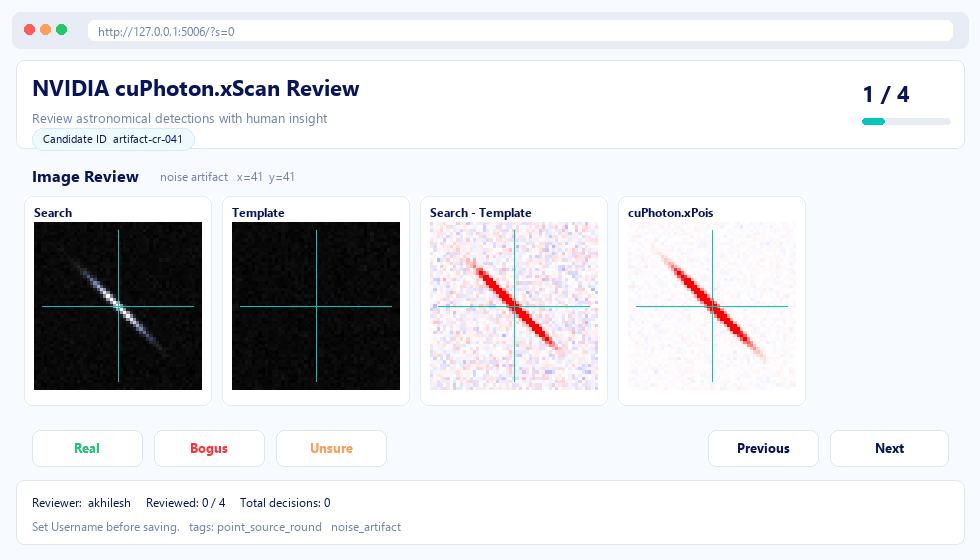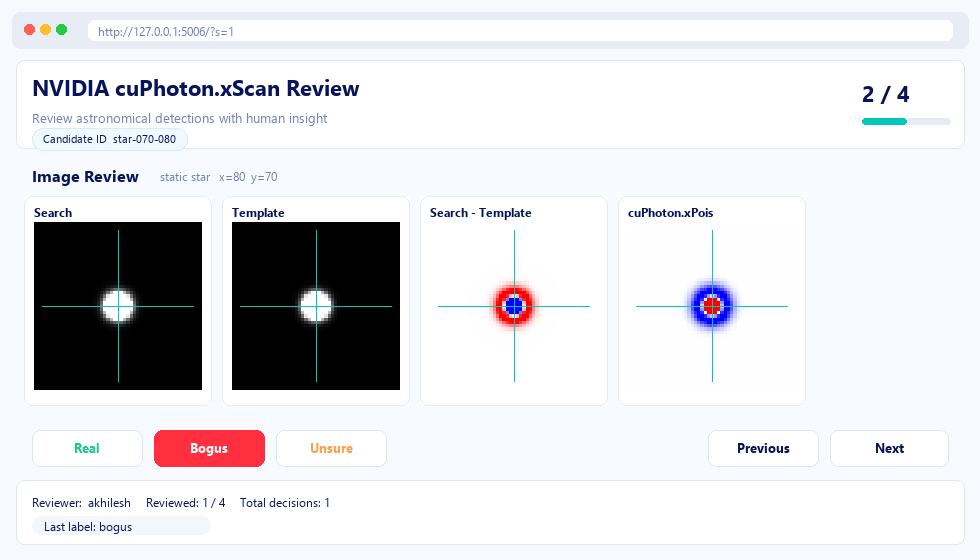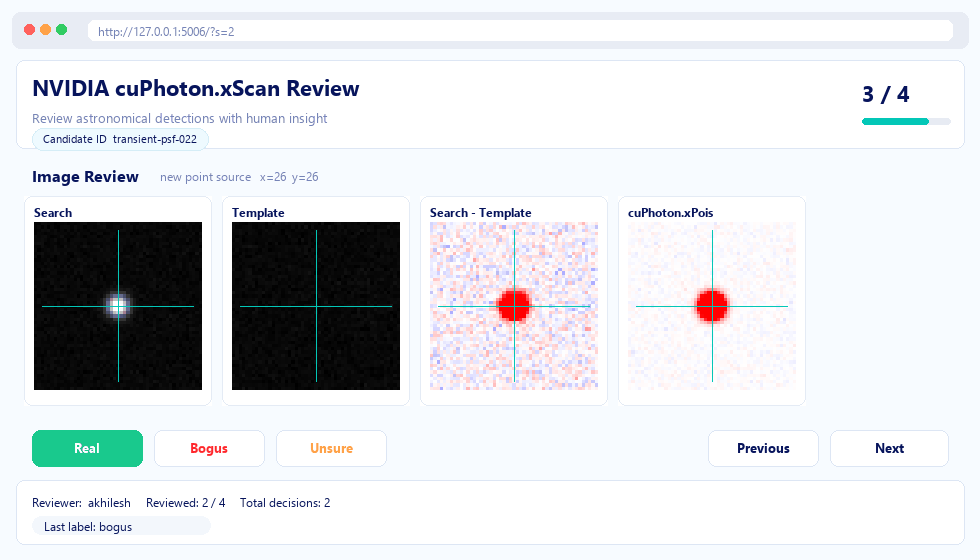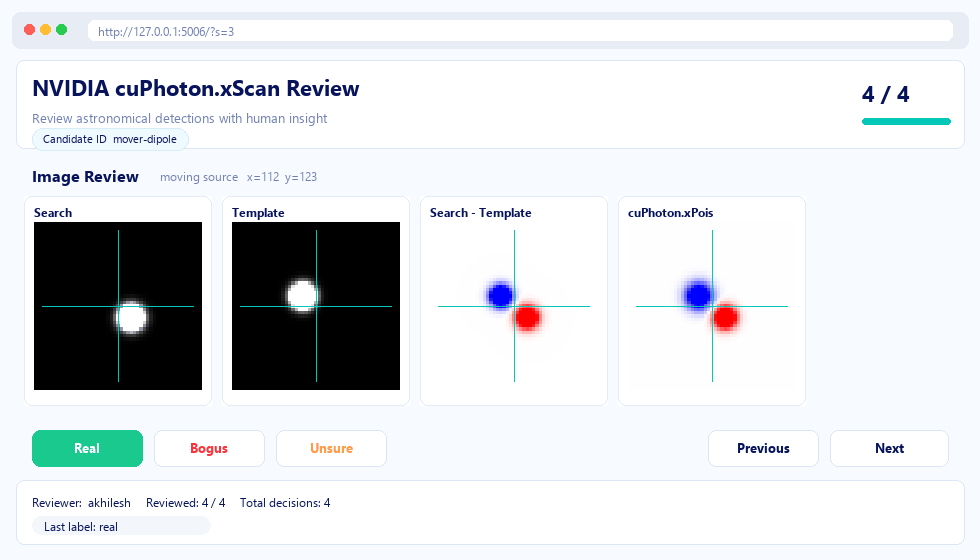
cuphoton xscan review-bokeh) hiển thị các bảng điều khiển tìm kiếm, mẫu, chênh lệch và xPois cùng các bộ điều khiển gán nhãn Real, Bogus và Unsure. Chạy cùng lệnh này trên các sản phẩm LSSTComCam hoặc HSC của bạn; cây git không bao gồm các pixel đóMở rộng cùng một quy trình làm việc trên nhiều GPU
The walkthrough above is one image pair on one GPU, small enough for an NVIDIA DGX Spark or a workstation. NVIDIA cuPhoton runs the same loading and processing path across multi-GPU, multi-node systems. After registration, cuPhoton distributes complete image pairs and their candidate coordinates across GPU workers, keeping image arrays on the device through subtraction, dipole fitting, and classification. This example uses synthetic inputs and an untrained model to verify a multi-GPU launch. Scaling that path is how the toolkit handles survey-sized streams such as Vera C. Rubin Observatory exposures. To run many pairs, use the following commands. Environment setup, Slurm and SSH launches, and the Dragon alternative are in the distributed execution guide.
python examples/distributed-pipeline/prepare_example.py \
  --output "$CUPHOTON_RUN_ROOT/input" --images 8

export CUDA_VISIBLE_DEVICES="${CUDA_VISIBLE_DEVICES-0,1,2,3}"
mpiexec -n 8 --map-by ppr:4:node --bind-to none \
  -x CUDA_VISIBLE_DEVICES \
  cuphoton-openmpi-rank-exec -- \
  cuphoton xscan run-pipeline --executor mpi \
  --manifest "$CUPHOTON_RUN_ROOT/input/pipeline.json" \
  --output-dir "$CUPHOTON_RUN_ROOT/runs" --name blog-mpi \
  --warmup-rounds 1 --measure-rounds 1
--images 8 creates eight image pairs, and -n 8 starts eight MPI workers, mapped one per GPU. The pairs must already share a pixel grid, which is the xRep step above. On a machine with one GPU per node, set both numbers to the node count and use --map-by ppr:1:node. Those commands come from the distributed-pipeline example, which also includes the host-file templates. The generated model only checks that the workers start and finish.
Bắt đầu triển khai
Các ví dụ được phát triển trên NVIDIA DGX Spark và nhắm đến các hệ thống Linux có GPU và trình điều khiển NVIDIA tương thích. Làm theo cuPhoton README để sao chép kho lưu trữ, kiểm tra các phiên bản Python và CUDA được hỗ trợ, và thiết lập môi trường.
- Xây dựng phần mở rộng xDataReader native cho đầu vào FITS: hướng dẫn xDataReader.
- Chạy tải và xử lý dữ liệu trên nhiều GPU và nút: hướng dẫn thực thi phân tán.
- Create a review queue and launch the candidate review interface: xScan guide.
- Explore component APIs and output artifact specifications: cuPhoton documentation.
For related examples, read Accelerated X-Ray Analysis for Nanoscale Imaging (XANI) and Using Accelerated Computing to Live-Steer Scientific Experiments at Massive Research Facilities.
Xem video giới thiệu tổng quan về sản phẩm NVIDIA cuPhoton để tìm hiểu về bộ công cụ.
Bài viết liên quan
- Xác nhận mức độ sẵn sàng của cụm GPU trước khi triển khai các tác vụ AI
- Mở rộng khả năng nhận diện trên các nền tảng AV với NVIDIA Omniverse NuRec
- NVIDIA ra mắt nền tảng Jetson Thor mới để thúc đẩy phát triển robotics đại trà và AI tại biên
- Cách sử dụng AI Agents để chuẩn bị cảnh 3D cho mô phỏng
- CUDA Toolkit 13.4 bổ sung hỗ trợ Windows trên kiến trúc Arm và khả năng kiểm soát tốt hơn đối với GPU dùng chung.