Phát triển xe tự hành (AV) thường dựa vào các mô hình riêng biệt cho việc tạo quỹ đạo, dự đoán ý định cấp cao, hiểu biết bối cảnh, và gắn nhãn dữ liệu. Sự tách biệt này làm khó so sánh các đầu ra liên quan, điều tra hành vi mô hình, và tái sử dụng các biểu diễn giống nhau xuyên suốt quy trình phát triển.
NVIDIA Alpamayo 2 Super là một mô hình lý luận thị giác-ngôn-hành động (VLA) mở 34 tỷ tham số được thiết kế để tăng tốc phát triển xe tự hành (AV) . Nó kết hợp NVIDIA Cosmos 3 Super Reasoner 32 tỷ tham số với Action Expert dựa trên khuếch tán 2 tỷ tham số và được huấn luyện sau với học tăng cường. Reasoner diễn giải video đa camera, ngữ cảnh ngôn ngữ, và lịch sử chuyển động trước đó, trong khi Action Expert chuyển đổi biểu diễn nội bộ kết quả của mô hình thành quỹ đạo tương lai của xe ego.
Nhận thức của Alpamayo 2 Super mở rộng đến vùng phủ 360 độ trên tối đa bảy camera và có thể trả về nhiều đầu ra bổ sung: quỹ đạo tương lai, dấu vết lý luận Chuỗi-Nhân-Quả (CoC), meta-hành động cấp cao, câu trả lời có cơ sở cho các câu hỏi về cảnh, và nhãn tự động lý luận.
Thiết kế đa nhiệm này cung cấp cho các nhà phát triển AV một nền tảng chung xuyên suốt nhiều giai đoạn của quy trình phát triển. Cùng một mô hình nền tảng có thể được sử dụng làm giáo viên chính sách ngoại tuyến, nhà phê bình đánh giá, công cụ dữ liệu, hoặc điểm xuất phát cho tùy chỉnh nhiệm vụ mới, thay vì duy trì một mô hình riêng biệt cho mỗi giai đoạn của quy trình.
Bài đăng này cung cấp giới thiệu thực hành về bốn quy trình làm việc được kích hoạt bởi Alpamayo 2 Super:
- Tạo quỹ đạo và vết dấu lý luận CoC, đánh giá kết quả trong các benchmark vòng mở và vòng kín.
- Dự đoán các hành động meta như nhường, đổi làn, và dừng cạnh một quỹ đạo.
- Đặt câu hỏi ngôn ngữ tự nhiên về một cảnh lái xe đa camera.
- Tạo nhãn tự động CoC với căn chỉnh 2D trên các clip của bạn.
Các trọng số mô hình có sẵn trên Hugging Face và các sổ tay suy luận trên GitHub. Mô hình được phát hành theo giấy phép OpenMDW-1.1, giấy phép cho phép của Linux Foundation cho phân phối mô hình mở, bao gồm tinh chỉnh, mô hình phái sinh, và phân phối lại thương mại. Các mô hình chưng cất có thể được triển khai thương mại mà không cần thêm sự cho phép từ NVIDIA, và đầu ra mô hình không mang điều kiện giấy phép.
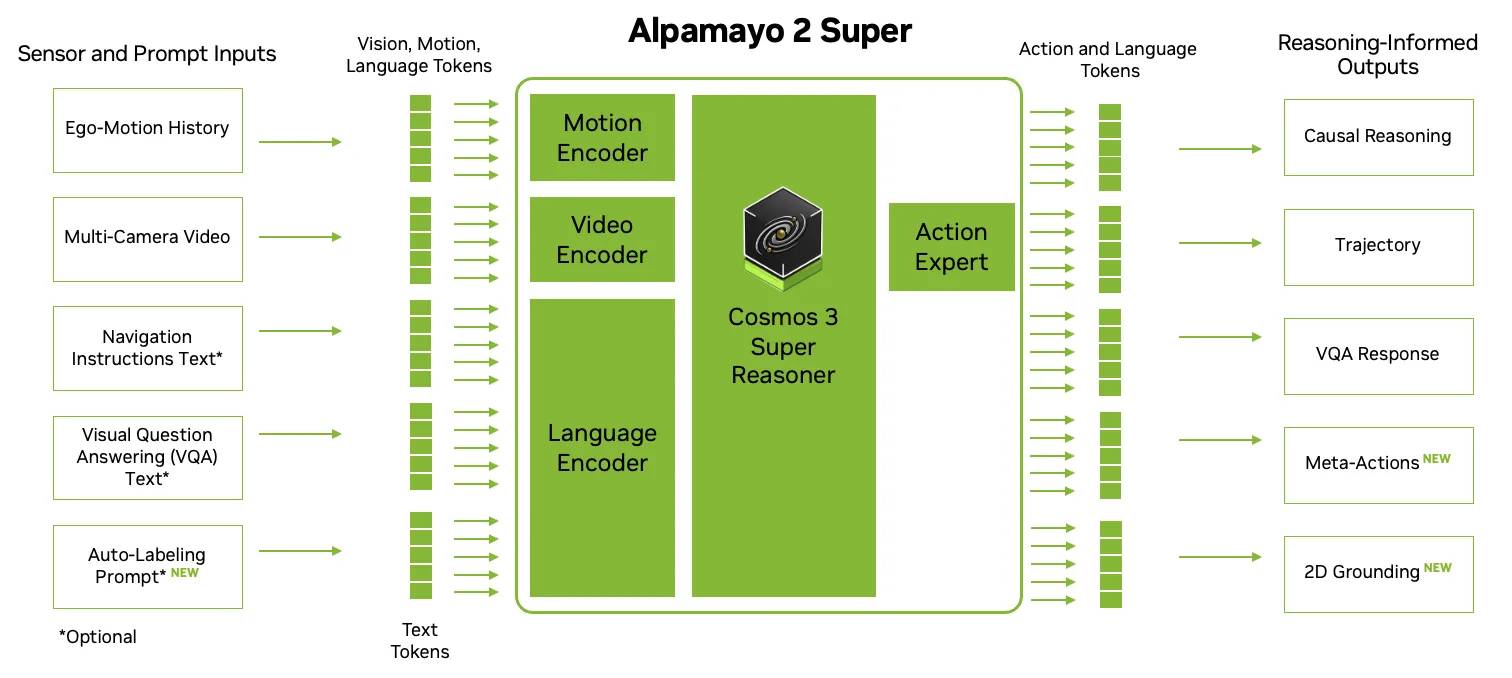
Hình 1. Alpamayo 2 Super xử lý đầu vào đa phương thức thông qua một Cosmos 3 Super Reasoner 32B và một Action Expert 2B
Lập kế hoạch và lý luận
Lý luận qua các kịch bản mới là một vấn đề cơ bản trong lái xe tự động. Điều hướng qua các khu vực thi công, người đi bộ bị che khuất một phần, các tương tác quyền ưu tiên bất thường, và các vật thể đi vào đường đòi hỏi nhiều hơn là khớp với một mẫu quỹ đạo chung. Một mô hình lái xe hữu ích phải xác định ngữ cảnh cảnh quan quan trọng, kết nối nó với quyết định lái xe phù hợp, và tạo ra một hành động nhất quán với quyết định đó.
Quỹ đạo và dấu vết CoC: Cái gì và tại sao
Alpamayo 2 Super, giống như các phiên bản trước, cùng tạo ra các quỹ đạo đầu ra và dấu vết lý luận CoC. Quỹ đạo thể hiện những gì xe ego có thể làm tiếp theo. Dấu vết lý luận CoC cung cấp cái nhìn sâu sắc vào tại sao một quyết định lái xe được đưa ra từ ngữ cảnh cảnh quan quan sát được. Trả về cả hai đầu ra làm cho dễ hiểu hơn quá trình ra quyết định của mô hình, tuyển chọn các trường hợp khó khăn, so sánh một chính sách đã triển khai với một giáo viên lớn hơn, và chẩn đoán xem lỗi có bắt nguồn từ nhận thức, lý luận hay tạo hành động không. Dấu vết CoC cũng được đưa vào quy trình xác nhận an toàn NVIDIA Halos bằng cách cho phép tự kiểm tra vào hiểu biết của mô hình về cảnh quan.
Kho lưu trữ của Alpamayo 2 Super’s notebook suy luận tải một clip toàn cảnh, chuẩn bị lịch sử chuyển động ego, và lấy mẫu một quỹ đạo với dấu vết CoC liên quan. Bước suy luận cốt lõi và các đầu ra được hiển thị dưới đây.
from alpamayo2_super import helper
from alpamayo2_super.load_physical_aiavdataset import load_physical_aiavdataset
from alpamayo2_super.models.alpamayo2_super import Alpamayo2Super
from alpamayo2_super.visualization import plot_inference_result

data = load_physical_aiavdataset(
  "030c760c-ae38-49aa-9ad8-f5650a545d26",
   t0_us=2000000,
)

model = Alpamayo2Super.from_pretrained("nvidia/Alpamayo2-Super", dtype=torch.bfloat16, device_map="cuda:0")
model_inputs = helper.prepare_model_inputs(data, model.config, model.tokenizer)
model_inputs = helper.to_device(model_inputs, "cuda")

torch.cuda.manual_seed_all(42)
with torch.autocast("cuda", dtype=torch.bfloat16):
   pred_xyz, pred_rot, logprob, extra = model.sample_trajectories_from_data(
       data=model_inputs,
       top_p=0.98,
       temperature=0.6,
       num_traj_samples=1,
       diffusion_kwargs={"inference_step": 10},
       return_extra=True,
   )

fig, metadata = plot_inference_result(
   data=data,
   pred_xyz=pred_xyz,
   extra=extra,
)
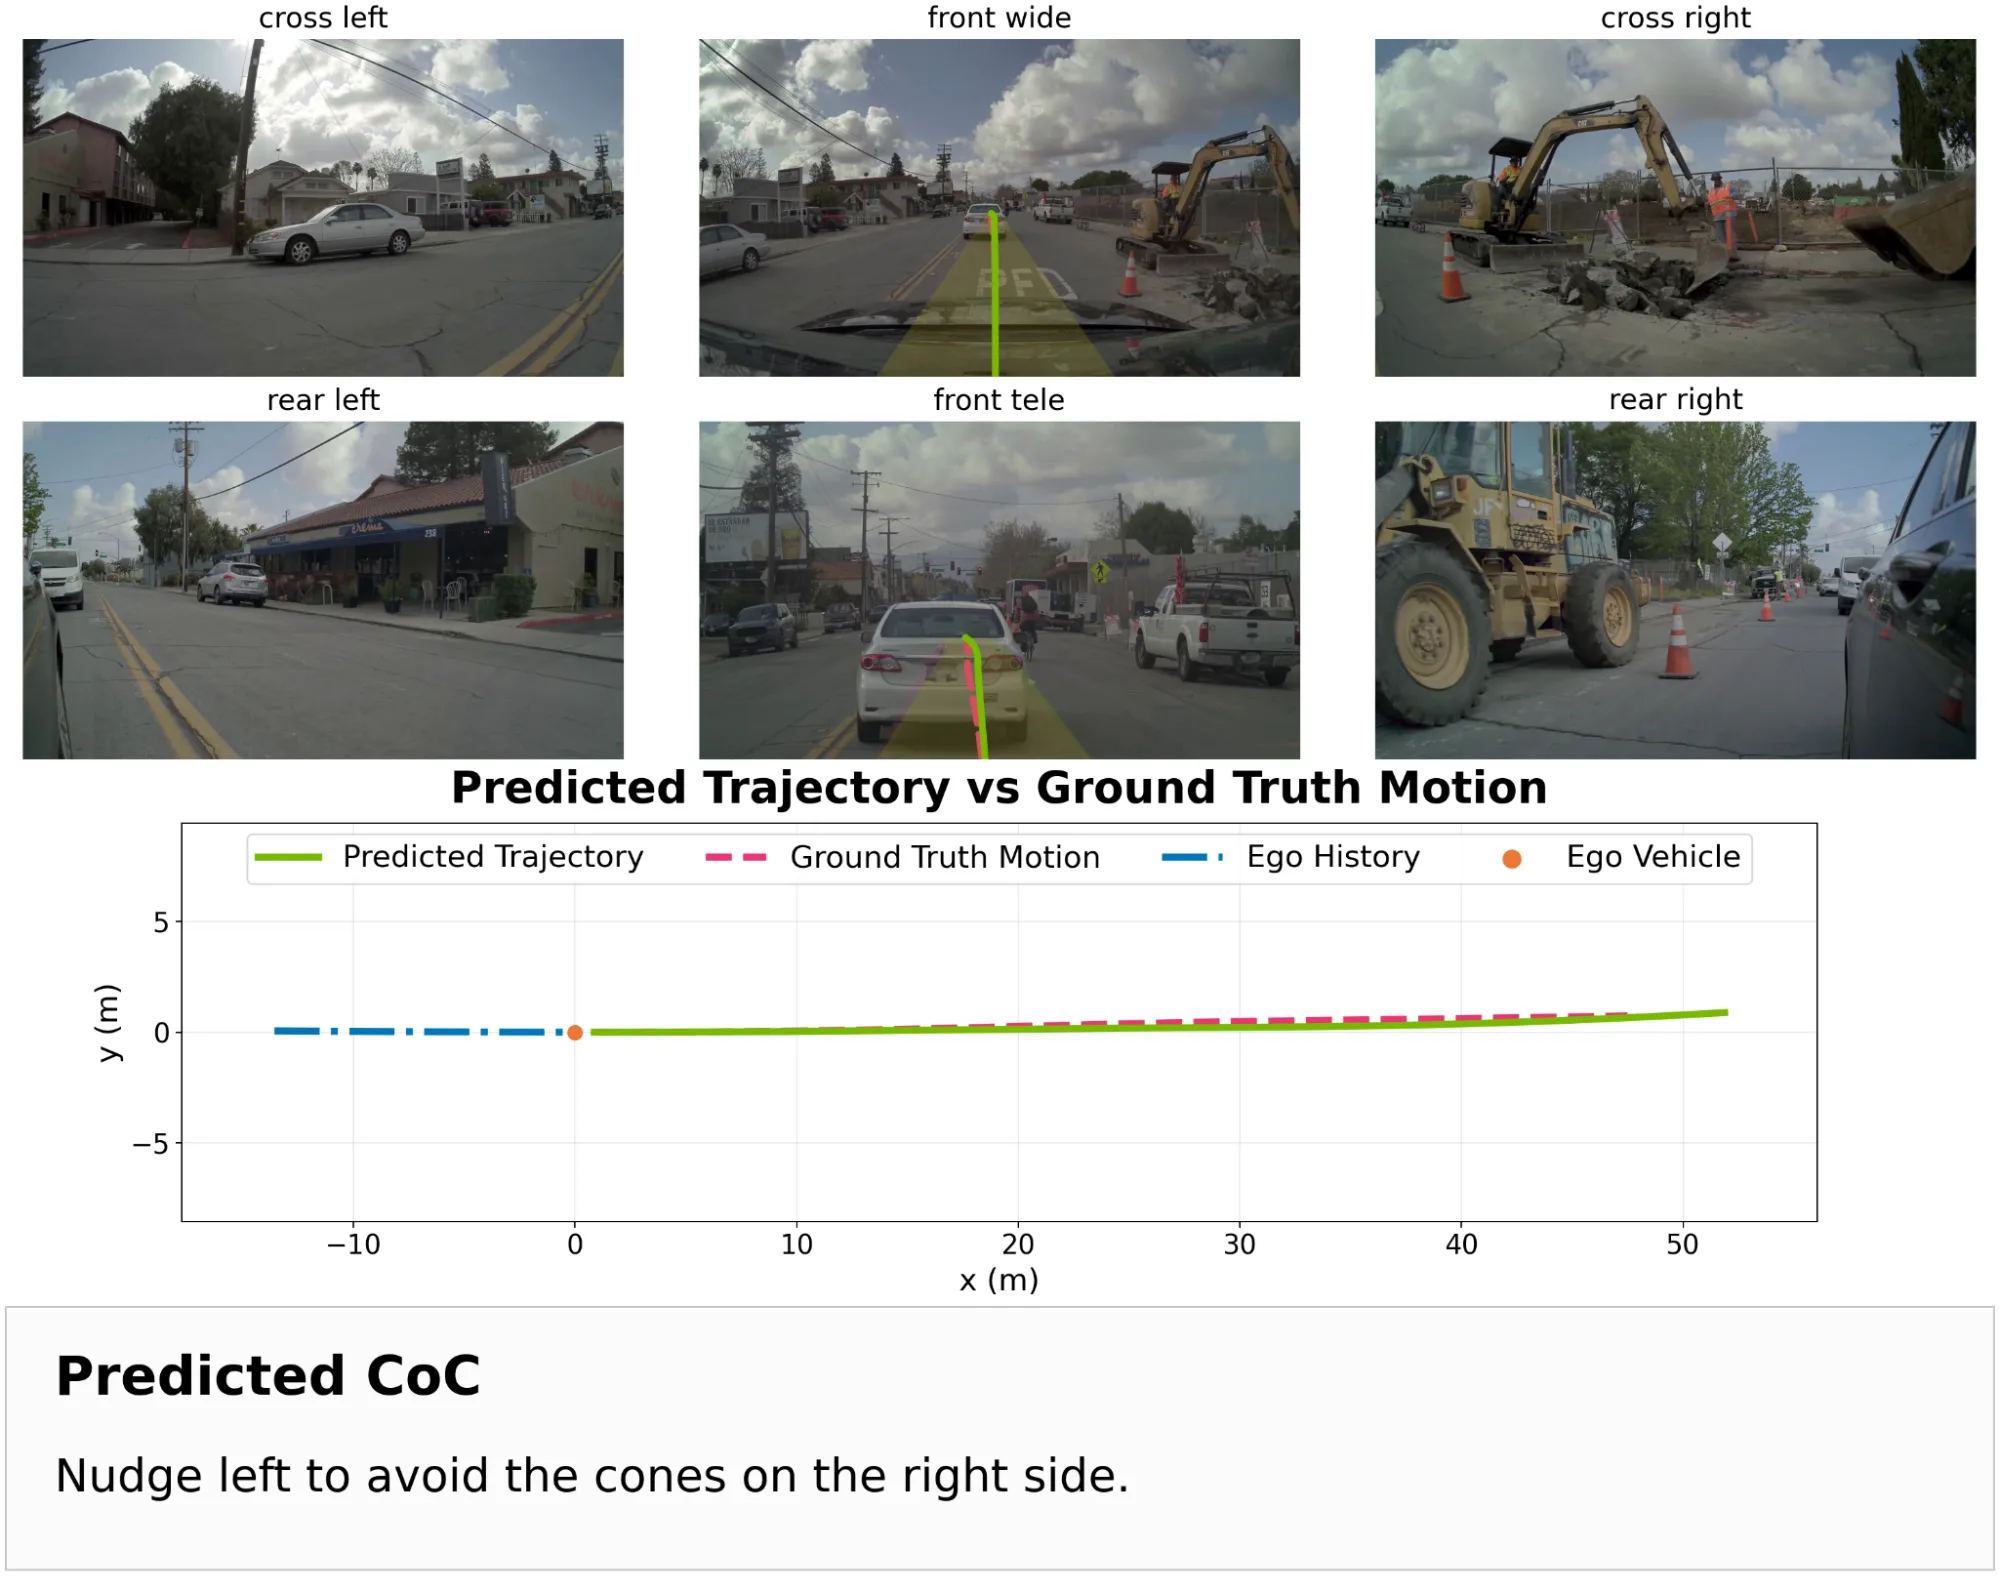
Hình 2. Alpamayo 2 Super lập kế hoạch trong một cảnh thách thức
Phương pháp đánh giá
Để đánh giá chất lượng lý luận và quỹ đạo đầu ra của mô hình, chúng ta có thể sử dụng các phương pháp đánh giá vòng mở và vòng kín. Đánh giá vòng mở đo lường chất lượng quỹ đạo và lý luận trên các cảnh đã ghi bằng cách so sánh chúng với nhãn ground-truth.
Alpamayo 2 Super đạt được các kết quả sau:
- Dự đoán quỹ đạo: Trên 1,434 mẫu thử thách từ Physical AI AV Dataset, nó ghi nhận
minADE_66,4 giây là 0,911 m. - Lý luận AV: Nó đạt 0,433 trên Physical AI AV Reasoning Benchmark.
- LingoQA: Alpamayo 2 Super đạt 79,2 trên LingoQA benchmark, xếp hạng đầu tiên trong số 37 mô hình được đánh giá. Với 34 tỷ tham số, nó dẫn trước Qwen2.5-VL (72B) 17,0 điểm, Qwen3-VL (32B) 7,0 điểm, Gemini 2.5 Pro 15,1 điểm, và GPT-4o 23,2 điểm.
Giá trị minADE_6 thấp hơn cho thấy dự đoán quỹ đạo tốt hơn; điểm lý luận cao hơn cho thấy hiệu suất tốt hơn.
Thách thức chính với các phép đo vòng mở, tuy nhiên, là chúng đánh giá dựa trên một tương lai cố định, được ghi sẵn và do đó không ghi nhận những gì xảy ra sau hành động đầu tiên của mô hình, điều này có thể ảnh hưởng đến phần còn lại của cảnh.
Ví dụ, nếu xe tự hành đổi làn, một phát lại vòng mở có thể tiếp tục di chuyển xe lân cận theo quỹ đạo đã ghi của nó thay vì tính đến cách nó sẽ phản ứng với xe tự hành.
Mô phỏng vòng kín thực thi mỗi hành động dự đoán trong cảnh và, khi mô phỏng bao gồm các mô hình hành vi phản ứng, ghi nhận cách các tác nhân xung quanh có thể phản ứng. NVIDIA AlpaSim cho phép điều này bằng cách liên tục kết xuất quan sát, truy vấn chính sách và áp dụng các hành động của nó để nhà phát triển có thể đo lường các hiệu ứng vòng kín này theo thời gian.
Để chạy Alpamayo 2 Super trên bộ đánh giá AlpaSim, sử dụng lệnh shell tương ứng:
uv run alpasim_wizard deploy=local topology=2gpu driver=alpamayo2
wizard.log_dir=$PWD/tutorial eval.video.video_layouts=[REASONING_OVERLAY]
với cấu hình trình hướng dẫn AlpaSim sau:
# Should be used in defaults list, e.g.
# - /driver: alpamayo2
# Type validation happens at driver runtime via OmegaConf.structured merge

defaults:
  - alpamayo_configs    # Camera and simulation configs for 4-cam 10Hz
  - _self_                      # YAML values override schema defaults

# Alpamayo 2 Super Driver Configuration for Alpasim

# Logging level (uses wizard's global setting)
log_level: ${wizard.log_level}

# Model configuration
model:
  model_type: alpamayo2  # Entry-point name in alpasim.models registry
  # HuggingFace model ID (requires cached download or hf authentication in the driver container)
  checkpoint_path: "nvidia/Alpamayo2-Super"
  # # Alternative local path to a pre-downloaded model
  # checkpoint_path: "/mnt/drivers/alpamayo2/Alpamayo2-Super"
  device: "cuda"
  # Enable classifier-free guidance navigation sampling (NOTE: this requires 2 GPUs with at least 70 GB VRAM).
  # Set to true only when sufficient GPU memory is available.
  use_classifier_free_guidance_nav: false

# Server configuration
host: "0.0.0.0"
port: ???

# Inference configuration
inference:
  use_cameras:
     - camera_cross_left_120fov
     - camera_front_wide_120fov
     - camera_cross_right_120fov
     - camera_front_tele_30fov
  max_batch_size: 1  # A2Super is memory intensive, start with batch size 1
  subsample_factor: 1
  context_length: 4  # A2Super uses 4 temporal frames per camera

# Route configuration — A2Super uses language-only navigation, not waypoint commands
route:
  use_waypoint_commands: false

# Output configuration
output_dir: "/mnt/output/driver"

# Trajectory optimization (disabled by default for A2Super)
trajectory_optimizer:
  enabled: false

plot_debug_images: false
Video 1. Alpamayo 2 Super lái xe vòng kín trong AlpaSim, điều hướng giao thông đông đúc bên cạnh khu vực xây dựng
Trên 913 cảnh được tái tạo, Alpamayo 2 Super đạt được AlpaSim Score là 1.50 ± 0.13. Điểm vòng kín này bổ sung cho kết quả vòng hở bằng cách tiết lộ va chạm, chệch đường, tiếp cận gần, và các lỗi khác chỉ có thể xuất hiện sau khi chính sách ảnh hưởng đến quan sát trong tương lai.
| Đánh giá | Điểm chuẩn (tập hợp) | Chỉ số | Alpamayo 2 Super | Điểm tham chiếu | Tốt hơn |
| Vòng mở | Physical AI AV Dataset (1,434 các mẫu thách thức) | minADE_6 @ 6.4 giây (m) | 0,911m | Alpamayo 1.5 Nano: 0,916m | Thấp hơn |
| Vòng lặp mở | Physical AI AV Benchmarks lý luận | Điểm lý luận | 0.433 | Alpamayo 1.5 Nano: 0.414 GPT-5.5: 0.502 | cao hơn |
| vòng lặp mở | LingoQA | Điểm Lingo-Judge | 79.2 | Alpamayo 1.5 Nano: 74.2 Qwen3-VL 32B: 72.2Qwen2.5-VL 72B: 62.2 Gemini 2.5 Pro: 64.1GPT-4o: 56.0 |
Cao hơn |
| Vòng kín | AlpaSim (913 cảnh tái tạo từ Physical AI AV NuRec tập dữ liệu) | Điểm AlpaSim | 1.50 ± 0.13 | Alpamayo 1.5 Nano: 1.37 ± 0.10 | Cao hơn |
Hành động meta
Đường đi chính xác, nhưng không phải lúc nào cũng cung cấp mô tả ngắn gọn về ý định. Các hành động meta tóm tắt kế hoạch theo các quyết định cấp cao như nhường đường, đổi làn, dừng, hoặc tăng tốc. Các đầu ra này có thể giúp kết nối mô hình nền tảng end-to-end và ngăn xếp AV mô-đun: một trình lập kế hoạch hạ nguồn có thể sử dụng quyết định, một trình đánh giá có thể kiểm tra xem hình học đường đi có phù hợp với ý định không, và các nhóm có thể tìm kiếm kho dữ liệu của họ cho các thao tác cụ thể.
Tạo các meta-hành động
Sổ tay meta-hành động cho thấy cách tạo ra đầu ra meta-hành động với một cảnh ví dụ. Để biết danh sách chi tiết các meta-hành động được hỗ trợ, hãy tham khảo các danh sách này. Bước suy luận cốt lõi và đầu ra được hiển thị bên dưới.
from alpamayo2_super import helper
from alpamayo2_super.load_physical_aiavdataset import load_physical_aiavdataset
from alpamayo2_super.models.alpamayo2_super import Alpamayo2Super
from alpamayo2_super.text_tasks import generate_text, prepare_text_generation_inputs

data = load_physical_aiavdataset(
  "030c760c-ae38-49aa-9ad8-f5650a545d26",
   t0_us=2000000,
)

model = Alpamayo2Super.from_pretrained("nvidia/Alpamayo2-Super", dtype=torch.bfloat16, device_map="cuda:0")
task_inputs = prepare_text_generation_inputs(
   data=data,
   model_config=model.config,
   tokenizer=model.tokenizer,
   task="meta_action",
)
task_inputs = helper.to_device(task_inputs, "cuda")

torch.cuda.manual_seed_all(42)
with torch.autocast("cuda", dtype=torch.bfloat16):
   result = generate_text(
       model,
       task_inputs,
       top_p=0.98,
       temperature=0.6,
       max_new_tokens=512,
   )

cot = result["cot"][0]
meta_action = result["meta_action"][0]
print("Chain-of-Causation:\n", cot)
print("\nMeta-action:\n", meta_action)
Đánh giá độ chính xác meta-hành động
Để đánh giá độ chính xác meta-hành động, chúng tôi so sánh đầu ra của Alpamayo 2 Super với các nhãn ground-truth và báo cáo độ chính xác phân loại kết quả dưới dạng intersection-over-union (IoU) cho ba thành phần của taxonomy meta-hành động của nó: ngang, dọc, và theo làn đường.
Trên một bộ 94K clip nội bộ với dữ liệu meta-action ground-truth, Alpamayo 2 Super đạt 74.59 IoU ngang, 61.91 IoU dọc, và 73.55 IoU theo làn đường trong taxonomy meta-action của nó.
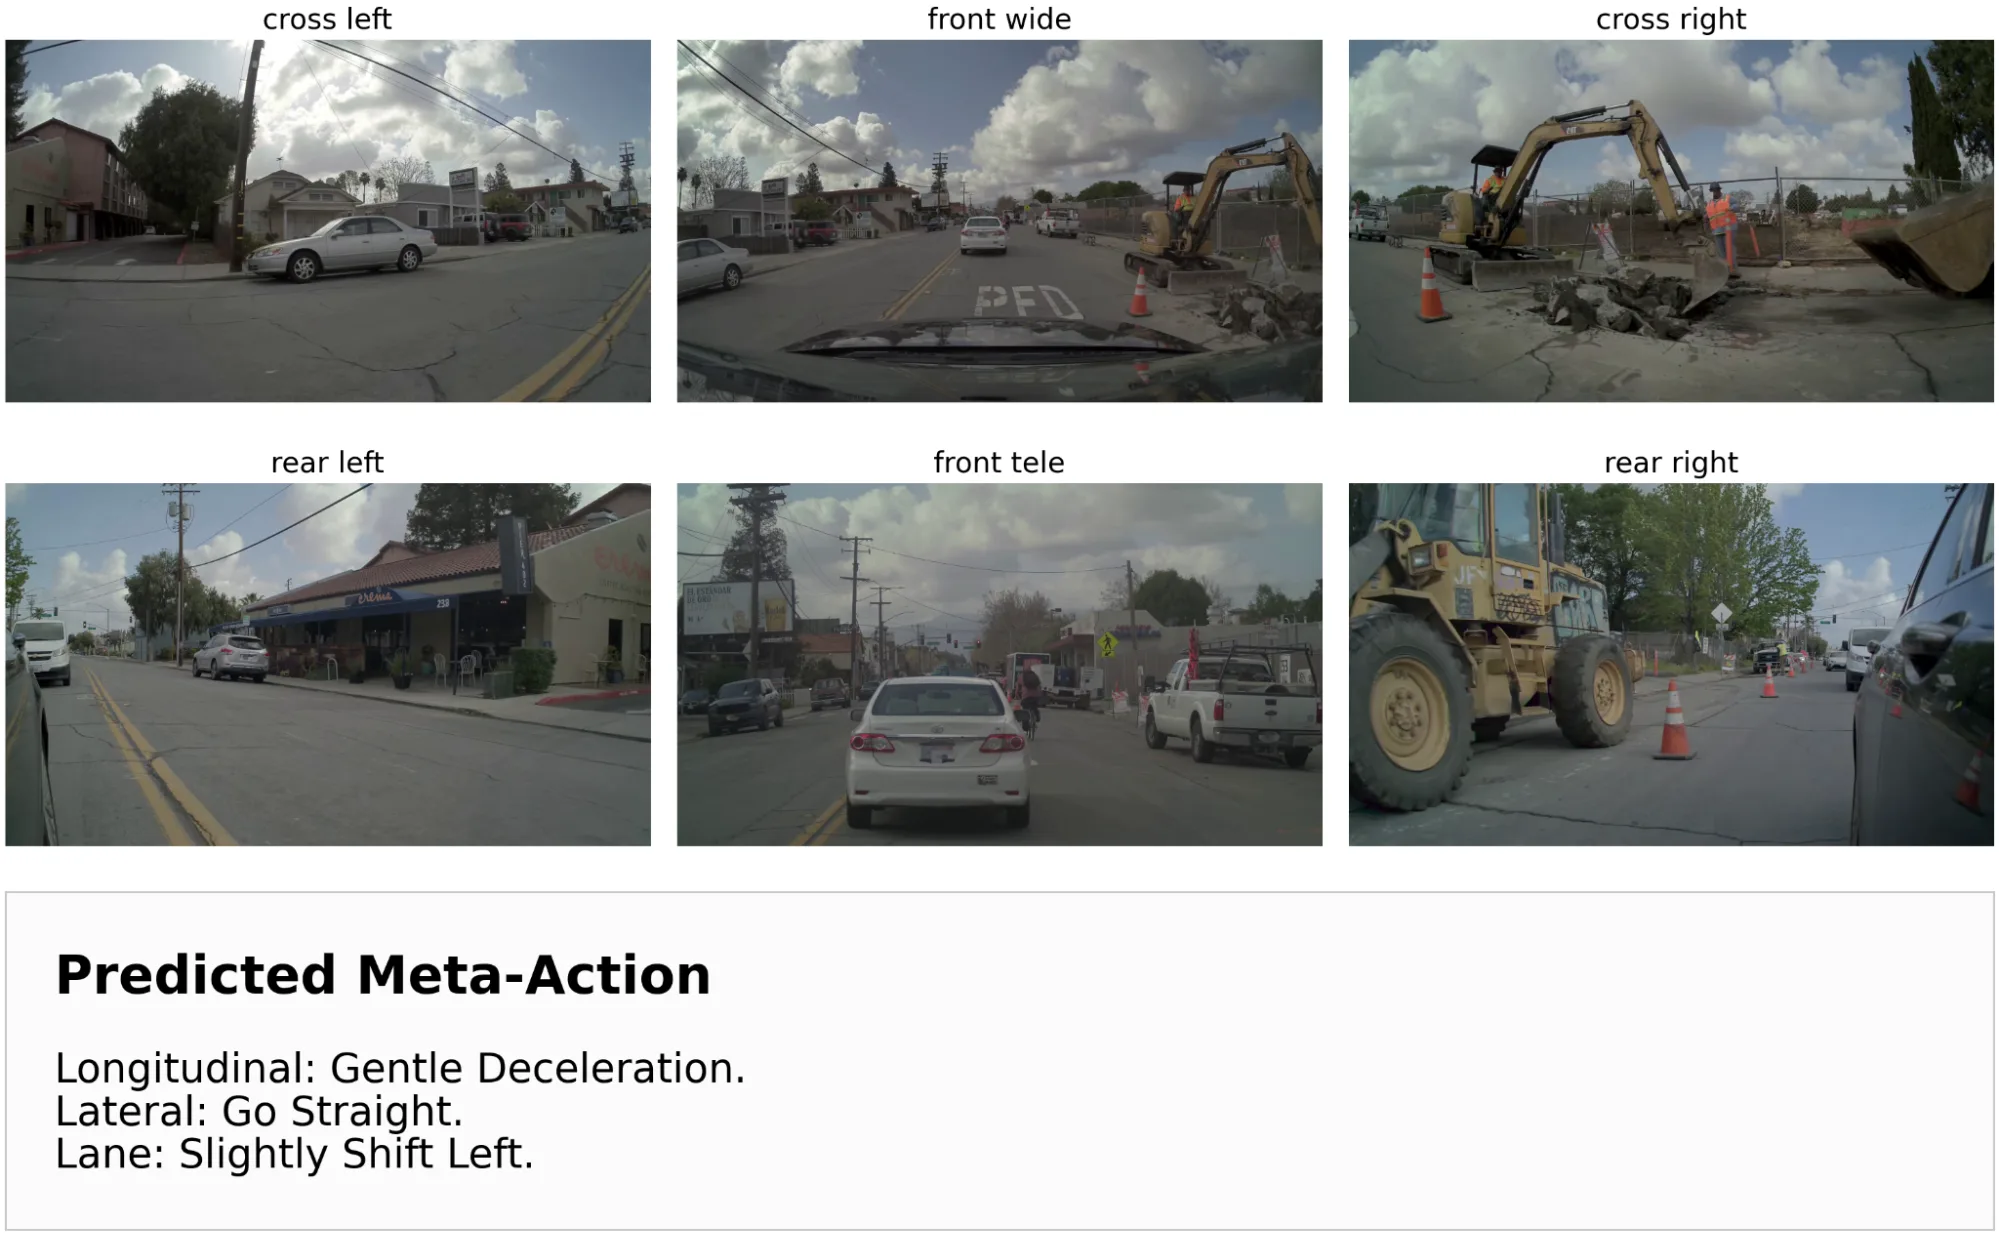
Hình 3. Đầu ra hiển thị một meta-action cho kịch bản tương ứng
Hiểu biết cảnh
Lập kế hoạch chỉ là một cách để sử dụng mô hình nền tảng lái xe. Trả lời câu hỏi trực quan (VQA) trực tiếp thể hiện hiểu biết cảnh của mô hình thông qua ngôn ngữ tự nhiên. Nhà phát triển có thể hỏi về các yếu tố chính trong cảnh, chúng ảnh hưởng đến hành vi lái xe như thế nào, tại sao xe ego nên giảm tốc, hoặc về các khía cạnh khác của kịch bản.
khoảng cách ne-change.
VQA có giá trị cho gỡ lỗi tương tác và hoạt động dữ liệu. Nó có thể giúp nhà phát triển kiểm tra tại sao chính sách hoạt động theo một cách nhất định, xây dựng các bộ lọc ngữ nghĩa trên bộ sưu tập clip lớn, và tạo các chú thích ứng viên cho đánh giá của con người. Với đầu vào hình ảnh bao quanh, các câu hỏi có thể tham chiếu ngữ cảnh bên hông và phía sau mà mô hình chỉ có hình ảnh phía trước sẽ bỏ lỡ.
Truy vấn các cảnh đa camera với VQA và neo 2D
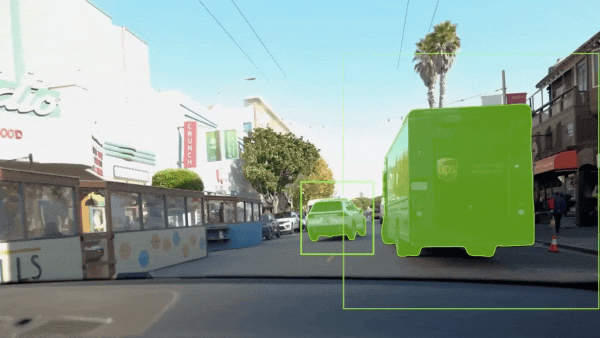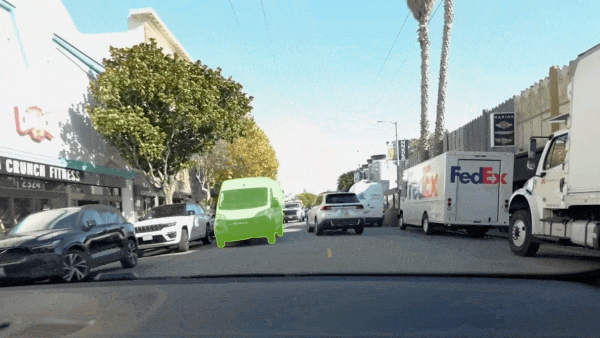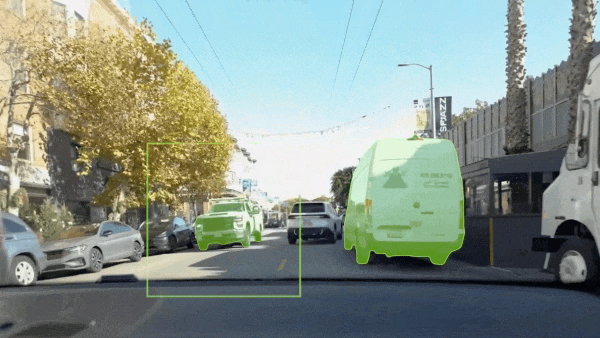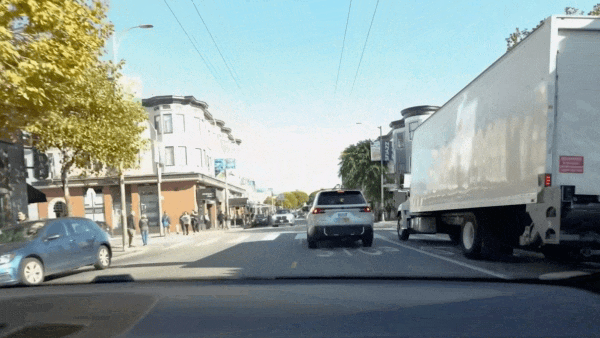
Đối với mỗi clip, Alpamayo 2 Super có thể tạo câu trả lời và xác định vị trí không gian các diễn viên được tham chiếu bằng cách dự đoán các hộp giới hạn 2D trong các khung hình camera liên quan. Việc neo này làm cho đầu ra hữu ích hơn so với văn bản tự do một mình. Người đánh giá có thể xác minh đối tượng cụ thể nào mà mô hình đang tham chiếu, kiểm tra tự động có thể gắn cờ các hộp bị thiếu hoặc không nhất quán, và các mô hình hạ nguồn có thể tận dụng (ví dụ, thông qua chưng cất) các liên kết chặt chẽ hơn giữa bằng chứng trực quan, lý luận và hành động.
Sổ tay hiểu cảnh và VQA cho thấy cách thực hiện VQA với cùng đầu vào. Bước suy luận cốt lõi và đầu ra được hiển thị bên dưới.
from alpamayo2_super import helper
from alpamayo2_super.load_physical_aiavdataset import load_physical_aiavdataset
from alpamayo2_super.models.alpamayo2_super import Alpamayo2Super
from alpamayo2_super.text_tasks import generate_text, prepare_text_generation_inputs

data = load_physical_aiavdataset(
  "ea4a6729-bf33-4997-905b-cd58774a3580",
   t0_us=7500000,
)

model = Alpamayo2Super.from_pretrained("nvidia/Alpamayo2-Super", dtype=torch.bfloat16, device_map="cuda:0")
task_inputs = prepare_vqa_inputs(
    data=data,
    model_config=model.config,
    tokenizer=model.tokenizer,
    question="Describe the driving scene and identify the key traffic elements that should influence ego behavior.",
)
task_inputs = helper.to_device(task_inputs, "cuda")
with torch.autocast("cuda", dtype=torch.bfloat16):
    result = generate_text(
        model,
        task_inputs,
        top_p=1.0,
        temperature=0.1,
        max_new_tokens=1024,
    )
answer = result["answer"][0]
print(answer)
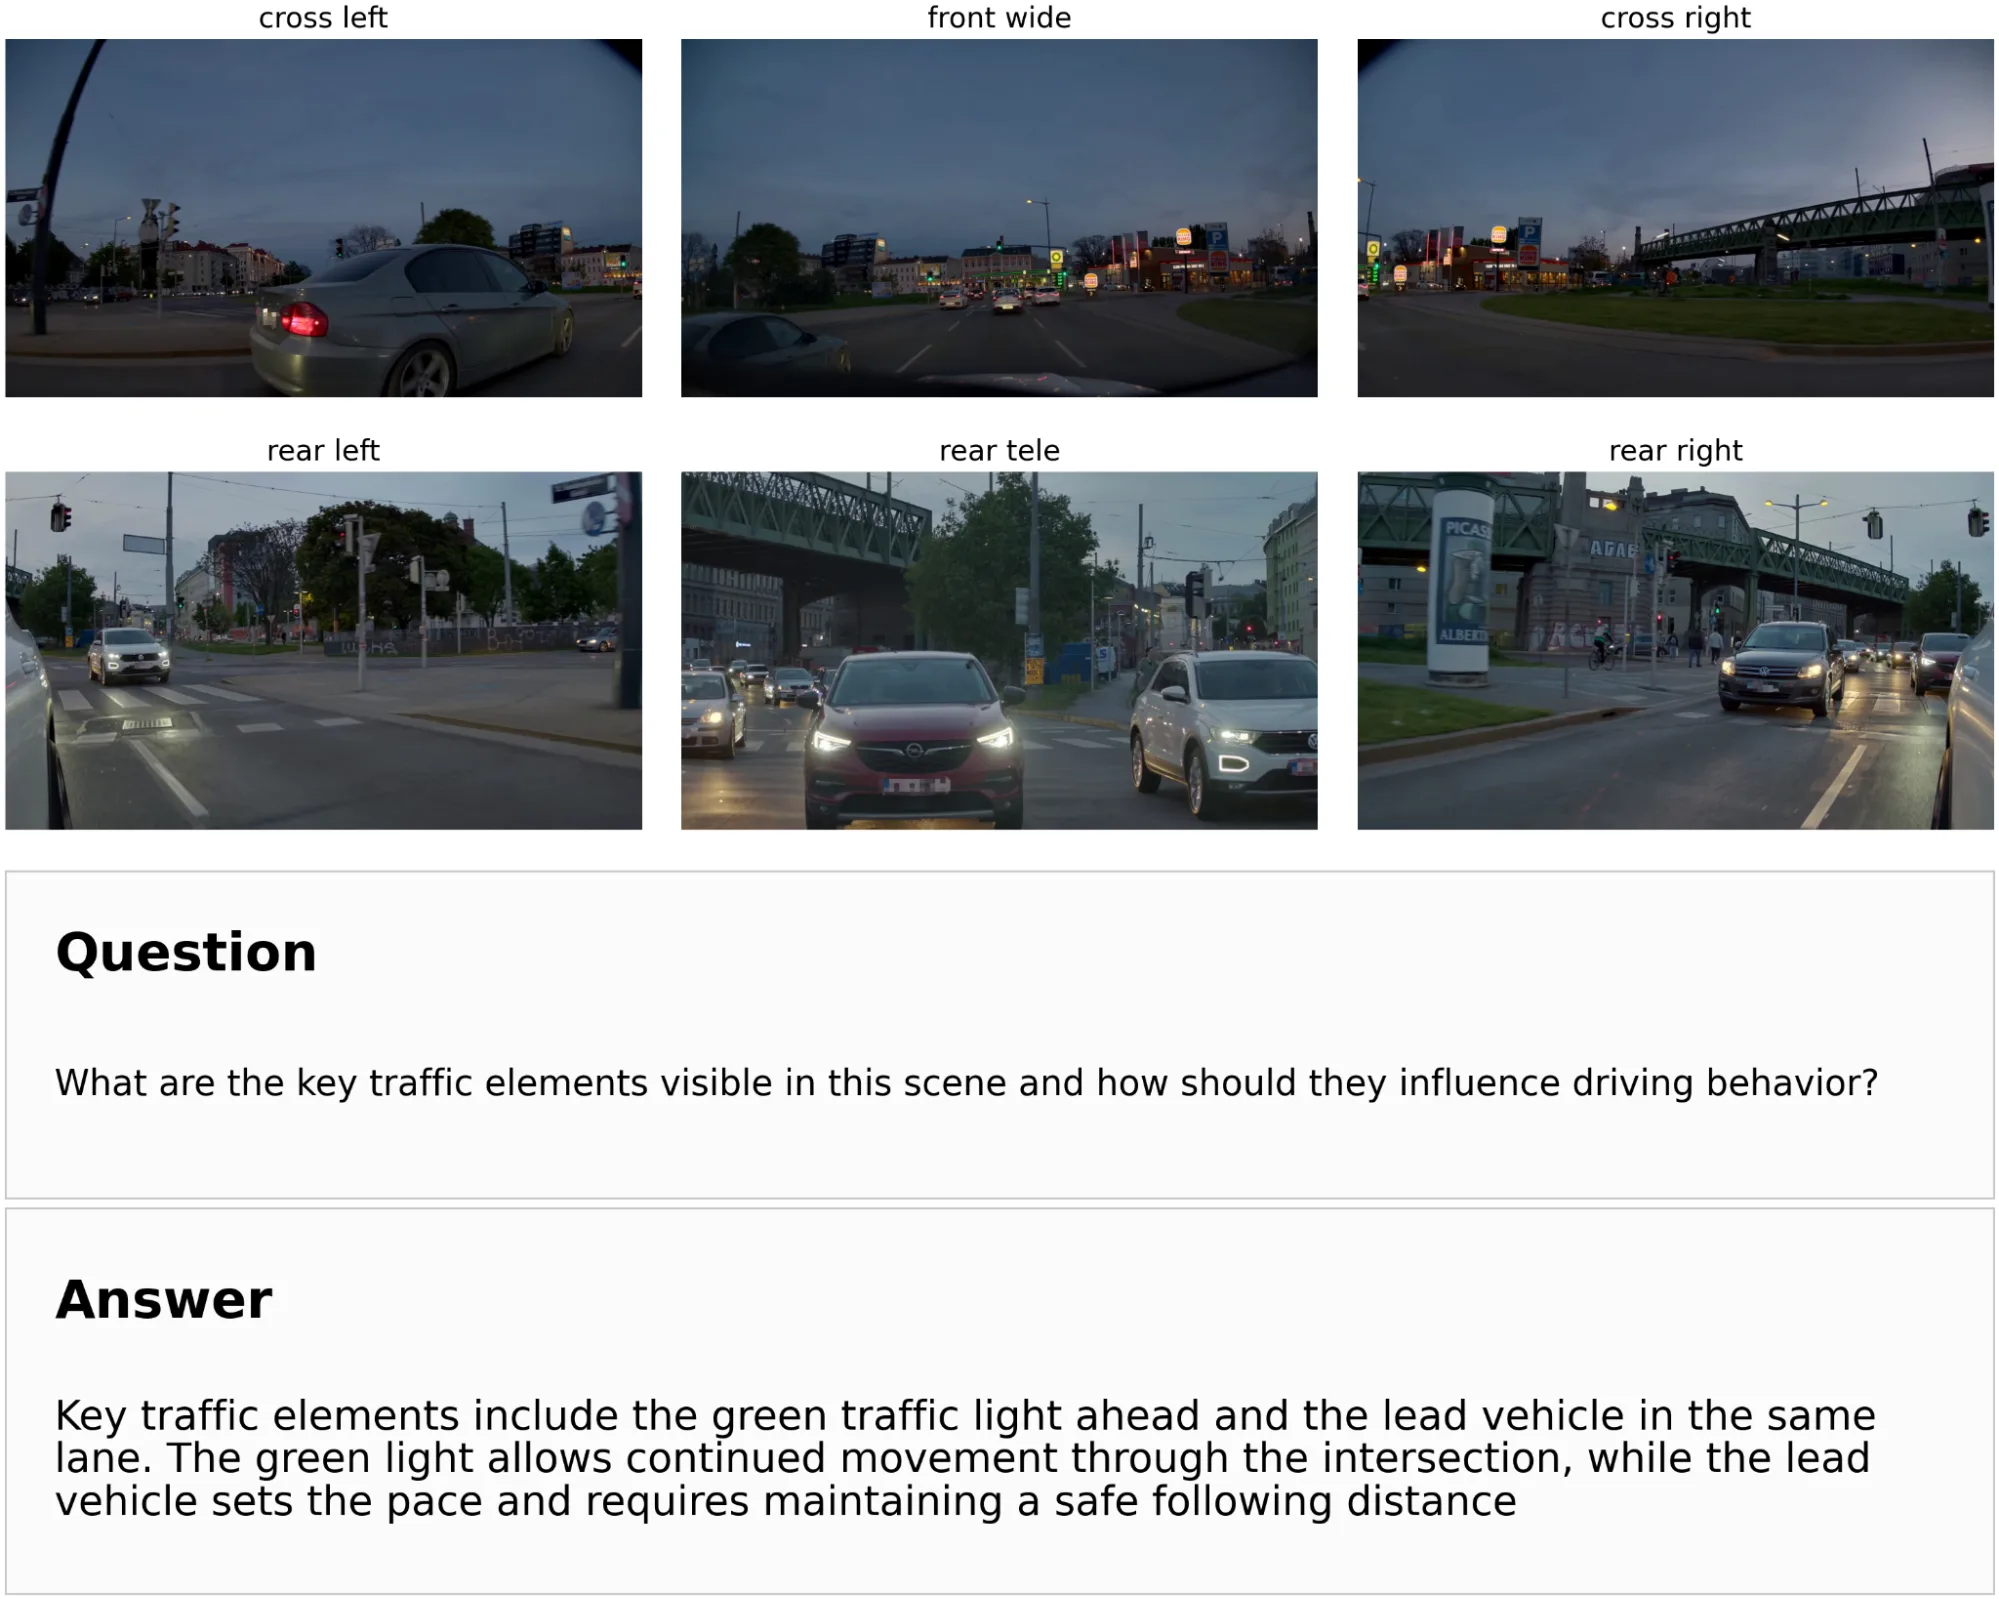
Hình 4. Alpamayo 2 Super trả lời một câu hỏi về cảnh quan sát được
Mô hình có thể trả về hai loại đầu ra cho cùng một đầu vào: Hình 4, ở trên, cho thấy một mô tả bằng ngôn ngữ tự nhiên về cảnh, trong khi Hình 5, ở dưới, cho thấy cùng mô hình đó định vị không gian các đối tượng được tham chiếu bằng cách dự đoán các hộp giới hạn 2D trong khung hình camera liên quan.
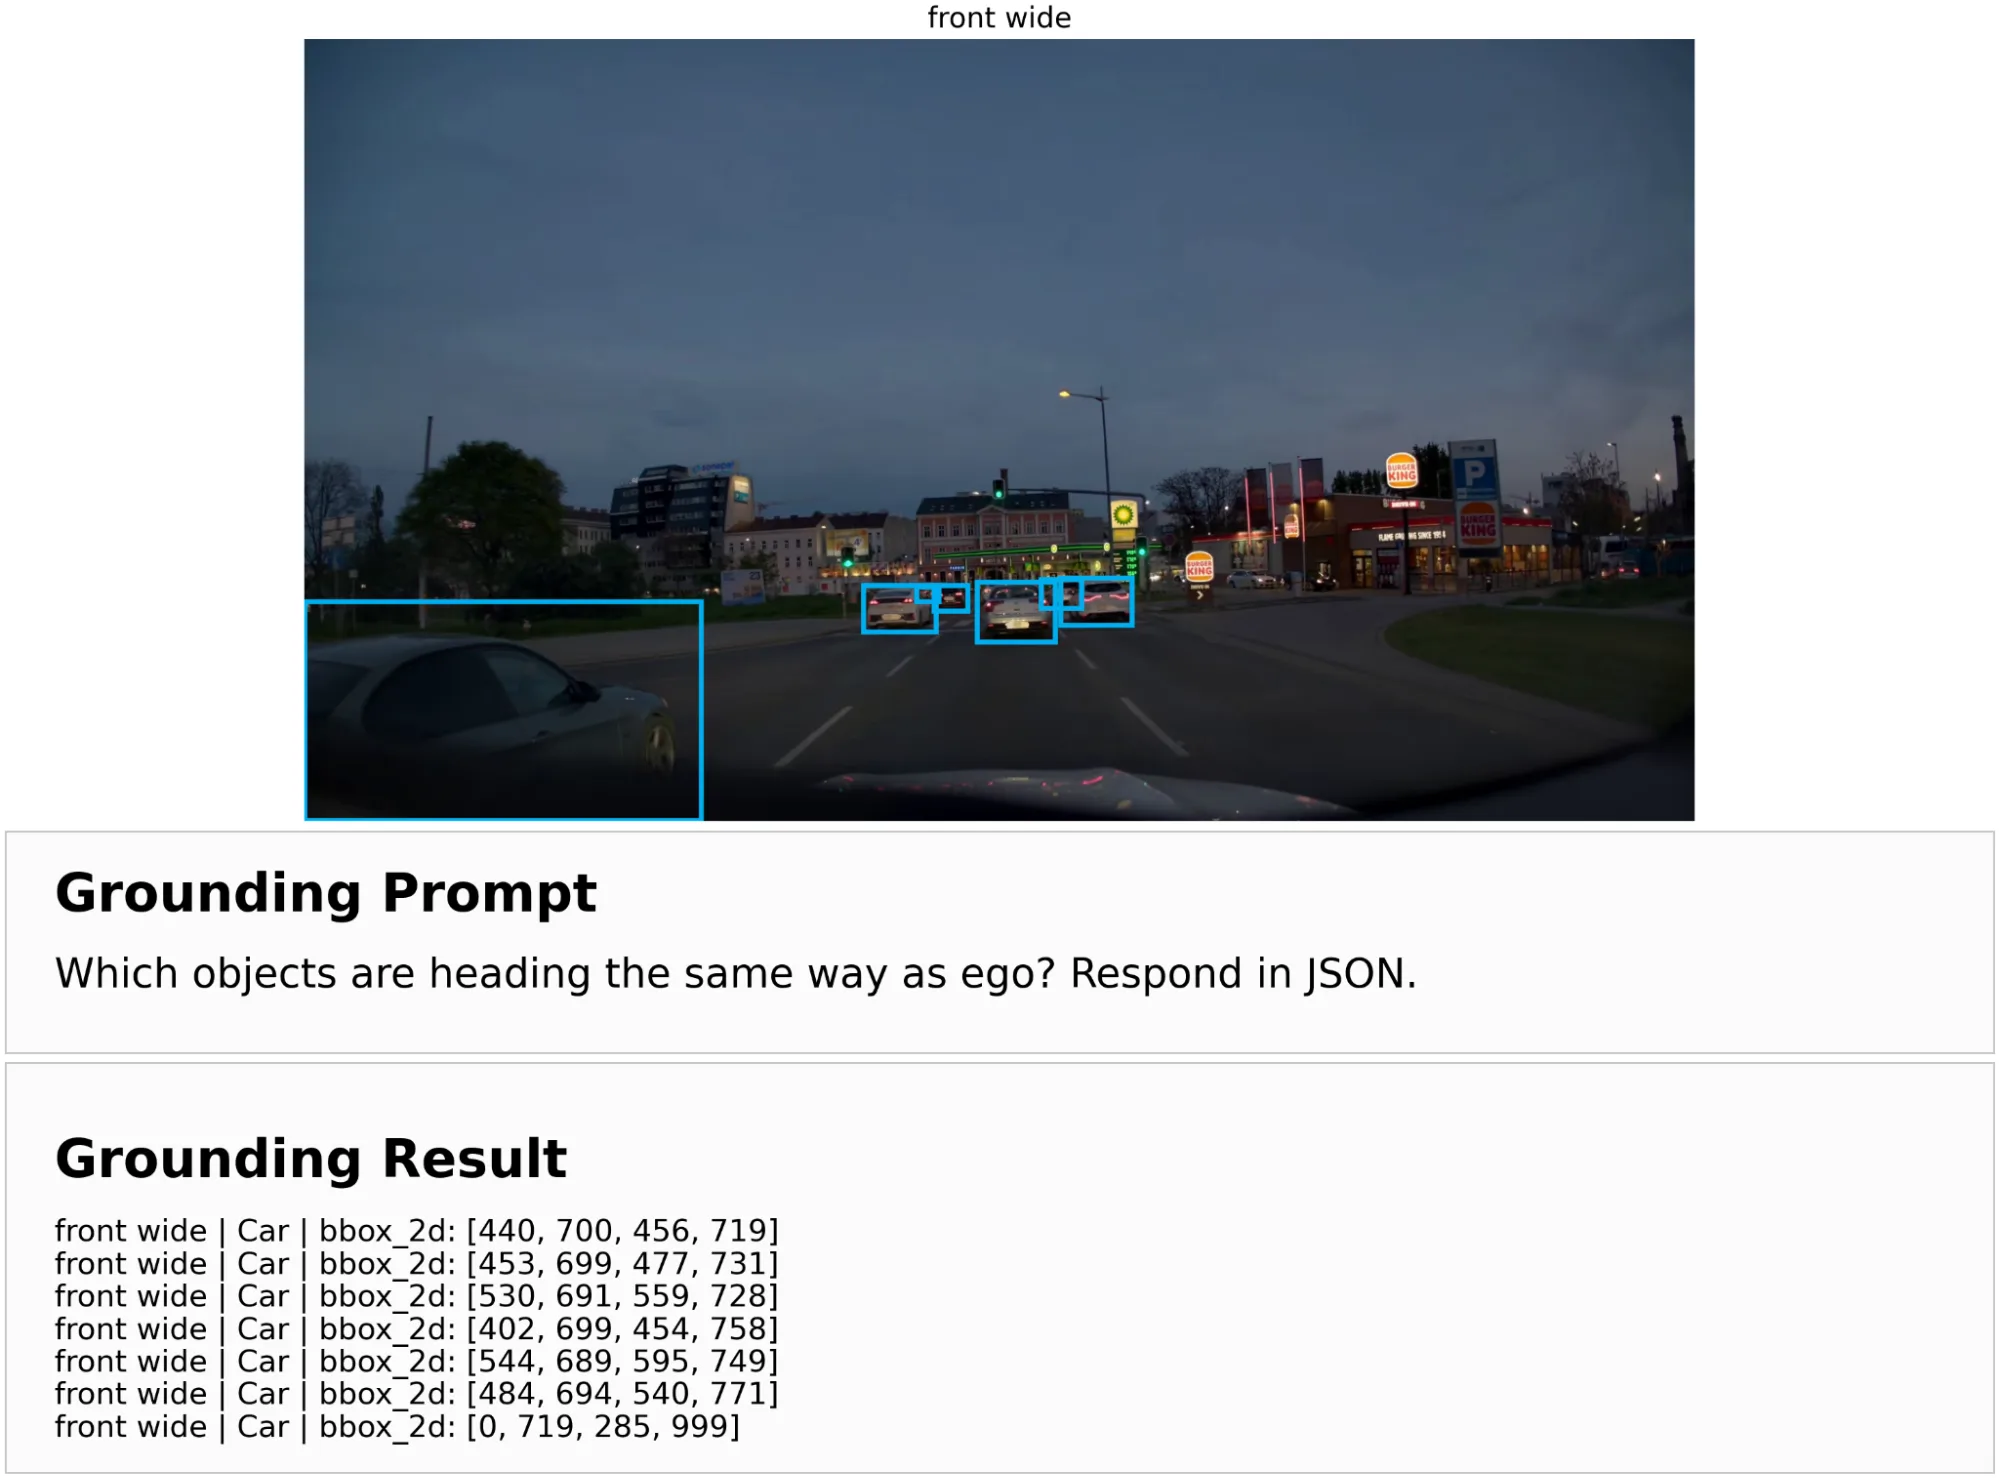
Hình 5. Một đầu ra hiển thị định vị 2D dưới dạng câu trả lời cho một câu hỏi
Đánh giá phản hồi VQA và chất lượng định vị
Để đánh giá hiệu suất VQA, chúng ta so sánh các phản hồi được tạo ra của Alpamayo 2 Super với các câu trả lời ground truth trên một bộ nội bộ gồm 8K cặp câu hỏi-trả lời. Mô hình đạt được 0.652 độ tương đồng câu trả lời (càng cao càng tốt), so với Qwen3-VL 32B ở mức 0.450. Đối với grounding 2D, chúng ta so sánh các bounding box dự đoán với các chú thích ground-truth sử dụng IoU và thu được 0.71 so với 0.17 cho Qwen3-VL 32B. Cùng nhau, các phép đo này đánh giá liệu mô hình có trả lời câu hỏi chính xác và liên kết các phản hồi của nó với bằng chứng hình ảnh chính xác trên các camera xung quanh.
Gán nhãn tự động
Các mô hình suy luận cần dữ liệu suy luận dựa trên quyết định, nhưng gán nhãn các clip lái xe dài đuôi bằng tay là đắt đỏ và chậm. Người chú thích phải kiểm tra ngữ cảnh thời gian và đa camera, xác định các tác nhân nguyên nhân, mô tả cách chúng ảnh hưởng đến xe ego, và giữ nhãn nhất quán với ý định cơ động. Alpamayo 2 Super có thể phục vụ như một trình gán nhãn tự động ngoại tuyến đề xuất cấu trúc này ở quy mô lớn. Điều này có thể rút ngắn chu kỳ chú thích từ vài tháng xuống vài ngày.
Tạo gán nhãn tự động CoC có cấu trúc
Sổ tay tự động gán nhãn CoC chấp nhận các clip trong lược đồ được phát hành và ghi một bản ghi có cấu trúc cho mỗi khung hình chính được chọn.
from alpamayo2_super import helper
from alpamayo2_super.load_physical_aiavdataset import load_physical_aiavdataset
from alpamayo2_super.models.alpamayo2_super import Alpamayo2Super
from alpamayo2_super.text_tasks import generate_text, prepare_text_generation_inputs

data = load_physical_aiavdataset(
  "b5f3756c-4f0e-4298-a1ff-cc92ed392ae0",
   t0_us=11000000,
)

model = Alpamayo2Super.from_pretrained("nvidia/Alpamayo2-Super", dtype=torch.bfloat16, device_map="cuda:0")

task_inputs = prepare_text_generation_inputs(
   data=data,
   model_config=model.config,
   tokenizer=model.tokenizer,
   task="auto_labeling",
)
task_inputs = helper.to_device(task_inputs, "cuda")

torch.cuda.manual_seed_all(42)
with torch.autocast("cuda", dtype=torch.bfloat16):
   result = generate_text(
       model,
       task_inputs,
       top_p=0.98,
       temperature=0.6,
       max_new_tokens=1024,
   )

auto_labeling_text = result["cot_auto_labeling"][0]
auto_labeling_json = result["cot_auto_labeling_json"][0]
print(json.dumps(auto_labeling_json, indent=2))
Theo mặc định, Alpamayo 2 Super giả định truy cập thông tin quỹ đạo ego tương lai. Tuy nhiên, nó cũng có thể tự động gán nhãn dữ liệu không chứa thông tin quỹ đạo tương lai:
# ... same imports and model loading as above ...

# Get the model to predict a future trajectory of its own, and use that in auto-labeling as the "observed" future motion.
trajectory_inputs = helper.prepare_model_inputs(data, model.config, model.tokenizer)
trajectory_inputs = helper.to_device(trajectory_inputs, "cuda")

torch.cuda.manual_seed_all(42)
with torch.autocast("cuda", dtype=torch.bfloat16):
   pred_xyz, pred_rot, _, extra = model.sample_trajectories_from_data(
        data=trajectory_inputs,
        top_p=0.98,
        temperature=0.6,
        num_traj_samples=1,
        diffusion_kwargs={"inference_step": 10},
        return_extra=True,
   )
   future_xyz = pred_xyz[:, 0, 0].detach().cpu()
   future_rot = pred_rot[:, 0, 0].detach().cpu()
   # In case you want to see the model's reasoning, uncomment these:
   # trajectory_cot = str(extra["cot"].reshape(-1)[0])
   # print("trajectory_cot:\n", trajectory_cot)

task_inputs = prepare_text_generation_inputs(
   data=data,
   model_config=model.config,
   tokenizer=model.tokenizer,
   task="auto_labeling",
   # This is where the predicted trajectories are passed in:
   future_xyz=future_xyz,
   future_rot=future_rot,
)
task_inputs = helper.to_device(task_inputs, "cuda")

torch.cuda.manual_seed_all(42)
with torch.autocast("cuda", dtype=torch.bfloat16):
   result = generate_text(
       model,
       task_inputs,
       top_p=0.98,
       temperature=0.6,
       max_new_tokens=1024,
   )

auto_labeling_text = result["cot_auto_labeling"][0]
auto_labeling_json = result["cot_auto_labeling_json"][0]
print(json.dumps(auto_labeling_json, indent=2))
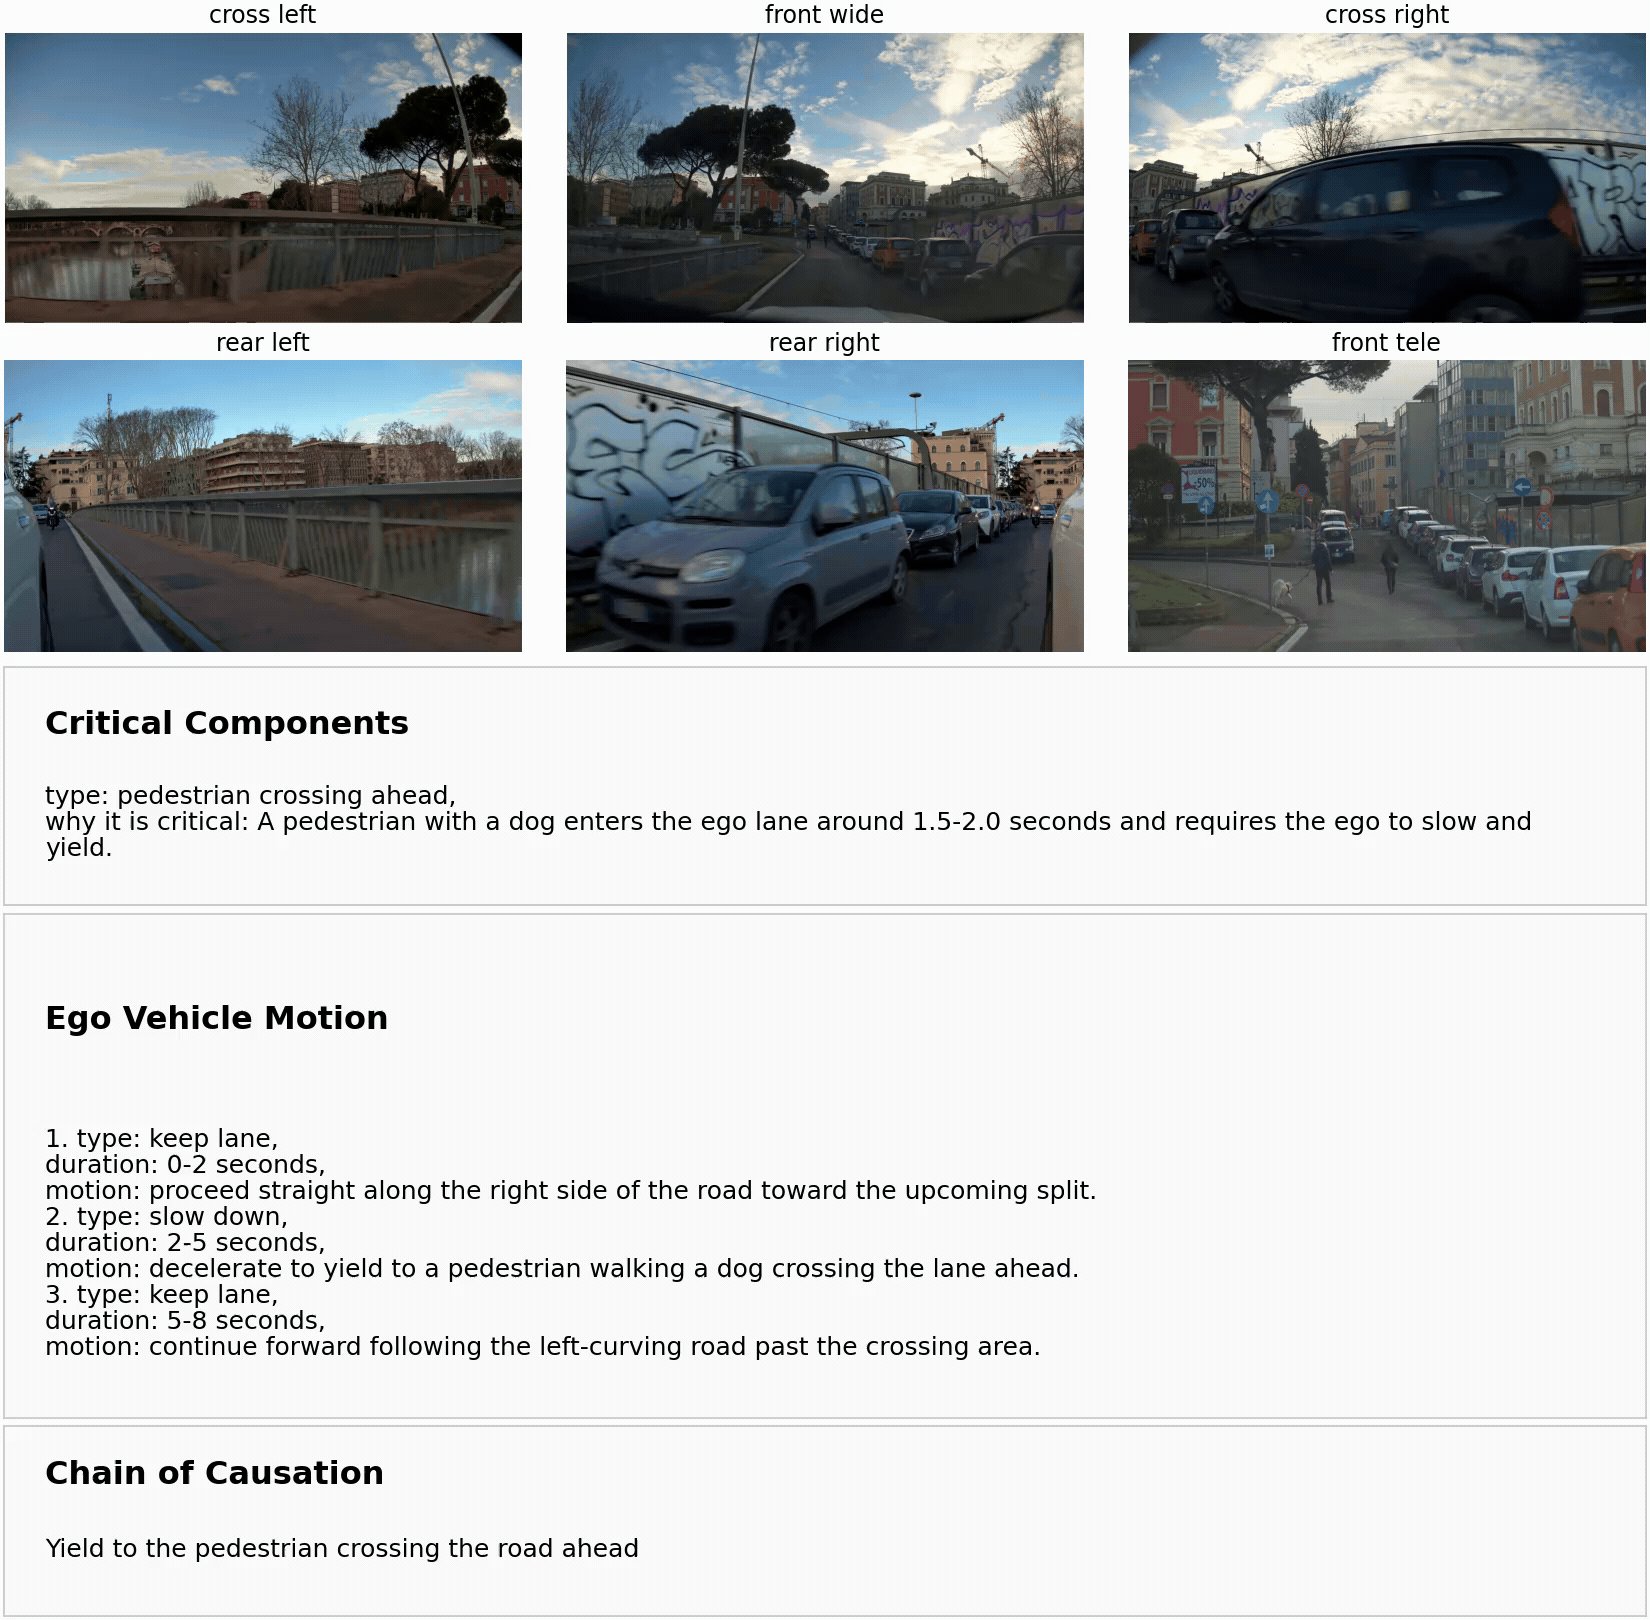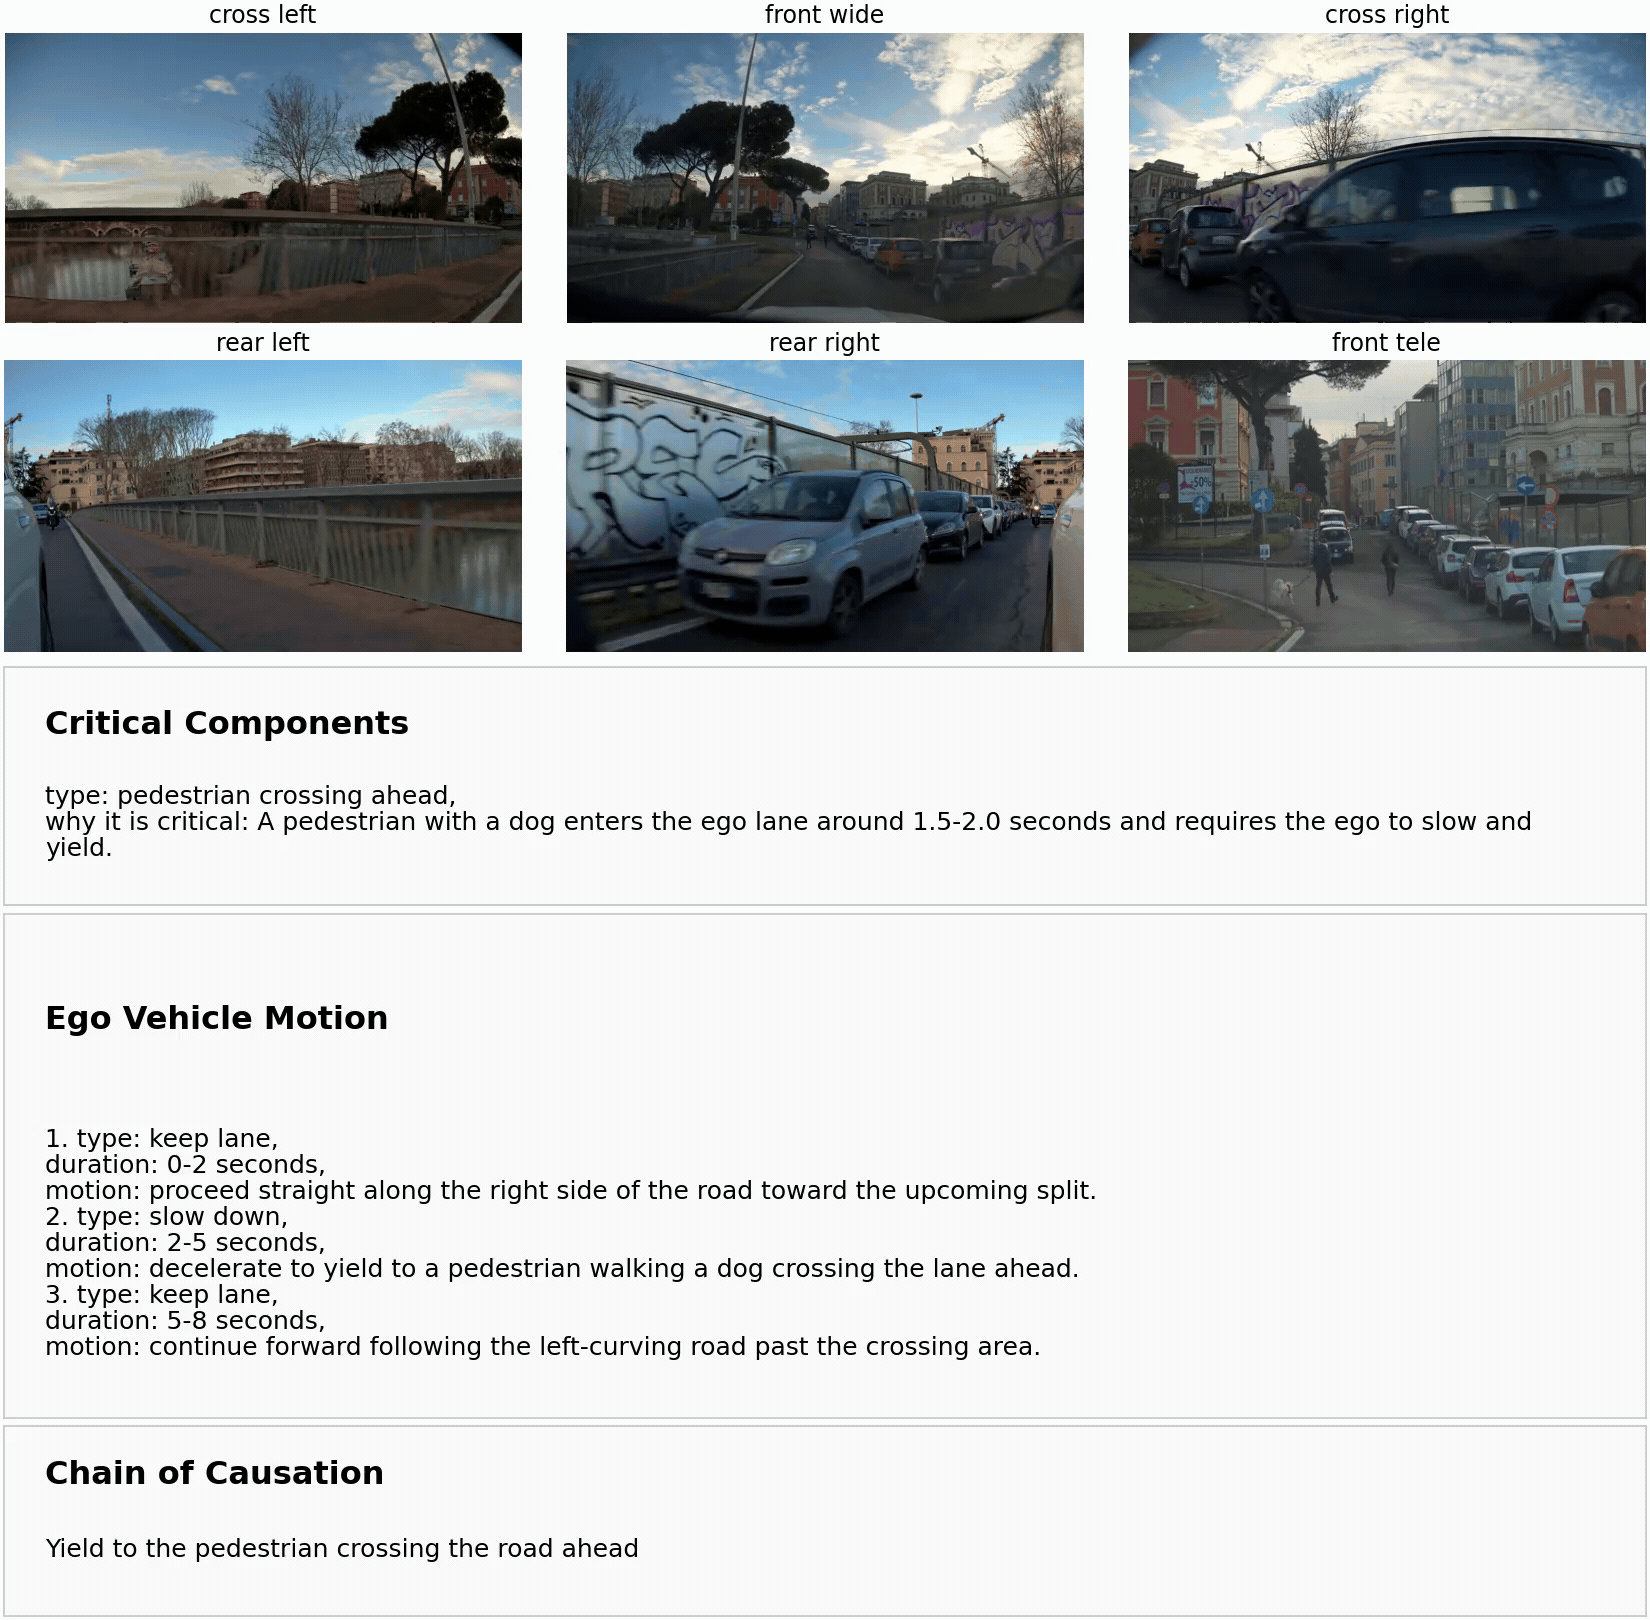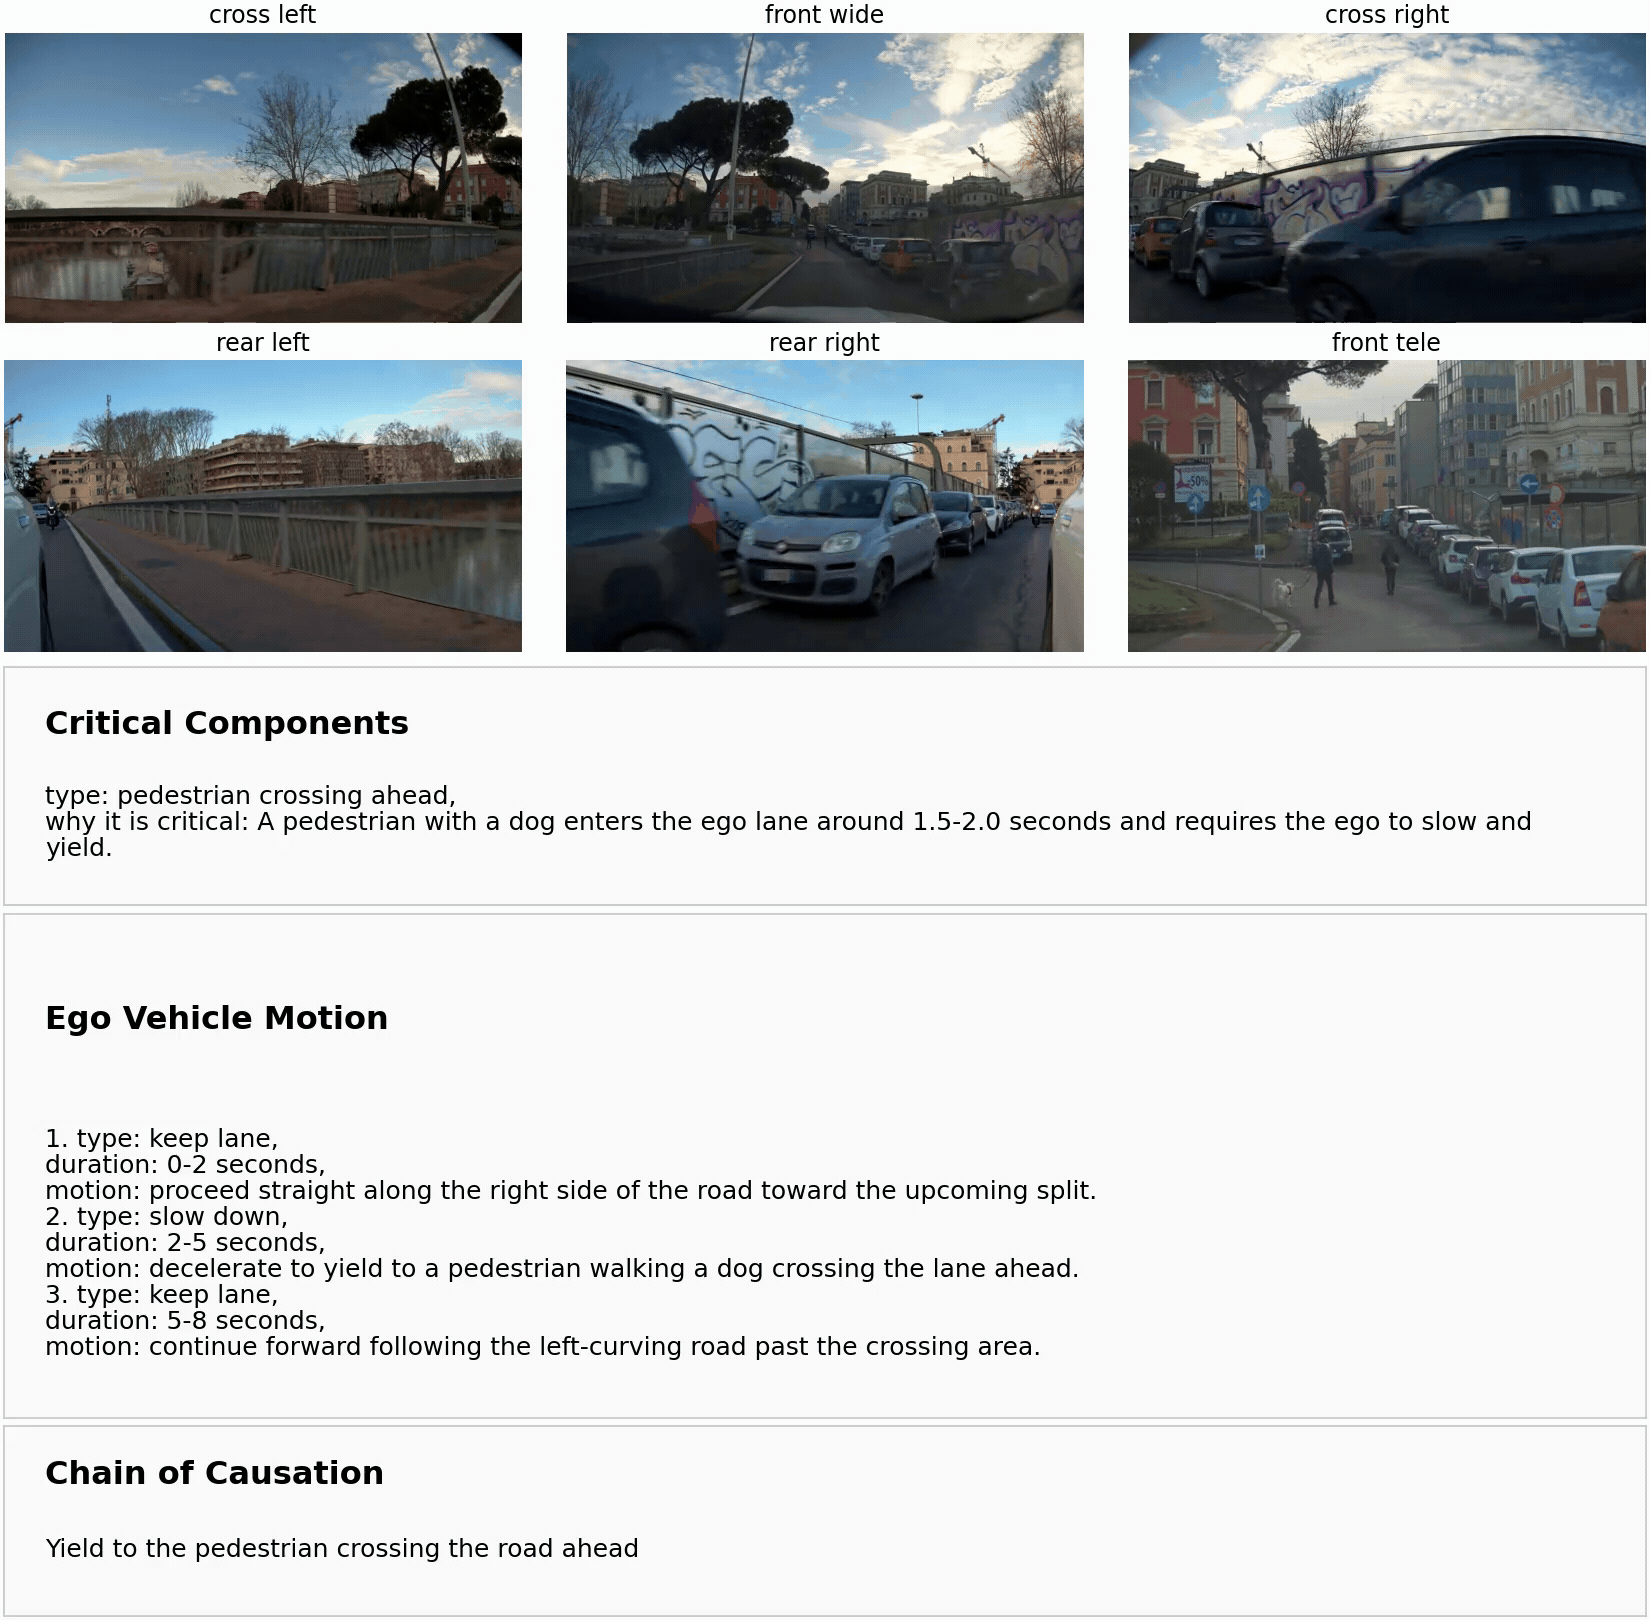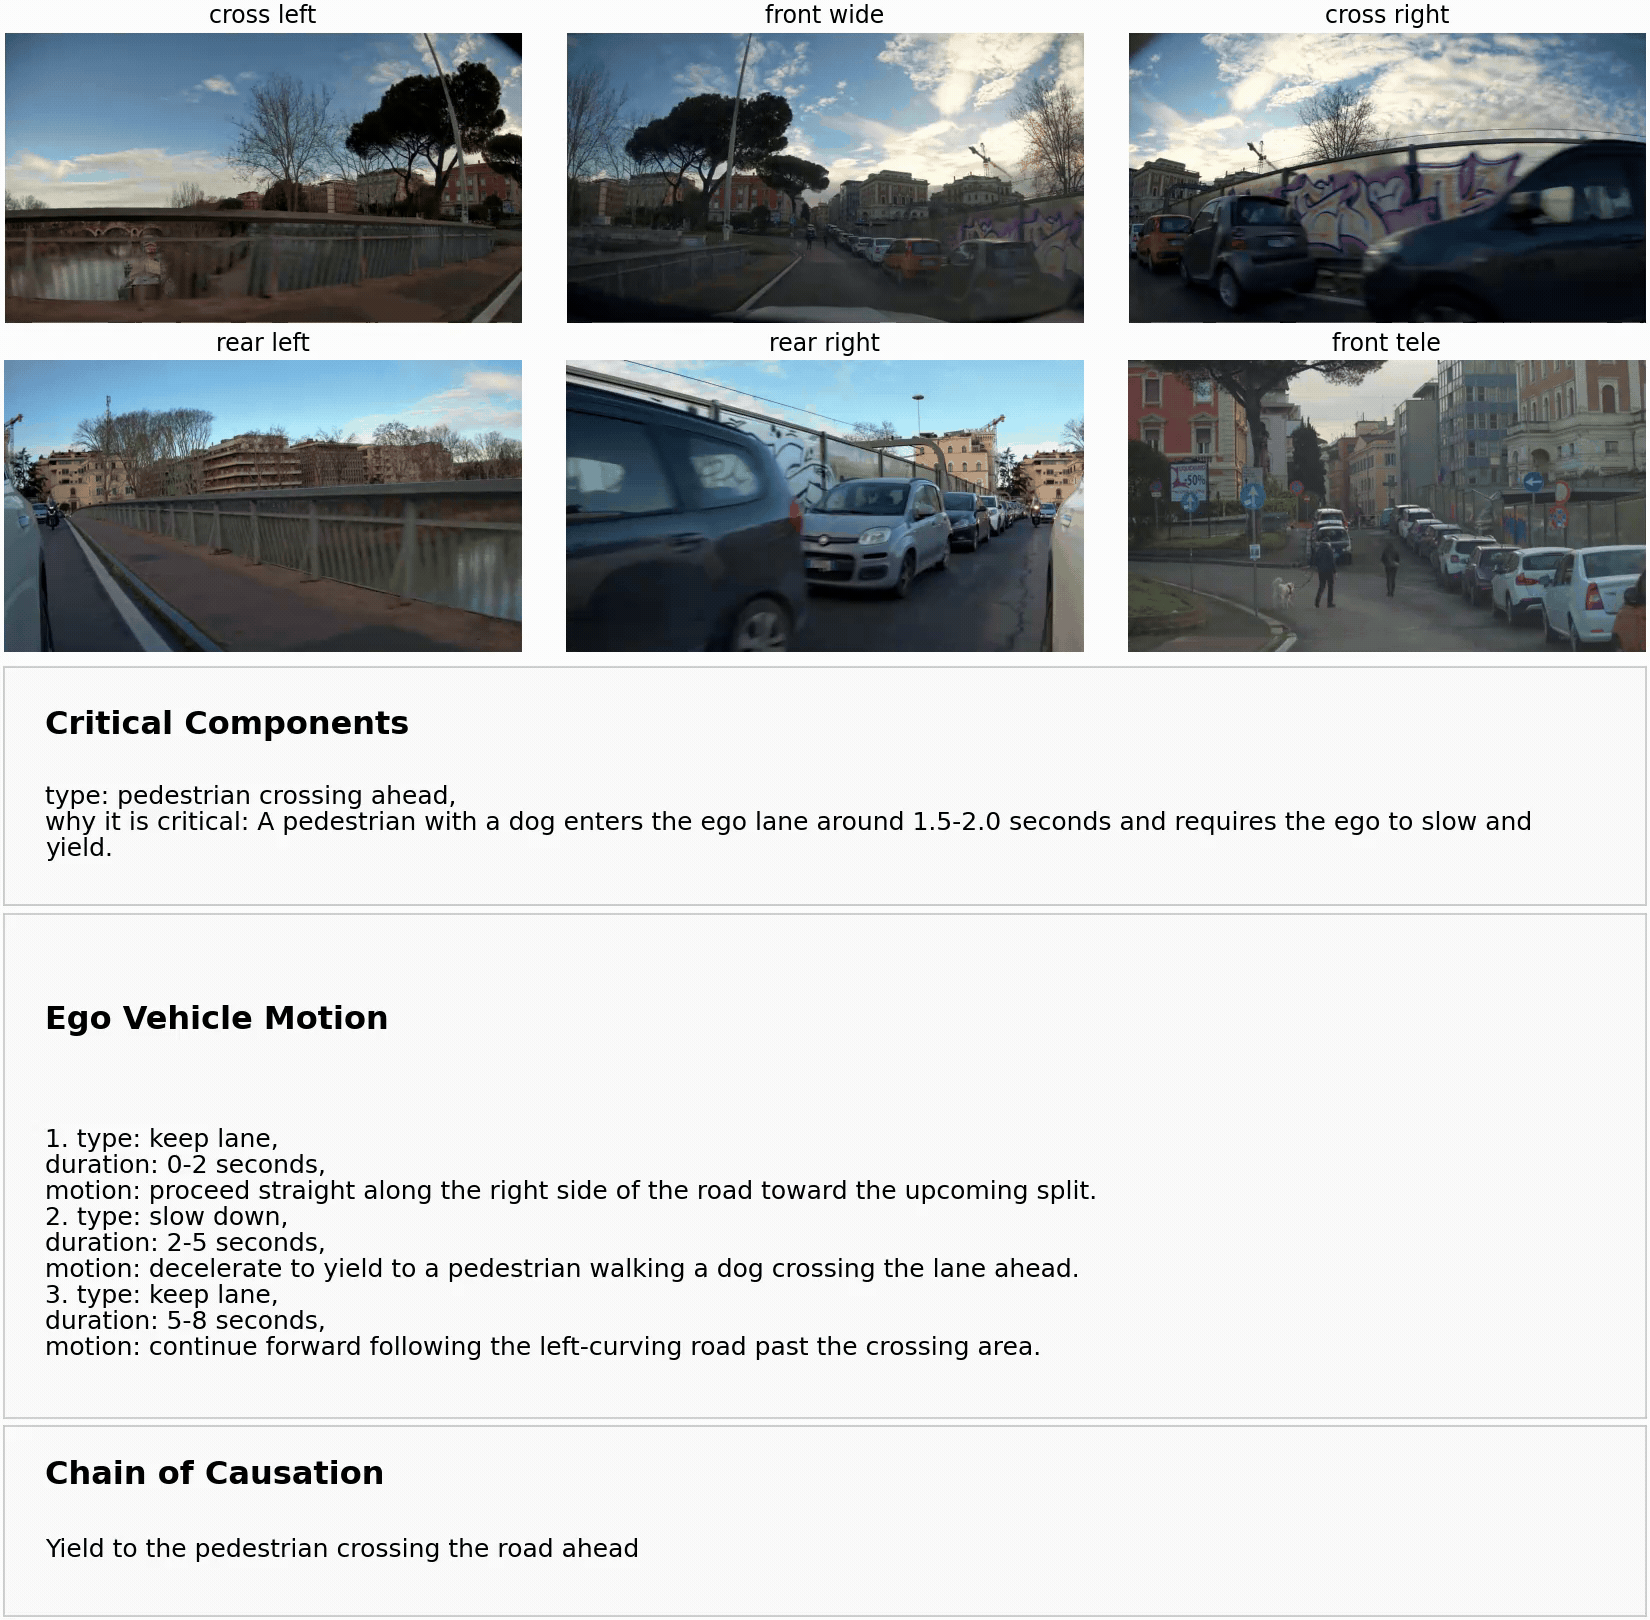
Hình 6. Kết quả tự động gán nhãn lý luận với dấu vết CoC và đầu vào đa camera
Đánh giá chất lượng tự động gán nhãn CoC
Để đánh giá chất lượng gán nhãn tự động CoC, chúng tôi so sánh các nhãn được tạo bởi Alpamayo 2 Super với các chú thích chuyên gia trên 8k clip nội bộ. Chúng tôi sử dụng một mô hình đánh giá nội bộ để đánh giá sự tương đồng. Alpamayo 2 Super đạt điểm tương đồng 0.652, so với Qwen3-VL 32B ở mức 0.450. Kết quả này cho thấy tiềm năng của nó trong việc tạo các nhãn lý luận có cấu trúc ở quy mô lớn trong khi duy trì tính nhất quán với các chú thích do chuyên gia viết.
Xây dựng với Alpamayo 2 Super
Alpamayo 2 Super kết hợp nhận thức toàn cảnh, lý luận, lập kế hoạch, hiểu cảnh và gán nhãn tự động dữ liệu vào một quy trình làm việc mô hình mở. Các khả năng này cung cấp cho nhà phát triển nền tảng thực tế để xây dựng mô hình giáo viên, quản lý dữ liệu dài đuôi, kiểm tra quyết định chính sách và đánh giá hệ thống AV ngoài một chỉ số quỹ đạo vòng lặp mở đơn lẻ. Là một mô hình giáo viên, nó có thể được chưng cất thành các mô hình nhỏ gọn chạy trên NVIDIA DRIVE AGX Thor bên trong xe.
Khám phá mô hình trên Hugging Face, chạy sổ tay suy luận, và chia sẻ những gì bạn xây dựng trên diễn đàn nhà phát triển Alpamayo.
Để biết thêm chi tiết về các bản cập nhật rộng hơn được giới thiệu trong bản phát hành Alpamayo 2, xem bài đăng blog liên quan trên Hugging Face.
Bài viết liên quan
- Xây dựng Agent dựa trên bộ nhớ với NVIDIA NemoClaw
- Mở rộng khả năng nhận diện trên các nền tảng AV với NVIDIA Omniverse NuRec
- TensorRT 11 có gì mới và AI Engineer cần chuẩn bị gì khi nâng cấp?
- Cách sử dụng AI Agents để chuẩn bị cảnh 3D cho mô phỏng
- Tại sao việc mở rộng hiệu suất điện toán AI đòi hỏi một kiến trúc nguồn điện mới?