Không cần switch 200 GbE, không cần đầu tư thêm thiết bị mạng chuyên dụng: chỉ với 4 sợi cáp QSFP, người dùng giờ đây có thể kết nối trực tiếp 4 máy NVIDIA DGX Spark thành một cụm tính toán với tổng cộng 512 GB bộ nhớ hợp nhất.
Đáng chú ý, đây không còn là một giải pháp do cộng đồng tự thử nghiệm. NVIDIA đã đưa cấu hình kết nối vòng 4 máy, không sử dụng switch, vào tài liệu hướng dẫn chính thức Connect Multiple DGX Sparks for Distributed Workloads.
Ad
Động thái này mở ra một lựa chọn tiết kiệm chi phí cho những người muốn xây dựng cụm AI nhiều máy từ DGX Spark. Tuy nhiên, không phải cứ kết nối được 4 máy là sẽ đạt hiệu năng tương đương một cụm sử dụng switch chuyên dụng. Cách kết nối này có những giới hạn đáng cân nhắc, đặc biệt khi chạy các mô hình cần trao đổi dữ liệu liên tục giữa nhiều GPU.
Vậy NVIDIA đã hướng dẫn những gì, cách đấu nối ra sao và khi nào nên chọn giải pháp này thay vì đầu tư switch 200 GbE?
1. Điểm mới: NVIDIA chính thức hỗ trợ kết nối vòng 4 máy
Trong mục Cable the Devices của playbook, NVIDIA hiện liệt kê bốn phương án kết nối cụm DGX Spark:
| Số máy | Kiểu kết nối | Số cáp | Phương thức cấu hình |
|---|---|---|---|
| 2 máy | Kết nối trực tiếp | 1 | NVIDIA Sync hoặc thủ công |
| 3 máy | Kết nối vòng/full mesh | 3 | NVIDIA Sync hoặc thủ công |
| 4 máy | Kết nối vòng (ring) | 4 | Chỉ cấu hình thủ công |
| Từ 2 máy trở lên | Kết nối qua switch | 1 cáp cho mỗi máy | NVIDIA Sync hoặc thủ công |
Điểm quan trọng nhất nằm ở cấu hình 4 máy: NVIDIA đã cung cấp hướng dẫn cụ thể để thiết lập topology dạng vòng bằng tham số --topology ring.
Trước đây, người dùng muốn kết nối nhiều DGX Spark thường phải cân nhắc các switch 200 GbE, chẳng hạn MikroTik CRS804 hoặc CRS812. Với hướng dẫn mới, việc xây dựng một cụm 4 máy không cần switch đã có phương án triển khai rõ ràng trong tài liệu chính thức.
Tuy nhiên, có một chi tiết cần phân biệt: hỗ trợ cấu hình vòng 4 máy không đồng nghĩa NVIDIA Sync đã hỗ trợ cấu hình này. Theo playbook, topology vòng 4 máy phải được thiết lập thủ công. Tài liệu DGX Spark User Guide, cập nhật ngày 21/10/2026, vẫn giới hạn NVIDIA Sync Cluster Assistant ở tối đa 3 máy kết nối trực tiếp.
Nói cách khác, NVIDIA đã mở rộng phương án kết nối vật lý và hướng dẫn cấu hình, nhưng chưa mang lại trải nghiệm thiết lập tự động tương đương cho cụm 4 máy.
2. Cách đấu nối 4 DGX Spark thành một vòng
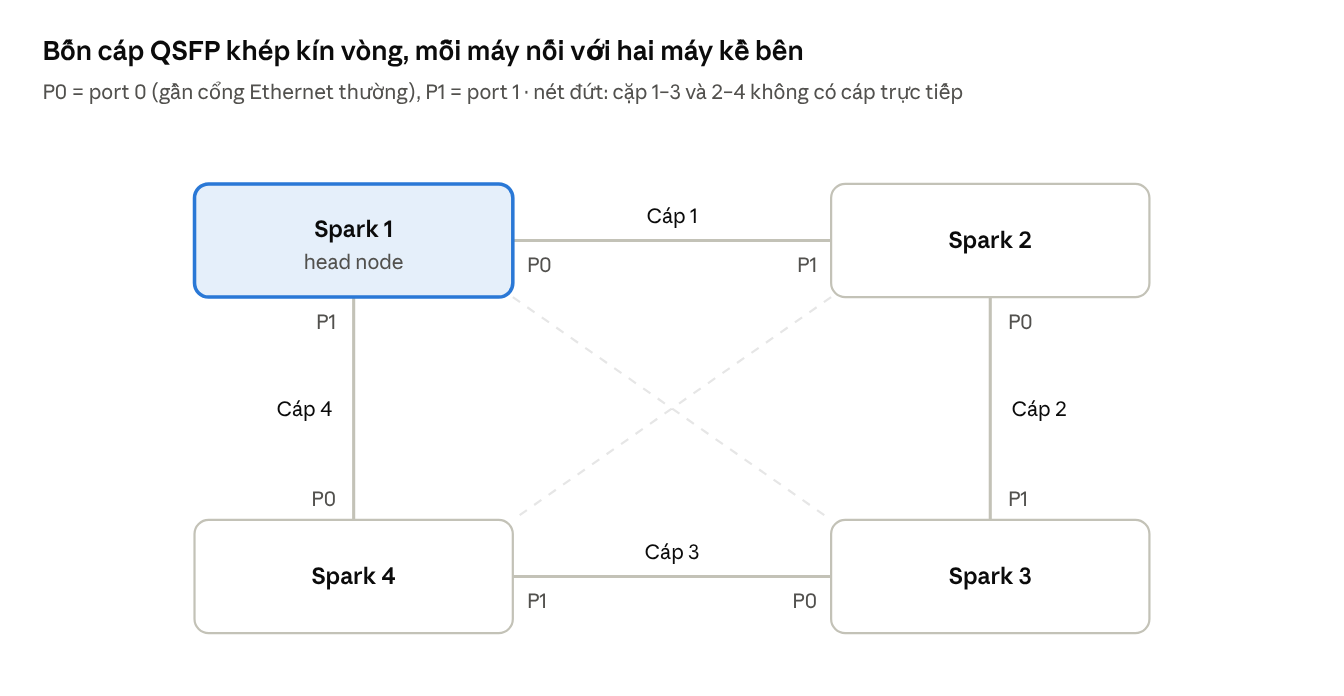
Nguyên tắc kết nối khá đơn giản: cổng port 0 của mỗi máy nối với port 1 của máy tiếp theo. Ở cuối vòng, máy thứ tư kết nối trở lại máy đầu tiên để hoàn tất topology.
Sơ đồ đấu cáp cụ thể như sau:
| Cáp | Đầu kết nối thứ nhất | Đầu kết nối thứ hai |
|---|---|---|
| 1 | Spark 1 – port 0 | Spark 2 – port 1 |
| 2 | Spark 2 – port 0 | Spark 3 – port 1 |
| 3 | Spark 3 – port 0 | Spark 4 – port 1 |
| 4 | Spark 4 – port 0 | Spark 1 – port 1 |
Như vậy, toàn bộ cụm chỉ cần 4 cáp QSFP112 DAC, không cần thêm switch trung tâm.
Theo hướng dẫn được đề cập trong bài, các loại cáp được NVIDIA phê duyệt gồm:
- Amphenol NJAAKK-N911: dài 0,4 m; phiên bản 0,5 m có mã NJAAKK0006.
- Luxshare LMTQF022-SD-R: dài 0,4 m.
Các cáp này phải hoạt động ở chế độ Ethernet. Người dùng cũng nên cập nhật phần mềm hệ thống trên cả 4 máy lên phiên bản mới nhất thông qua DGX Dashboard trước khi tiến hành cấu hình.
Lưu ý: cần xác định đúng port 0 và port 1 trên mặt sau thiết bị. Theo tài liệu nguồn, port 0 là cổng QSFP nằm gần cổng Ethernet thông thường.
3. Cấu hình phần mềm: Phải thực hiện thủ công
Nếu kết nối 2 hoặc 3 máy, người dùng có thể có thêm lựa chọn cấu hình thông qua NVIDIA Sync. Nhưng với topology vòng 4 máy, NVIDIA hướng dẫn sử dụng mục Configure Manually.
Quy trình này dựa trên script setup-cluster.sh trong repository spark-vllm-docker của cộng đồng, do tài khoản eugr phát triển và duy trì. NVIDIA đưa công cụ này vào hướng dẫn triển khai, nhưng đây không phải phần mềm do NVIDIA tự phát triển.
Bước 1: Chuẩn bị cả 4 máy
Trước khi bắt đầu, cần bảo đảm:
- Cả 4 máy đều có địa chỉ IP trên mạng quản lý và có thể truy cập qua SSH.
- Các máy sử dụng cùng một tên người dùng có quyền
sudo. - Có Python 3.10 trở lên, Netplan và OpenSSH.
- Không tự ý đổi tên, tạo bond, bridge hoặc cấu hình VLAN trên các interface ConnectX-7.
Bước 2: Chọn máy chủ điều phối
Chọn Spark 1 làm head node. Toàn bộ quá trình cấu hình được thực hiện từ máy này, không chạy script trên laptop.
Đăng nhập bằng tài khoản người dùng thông thường, không chạy script với sudo.
Bước 3: Tải công cụ cấu hình
Chạy các lệnh sau trên Spark 1:
git clone https://github.com/eugr/spark-vllm-docker.git
cd spark-vllm-docker
Bước 4: Chạy thử trước khi áp dụng
Giả sử địa chỉ IP quản lý của 4 máy lần lượt là 192.168.1.11, 192.168.1.12, 192.168.1.13 và 192.168.1.14, hãy chạy:
./setup-cluster.sh 192.168.1.11 192.168.1.12 192.168.1.13 192.168.1.14 --topology ring --mtu 1500 --dry-runChế độ --dry-run cho phép kiểm tra kế hoạch cấu hình trước khi thay đổi hệ thống.
Thứ tự địa chỉ IP phải khớp với thứ tự các máy trong vòng kết nối vật lý: Spark 1, Spark 2, Spark 3 và Spark 4.
Bước 5: Áp dụng cấu hình
Sau khi kiểm tra kế hoạch, chạy lại lệnh trên nhưng bỏ tham số --dry-run.
Xem kỹ những thay đổi mà script đề xuất rồi nhập y để xác nhận. Theo tài liệu nguồn, script sẽ sao lưu cấu hình, thiết lập khóa SSH, ghi cấu hình Netplan và tự kiểm tra kết nối ping cũng như SSH hai chiều.
Bước 6: Kiểm tra và khôi phục khi cần
Sau khi hoàn tất, đăng nhập lại và chạy:
./setup-cluster.sh --doctor --dry-runNếu cần quay lại cấu hình trước đó, sử dụng:
./setup-cluster.sh --restoreLệnh khôi phục được thực hiện trên head node.
Về địa chỉ mạng, script cấp các subnet /24 trong dải 10.20.0.0/16. Mỗi cáp sử dụng hai subnet, tương ứng với hai đường PCIe, vì vậy cấu hình vòng 4 máy có tổng cộng 8 subnet.
Nếu khai báo các máy không đúng thứ tự cáp, bước kiểm tra có thể báo lỗi. Vì thế, cần kiểm tra kỹ sơ đồ đấu nối và danh sách IP trước khi áp dụng cấu hình chính thức.
4. Năm giới hạn cần biết trước khi triển khai
Việc NVIDIA công bố hướng dẫn chính thức giúp phương án kết nối 4 máy không cần switch trở nên rõ ràng hơn. Tuy nhiên, điều đó không có nghĩa cấu hình vòng sẽ đạt hiệu năng tương đương hệ thống sử dụng switch chuyên dụng.
Có năm điểm cần đặc biệt lưu ý.
4.1. Không hỗ trợ NVIDIA Sync cho cấu hình vòng 4 máy
Đây là khác biệt lớn về trải nghiệm triển khai.
Người dùng phải thực hiện cấu hình thủ công, thay vì dựa vào NVIDIA Sync để đơn giản hóa quy trình. Điều này đòi hỏi hiểu biết nhất định về mạng, SSH, Netplan và cách tổ chức kết nối giữa các node.
4.2. Công cụ cấu hình đến từ cộng đồng
Script setup-cluster.sh thuộc repository eugr/spark-vllm-docker. NVIDIA đưa công cụ này vào hướng dẫn cấu hình, nhưng cần phân biệt rõ nguồn phát triển của phần mềm.
Với hệ thống dùng cho công việc quan trọng, nên đọc mã nguồn, kiểm tra các thay đổi mà script thực hiện và xác minh khả năng khôi phục trước khi triển khai trên máy đang vận hành.
4.3. Topology vòng không phải full mesh
Trong cấu hình vòng, mỗi máy kết nối trực tiếp với hai máy lân cận.
Điều đó có nghĩa Spark 1 và Spark 3 không có liên kết trực tiếp với nhau; tương tự, Spark 2 và Spark 4 cũng vậy. Dữ liệu giữa các cặp máy này phải đi qua một node trung gian.
Đây là khác biệt quan trọng so với topology full mesh, nơi mỗi máy có liên kết trực tiếp với tất cả các máy còn lại.
Vì vậy, dù số lượng cáp ít và không cần switch, topology vòng vẫn có thể làm tăng số chặng truyền dữ liệu giữa một số node.
4.4. Băng thông thực tế có thể thấp hơn kỳ vọng
Theo tài liệu của repository được bài gốc dẫn lại, cấu hình daisy-chain 3 máy có thể khiến băng thông giữa mỗi cặp giảm xuống khoảng 100 Gb/s, thay vì 200 Gb/s.
Đối với vòng 4 máy, bài gốc nhận định nhiều khả năng sẽ gặp giới hạn tương tự. Tuy nhiên, không nên xem mức 100 Gb/s là kết quả benchmark đã được xác nhận cho mọi cấu hình vòng 4 máy.
Hiệu năng thực tế còn phụ thuộc vào kiểu truyền dữ liệu, tải công việc, cách phân chia mô hình và lưu lượng đồng thời giữa các node. Muốn biết cấu hình có đáp ứng nhu cầu hay không, cần đo trực tiếp trên hệ thống thực tế.
4.5. MTU được khuyến nghị là 1500
NVIDIA chỉ khuyến nghị MTU 9000 cho trường hợp hai máy kết nối trực tiếp. Với các topology khác, bao gồm vòng 4 máy, hướng dẫn sử dụng MTU 1500.
Do đó, trong ví dụ cấu hình ở trên, tham số được sử dụng là --mtu 1500.
Không nên tự ý chuyển sang jumbo frame chỉ vì muốn tăng hiệu năng. Mọi thay đổi cần dựa trên hướng dẫn tương ứng với topology và được kiểm tra đầy đủ trước khi đưa vào vận hành.
5. Kết nối vòng hay đầu tư switch 200 GbE?
Câu trả lời phụ thuộc vào mục tiêu sử dụng. Nếu ưu tiên tiết kiệm chi phí và thử nghiệm cụm nhiều máy, kết nối vòng là lựa chọn đáng cân nhắc. Nếu ưu tiên hiệu năng truyền thông giữa các node, khả năng mở rộng và vận hành ổn định, switch vẫn có lợi thế rõ ràng.
| Tiêu chí | Vòng 4 máy, không switch | Kết nối qua switch 200 GbE |
|---|---|---|
| Thiết bị bổ sung | Không cần switch, sử dụng 4 cáp QSFP | Cần switch phù hợp |
| Cấu hình | Thủ công với --topology ring |
Có thể dùng NVIDIA Sync cho tối đa 4 máy theo tài liệu nguồn |
| Đường truyền giữa các node | Một số cặp phải đi qua node trung gian | Các node kết nối qua switch trung tâm |
| Băng thông | Có thể chịu giới hạn do topology và lưu lượng đồng thời | Có liên kết riêng từ mỗi node đến switch; hiệu năng thực tế còn phụ thuộc thiết bị và tải |
| Phù hợp với | Thử nghiệm, pipeline parallelism và data parallelism khi workload phù hợp | Workload nhạy với giao tiếp giữa node, chẳng hạn tensor parallelism |
| Khả năng mở rộng | NVIDIA chưa nêu phương án vòng không switch vượt quá 4 máy trong tài liệu được đề cập | Phù hợp hơn khi mở rộng cụm; từ 5 máy trở lên có thể cần cấu hình thủ công |
Một điểm quan trọng là không nên đánh đồng kết nối qua switch với việc mọi tác vụ đều đạt hiệu năng cao hơn trong mọi tình huống. Kết quả vẫn phụ thuộc vào workload, cấu hình phần mềm và cách phân phối dữ liệu.
Tuy nhiên, switch giúp tổ chức kết nối giữa các node theo mô hình tập trung, tránh việc một số cặp máy phải chuyển tiếp dữ liệu qua node khác như trong topology vòng.
Còn cụm 5–8 DGX Spark thì sao?
Trong tài liệu được bài gốc đề cập, NVIDIA chưa đưa ra phương án kết nối vòng không switch cho hơn 4 máy.
Với các cụm lớn hơn, tài liệu chỉ ra phương án sử dụng switch và cấu hình thủ công khi cần. Các cấu hình 6–8 máy được cộng đồng triển khai cũng sử dụng switch.
Vì vậy, nếu ngay từ đầu đã có kế hoạch mở rộng vượt quá 4 node, đầu tư hạ tầng mạng phù hợp có thể là hướng đi hợp lý hơn so với việc xây dựng một cấu hình vòng rồi phải thay đổi toàn bộ kiến trúc sau này.
6. Workload nào phù hợp với vòng 4 máy?
Không phải workload AI phân tán nào cũng nhạy cảm với giao tiếp mạng theo cùng một cách.
Pipeline parallelism chia mô hình thành các giai đoạn và phân bổ chúng trên những node khác nhau. Mức độ giao tiếp phụ thuộc vào cách phân chia mô hình, kích thước dữ liệu trung gian và số micro-batch.
Data parallelism phân phối dữ liệu hoặc các bản sao mô hình trên nhiều node. Hiệu năng phụ thuộc đáng kể vào cách đồng bộ gradient, lượng dữ liệu trao đổi và tần suất đồng bộ.
Ngược lại, tensor parallelism thường đòi hỏi trao đổi dữ liệu thường xuyên giữa các phần của mô hình. Với kiểu workload này, độ trễ và băng thông liên kết giữa các node có thể ảnh hưởng rõ rệt đến thời gian xử lý.
Do đó, tensor parallelism trên 4 node, chẳng hạn cấu hình TP=4, là trường hợp cần đặc biệt chú ý khi sử dụng topology vòng.
Dù vậy, không nên kết luận chỉ dựa trên lý thuyết kết nối. Cách tốt nhất là benchmark bằng chính mô hình và workload dự định triển khai, đồng thời so sánh thời gian xử lý, thông lượng và mức sử dụng tài nguyên giữa hai phương án mạng.
Kết luận: Giải pháp tiết kiệm chi phí, nhưng không thay thế hoàn toàn switch
NVIDIA đã chính thức đưa phương án kết nối vòng 4 DGX Spark không cần switch vào playbook hướng dẫn. Với 4 cáp QSFP112 DAC được phê duyệt và script setup-cluster.sh --topology ring, người dùng có thể xây dựng cụm 4 node mà không phải đầu tư thêm switch 200 GbE.
Đây là lựa chọn đáng chú ý cho những ai muốn thử nghiệm AI phân tán, tận dụng thiết bị sẵn có hoặc giảm chi phí xây dựng cụm ban đầu.
Tuy nhiên, cần nhớ ba điểm: cấu hình vòng 4 máy không hỗ trợ NVIDIA Sync theo hướng dẫn được đề cập; topology không phải full mesh; và hiệu năng thực tế có thể bị giới hạn bởi đường truyền cũng như đặc điểm của workload.
Nếu mục tiêu là thử nghiệm, học tập hoặc chạy workload ít nhạy cảm với giao tiếp liên node, kết nối vòng có thể là phương án hợp lý. Nếu thường xuyên chạy tensor parallelism, cần tối ưu hiệu năng hoặc dự định mở rộng quá 4 máy, switch 200 GbE vẫn là lựa chọn nên cân nhắc nghiêm túc.
Cuối cùng, thay vì chỉ nhìn vào chi phí cáp và thiết bị, hãy đánh giá tổng thể chi phí vận hành, hiệu năng ứng dụng và khả năng mở rộng. Một cụm rẻ hơn chưa chắc là cụm tiết kiệm hơn nếu thời gian xử lý tăng đáng kể.
Nguồn tham khảo
- NVIDIA – Connect Multiple DGX Sparks: Cable the Devices.
- NVIDIA – Connect Multiple DGX Sparks: Configure Manually.
- NVIDIA – DGX Spark User Guide: ConnectX-7 Networking.
- GitHub –
eugr/spark-vllm-docker, tài liệuNETWORKING.md.
Bài viết liên quan
- Hệ sinh thái châu Âu xây dựng các nhà máy AI hiệu quả nhất thế giới với NVIDIA DSX
- Từ cuDSS đến FOX Blueprint: Ngăn xếp GPU và thư viện NVIDIA trong kỹ thuật – sản xuất công nghiệp châu Âu
- Cách NVIDIA Mission Control 2.5 mang lại khả năng tự động phục hồi cho Kubernetes
- Phát triển Bản sao số Nhà máy AI với quy trình làm việc có sự hỗ trợ của tác tử
- Sử dụng AI Agents để dạy robot như Microduck đi bộ trong mô phỏng