Khi triển khai các mô hình khuếch tán trong các công cụ thiết kế, phần mềm chỉnh sửa ảnh và quy trình sáng tạo nội dung hình ảnh, nhà phát triển cần đặc biệt quan tâm đến độ trễ suy luận. Quá trình tạo ảnh phải thực hiện nhiều lượt tính toán tuần tự qua mô hình chứa hàng tỷ tham số. Khi độ phân giải ảnh tăng, chi phí tính toán của cơ chế attention cũng tăng theo.
FLUX 3 Image Klein là mô hình tạo và chỉnh sửa hình ảnh từ Black Forest Labs (BFL), được huấn luyện bằng NVIDIA GB200 NVL72 và được tối ưu hóa cho các GPU NVIDIA. Nó cung cấp các checkpoint Base và distilled đáp ứng các nhu cầu khác nhau về tốc độ xử lý và độ trung thực của hình ảnh.
Bài viết này hướng dẫn cách cấu hình FLUX 3 Image Klein trong NVIDIA TensorRT LLM VisualGen để tận dụng các kernel được hợp nhất, xử lý song song trên nhiều GPU, hỗ trợ các định dạng FP8/NVFP4, bộ nhớ đệm và các tối ưu hóa attention. Bài viết cũng so sánh độ trễ và mức độ thay đổi của ảnh đầu ra sau từng bước tối ưu hóa. Trong các bài kiểm tra 2048×2048 được báo cáo trên một GPU NVIDIA B200 đơn lẻ, việc kết hợp các phương pháp tối ưu hóa giúp tăng tốc quá trình tạo ảnh từ văn bản (T2I) nhanh hơn tới 3,46 lần và quá trình chỉnh sửa ảnh dựa trên ảnh đầu vào (I2I) nhanh hơn 4,45 lần cho FLUX 3 Image Klein Base so với suy luận BF16 nguyên bản, chưa qua biên dịch. Hướng dẫn bao gồm hướng dẫn triển khai và cấu hình YAML để áp dụng các tối ưu hóa này vào các tác vụ của bạn.
Suy luận FLUX 3 với TensorRT LLM VisualGen
FLUX 3 Image Klein sử dụng Qwen3-VL-4B-Instruct để xử lý điều kiện văn bản, mô hình biến đổi khuếch tán (DiT) để tinh chỉnh biểu diễn tiềm ẩn của ảnh, cùng một bộ mã hóa tự động (autoencoder) để giải mã biểu diễn này thành ảnh và mã hóa ảnh tham chiếu đầu vào cho tác vụ I2I. Klein xử lý luồng văn bản, ảnh đích đã được thêm nhiễu và ảnh tham chiếu (nếu có) riêng biệt trước khi kết hợp chúng bằng cơ chế attention kết hợp.
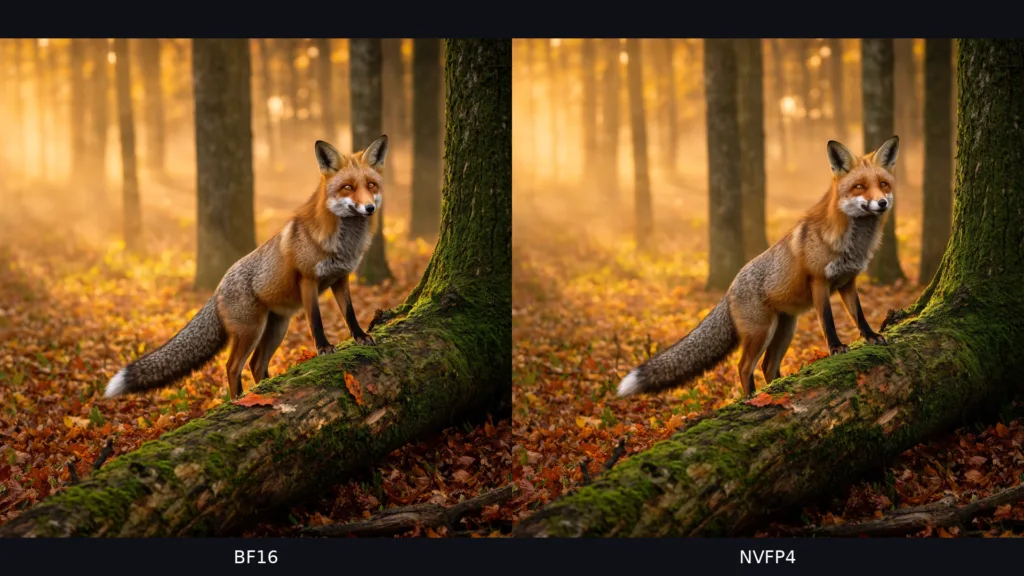
TensorRT LLM VisualGen, môi trường thực thi chuyên dụng trong TensorRT LLM, hỗ trợ các biến thể BF16, FP8 và NVFP4 ngay từ phiên bản đầu tiên. Trên GPU NVIDIA Blackwell, NVFP4 mang lại tốc độ tạo T2I nhanh hơn tới 1,62 lần và tốc độ tạo I2I nhanh hơn 1,58 lần so với BF16. Hình 2 so sánh độ trễ tạo hình, trong khi Hình 1 so sánh các ảnh đầu ra mẫu. Các phần tiếp theo sử dụng NVFP4 làm điểm khởi đầu cho việc tối ưu hóa thêm.
Hình 1 so sánh các đầu ra ở độ phân giải 2048×2048. Prompt T2I mô tả một bố cục tĩnh vật trong nhà bếp; prompt I2I yêu cầu các thay đổi đối với một cảnh không gian, bao gồm một hành tinh khí khổng lồ màu đỏ, một con rồng bạc và một tấm biển khắc.


Hình 1. Đầu ra BF16 và NVFP4 cho T2I và I2I

Với NVFP4 làm điểm khởi đầu, các tối ưu hóa của VisualGen chuyển sang khử nhiễu, yếu tố chiếm phần lớn thời gian tạo tổng thể trên B200. Do đó, việc tăng tốc DiT của FLUX 3 là trọng tâm của các phần tiếp theo.
Bảng 1 cho thấy độ trễ của toàn bộ pipeline ở độ phân giải 2048×2048 trên một GPU NVIDIA B200 sử dụng NVFP4, attention VANILLA và torch.compile. Kết quả được lấy trung bình trên 10 yêu cầu sau hai yêu cầu khởi động. Base sử dụng 50 bước khử nhiễu với thang độ dẫn hướng không có bộ phân loại (CFG) là 3,5; FLUX 3 Image Klein distilled sử dụng 16 bước mà không có CFG.
| Nhiệm vụ | Mô hình | Xử lý văn bản + chuẩn bị dữ liệu | Khử nhiễu | Giải mã + hậu xử lý | Tổng | Tỷ trọng thời gian khử nhiễu |
|---|---|---|---|---|---|---|
| T2I | Base | 47 ms | 14,24 s | 416 ms | 14,70 s | 96,8% |
| T2I | Bản distilled | 24 ms | 2,28 s | 410 ms | 2,71 s | 84,0% |
| I2I | Base | 468 ms | 39,40 s | 417 ms | 40,29 s | 97,8% |
| I2I | Bản distilled | 407 ms | 6,65 s | 418 ms | 7,48 s | 89,0% |
Tối ưu hóa FLUX 3 trong TensorRT LLM VisualGen
TensorRT LLM VisualGen tăng tốc suy luận NVFP4 DiT bằng các kernel nhân ma trận tổng quát (GEMM) được tối ưu hóa và hợp nhất epilogue, attention độ chính xác thấp và attention thưa, bộ nhớ đệm, và thực thi đa GPU. Trừ khi có ghi chú khác, các benchmark sau sử dụng torch.compile và seed 0. Base sử dụng 50 bước khử nhiễu và thang CFG là 3,5; Klein được chưng cất sử dụng 16 bước khử nhiễu.
Suy luận NVFP4
VisualGen hỗ trợ các checkpoint DiT NVFP4 đã lượng tử hóa trước của BFL dành cho FLUX 3 Image Klein và FLUX 3 Image Klein Base. Để sử dụng các checkpoint này, hãy đặt variant thành nvfp4 trong pipeline_config:
pipeline_config:
  variant: nvfp4
Tối ưu hóa kernel GEMM
TensorRT LLM VisualGen sử dụng các kernel GEMM FP8/NVFP4 PrimsTS của FlashInfer, được xây dựng bằng CUTLASS Primitives và Task Scheduling để tăng tốc suy luận lượng tử hóa. Được tinh chỉnh cho các hình dạng tensor của FLUX 3 và được bật theo mặc định, chúng kết hợp các GEMM được tối ưu hóa với các epilogue được hợp nhất, bao gồm GEMM với SwiGLU và các phép chiếu query, key và value (QKV) với chuẩn hóa query/key và nhúng vị trí quay (RoPE). Xem FlashInfer PR #5758 để biết thêm chi tiết.
Vào thời điểm ra mắt, các kernel NVFP4 PrimsTS cố định đã mang lại tốc độ sinh T2I nhanh hơn 1,02–1,10 lần trên B200 so với triển khai GEMM NVFP4 TensorRT LLM được tự động tinh chỉnh.

Chú ý đến lượng tử hóa và tính thưa
Attention là một điểm nghẽn chính trong việc tạo ảnh độ phân giải cao. Trong các thử nghiệm T2I NVFP4 2048×2048 được báo cáo trên B200, attention VANILLA BF16 chiếm khoảng 60% thời gian kernel GPU của DiT cho cả Base và Klein đã chưng cất. VisualGen hỗ trợ hai cách tiếp cận để giảm chi phí này: attention lượng tử hóa với cuDNN FP8 hoặc VC-Attention FP8, và attention thưa với Sol-Attention. VC-Attention FP8 là một biến thể TensorRT LLM của phương pháp được mô tả trong bài báo VC-Attention.
Độ tương tự Patch Ảnh Nhận thức Học được (LPIPS) đo mức độ khác biệt về mặt cảm nhận giữa các ảnh được tạo. Trong các so sánh sau, điểm càng thấp thì ảnh càng giống với ảnh đầu ra VANILLA baseline tương ứng.
So với attention VANILLA BF16, cuDNN FP8 giúp tăng tốc độ tạo ảnh lên 1,08 lần cho Base và 1,09 lần cho FLUX 3 Image Klein distilled 16 bước. Điểm LPIPS tương ứng là 0,072 và 0,161. VC-Attention FP8 giúp tăng tốc lên 1,18 lần cho Base và 1,16 lần cho FLUX 3 Image Klein distilled, với điểm LPIPS tương ứng là 0,086 và 0,151.
Hình 4 so sánh đầu ra FLUX 3 Image Klein Base NVFP4 ở độ phân giải 2048×2048 với CUDA Graphs được bật.
Kết quả thử nghiệm cho thấy nên sử dụng VC-Attention FP8 cho attention lượng tử hóa ở độ phân giải 2048×2048 trên B200. Cấu hình được kiểm tra sử dụng ngân sách sửa chữa ρ=0.005 để chọn tỷ lệ token có lỗi lượng tử hóa cao nhất cho việc hiệu chỉnh phần dư. Để bật attention lượng tử hóa, hãy thay thế attention_config bằng một trong các cấu hình sau:
Đối với cuDNN FP8:
attention_config:
  backend: CUDNN
  quant_attention_config:
    qk_dtype: fp8
    v_dtype: fp8
Đối với VC-Attention FP8:
attention_config:
    backend: TRTLLM
    quant_attention_config:
        qk_dtype: fp8
        v_dtype: fp8
        vc_attention: true
        vc_repair_budget: 0.005


Hình 4. Ví dụ về đầu ra của BF16, cuDNN FP8 và VC-Attention FP8
Sol-Attention giảm lượng tính toán của DiT bằng mức độ thưa được điều khiển bằng τ. Các bài kiểm tra được báo cáo sử dụng kernel chú ý khối thưa tổng quát dựa trên PrimsTS trong TensorRT LLM. Cấu hình Sol-Attention như sau:
attention_config:
  backend: TRTLLM
  sparse_attention_config:
    algorithm: sol_attn
    tau: 1.0
    disabled_until_timestep: 0.96
Đối với NVFP4 FLUX 3 Image Klein Base ở độ phân giải 2048×2048 trên B200, Sol-Attention với τ=1.0 đã mang lại tốc độ khử nhiễu và giải mã autoencoder nhanh hơn 1,24 lần so với VANILLA dense được biên dịch với 16 bước dense ban đầu, hoặc nhanh hơn 1,30 lần với 12 bước.
Kết quả thử nghiệm cho thấy nên sử dụng 16 bước dense ban đầu để ưu tiên độ trung thực hoặc 12 bước để ưu tiên tốc độ. τ cao hơn làm giảm chất lượng đầu ra với rất ít tăng tốc bổ sung.
Hình 5 so sánh các đầu ra NVFP4 FLUX 3 Image Klein Base ở 2048×2048 với CUDA Graphs được bật và τ=1.0.


Hình 5. Đầu ra của Dense attention và Sol-Attention với 16 hoặc 12 bước dense ban đầu
Cơ chế cache theo bước (Step caching)
Cache-DiT giảm độ trễ suy luận của FLUX 3 Image Klein bằng cách tái sử dụng đầu ra trung gian của Transformer giữa các bước khử nhiễu mà không cần huấn luyện lại hoặc thay đổi trọng số mô hình. Một ngưỡng chênh lệch phần dư kiểm soát thời điểm các đầu ra được lưu trong bộ nhớ đệm được tái sử dụng, giúp điều chỉnh mức cân bằng giữa tốc độ suy luận và chất lượng ảnh đầu ra. Cấu hình Cache-DiT với các tham số mong muốn của bạn:
cache_config:
  cache_backend: cache_dit
  Fn_compute_blocks: 1
  Bn_compute_blocks: 0
  max_warmup_steps: 4
  max_continuous_cached_steps: 3
  residual_diff_threshold: 0.24
Khi đặt ngưỡng ở mức 0,24, Cache-DiT giúp giảm gần một nửa độ trễ NVFP4 Base T2I ở cả hai độ phân giải được kiểm tra, với mức cải thiện nhỏ hơn cho Klein đã chưng cất. Ở 1024×1024, tốc độ tăng lên 1,97 lần cho Base và 1,26 lần cho Klein đã chưng cất, với các điểm LPIPS tương ứng là 0,038 và 0,036 so với đầu ra không có bộ nhớ đệm tương ứng. Ở 2048×2048, tốc độ tăng lên 1,94 lần cho Base và 1,20 lần cho Klein đã chưng cất (Hình 6).


Hình 6. Đầu ra của Klein cơ bản và đã chưng cất, có và không có Cache-DiT
Suy luận đa GPU
Bộ thực thi VisualGen trong TensorRT LLM mở rộng FLUX 3 Image Klein bằng cách sử dụng classifier-free guidance (CFG) và song song hóa chuỗi Ulysses. Base gán các nhánh dương/âm cho các nhóm GPU riêng biệt và phân đoạn chuỗi của từng nhánh bằng Ulysses; distilled chạy không có CFG và chỉ sử dụng Ulysses.
VisualGen xử lý việc chia chuỗi, chú ý phân tán và thu thập đầu ra. Đối với suy luận Base NVFP4 trên tám GPU, hãy sử dụng cấu hình sau:
parallel_config:
    cfg_size: 2
    ulysses_size: 4
Đối với mô hình đã chưng cất, đặt cfg_size: 1, ulysses_size: 8 và sử dụng checkpoint flux-3-image-klein.
Ở độ phân giải 2048×2048, việc tăng số GPU từ một lên tám trên NVIDIA DGX B200 đã giảm độ trễ T2I trung vị từ 14,90 xuống 3,00 giây cho Base và từ 2,73 xuống 1,08 giây cho mô hình chưng cất. Tốc độ khử nhiễu tăng cao hơn, đạt 6,01 lần cho Base và 4,44 lần cho FLUX 3 Image Klein distilled, nhưng khoảng một nửa thời gian tạo ảnh chưng cất trên tám GPU vẫn nằm ngoài quá trình khử nhiễu, khiến mức cải thiện tổng thể bị giới hạn.

Ở các độ phân giải nhỏ hơn, CUDA Graphs bổ trợ cho sự song song bằng cách giảm chi phí khởi chạy kernel khi khối lượng công việc trên mỗi GPU giảm xuống. Trong một thí nghiệm NVFP4 1024×1024 riêng biệt trên tám B200 với VANILLA attention, việc thêm CUDA Graphs vào quá trình biên dịch đã giảm độ trễ Base từ 1,823 xuống còn 0,809 giây (2,25 lần, CFG trên hai nhóm GPU với Ulysses trên bốn GPU mỗi nhóm) và độ trễ distilled từ 0,791 xuống còn 0,366 giây (2,16 lần, Ulysses trên tám GPU). Bật CUDA Graphs với cấu hình sau:
cuda_graph_config:
    enable: true
Hiệu năng tổng thể (end-to-end) của FLUX 3
Ở kích thước 2048×2048, Hình 8 so sánh mức tăng tốc tạo ảnh trên toàn bộ quy trình qua từng giai đoạn tối ưu hóa liên tiếp trong TensorRT LLM VisualGen so với suy luận BF16 VANILLA chưa được biên dịch.
Trên một GPU B200 duy nhất, quá trình biên dịch, NVFP4 với PrimsTS GEMMs, Sol-Attention và Cache-DiT giúp tăng tốc độ tạo ảnh lên 3,46 lần cho T2I, giảm giảm độ trễ từ 22,36 xuống còn 6,46 giây, và tốc độ nhanh hơn 4,45 lần cho I2I, giảm giảm độ trễ từ 54,64 xuống còn 12,28 giây. Mô hình Klein được chưng cất 16 bước đạt tốc độ đầu-cuối (end-to-end) nhanh hơn tới 2,34 lần.
Trên một GPU NVIDIA RTX PRO 6000 Blackwell Server Edition duy nhất, quá trình biên dịch, NVFP4 với các kernel CuTe DSL được hợp nhất và Cache-DiT giúp tăng tốc độ tạo ảnh lên từ 1,73 đến 3,25 lần, mở rộng lợi ích trên cả hai nền tảng. Hình 9 và 10 so sánh các ảnh đầu ra mẫu qua các giai đoạn tối ưu hóa.

Các ví dụ trong Hình 9 và Hình 10 được tạo trên một GPU B200 duy nhất.


Hình 9. Đầu ra T2I của FLUX 3 Image Klein Base qua các giai đoạn tối ưu hóa
Lệnh chỉnh sửa yêu cầu vẻ ngoài cũ kỹ cho chiếc xuồng, đồng thời giữ nguyên hình dạng, vị trí và cảnh xung quanh.


Hình 10. Đầu ra I2I của FLUX 3 Image Klein Base qua các giai đoạn tối ưu hóa
Để áp dụng những phương pháp tối ưu hóa này vào workload của bạn, hãy làm theo các thiết lập thời gian chạy, lệnh suy luận và cấu hình YAML trong các phần sau cho việc tạo ảnh ngoại tuyến hoặc phục vụ trực tuyến.
Điều kiện tiên quyết
Khởi chạy container TensorRT LLM đã được build sẵn bằng lệnh sau. Để xây dựng từ nhánh feat/flux3-image-klein, hãy làm theo hướng dẫn triển khai FLUX 3.
docker run --rm -it --ipc=host --gpus all -p 8000:8000 \
      --name tensorrt_llm \
      -e TLLM_FMHA_LIBS=+prims_ts \
      -e HF_TOKEN= \
      -v ~/.cache:/root/.cache:rw \
      nvcr.io/nvidia/tensorrt-llm/release:feat-flux3-image-klein-1.4.0a0.dev202610280436
TLLM_FMHA_LIBS=+prims_ts kích hoạt các kernel attention PrimsTS mà VC-Attention yêu cầu. Các tối ưu hóa và kết quả trong bài viết này tập trung vào các GPU trung tâm dữ liệu NVIDIA Blackwell và các GPU NVIDIA RTX PRO 6000 Blackwell Server Edition.
Bắt đầu với TensorRT LLM VisualGen
Sau khi môi trường runtime đã sẵn sàng, bạn có thể chạy FLUX 3 ngoại tuyến hoặc cung cấp dịch vụ thông qua một điểm cuối tạo ảnh. Sử dụng các cấu hình YAML mẫu trong các phần sau để áp dụng các cài đặt tối ưu hóa đã được sử dụng cho các kết quả được báo cáo trước đó.
Các ví dụ này không mở rộng prompt. Nếu bạn sử dụng trình mở rộng prompt của BFL, hãy chạy nó riêng trước khi suy luận. Độ trễ được báo cáo không bao gồm việc mở rộng prompt.
Chạy suy luận offline
Bên trong container, chạy ví dụ FLUX 3:
cd /app/tensorrt_llm/examples/visual_gen
python models/flux3.py \
  --model black-forest-labs/flux-3-image-klein-base \
  --visual_gen_args configs/flux3-images-1gpu.yaml \
  --prompt "A small robot tending a rooftop garden at sunrise" \
  --height 2048 --width 2048 --seed 0 \
  --output_path flux3.png
Đối với NVFP4 trên Blackwell, thêm --variant nvfp4; sử dụng --variant fp8r cho FP8 theo hàng hoặc bỏ qua --variant cho BF16. Chọn black-forest-labs/flux-3-image-klein cho mô hình đã chưng cất. Để chỉnh sửa, thêm một prompt chỉnh sửa và --image /path/to/reference.png; lặp lại --image cho nhiều hình tham chiếu.
Endpoint phục vụ trực tuyến
Từ cùng thư mục container, khởi động điểm cuối /v1/images/generations tương thích với OpenAI:
cd /app/tensorrt_llm/examples/visual_gen
trtllm-serve black-forest-labs/flux-3-image-klein-base \
  --host 0.0.0.0 --port 8000 \
  --visual_gen_args configs/flux3-images-1gpu.yaml
Sau khi máy chủ khởi động thành công, mở một terminal thứ hai, vào container đang chạy và thực thi client:
docker exec -it tensorrt_llm bash
python examples/visual_gen/serve/sync_image_gen.py \
  --base-url http://localhost:8000/v1 \
  --model black-forest-labs/flux-3-image-klein-base \
  --size 2048x2048 \
  --prompt "A small robot tending a rooftop garden at sunrise" \
  --output flux3-served.png
Đối với việc phục vụ NVFP4, hãy thêm pipeline_config: {variant: nvfp4} vào tệp YAML trước khi khởi động máy chủ; sử dụng fp8r cho FP8.
Cấu hình tối ưu cho một GPU
Đối với suy luận 2048×2048 trên một B200, hãy lưu nội dung sau dưới dạng configs/flux3-nvfp4-vc-fp8-1gpu.yaml, kết hợp trọng số NVFP4, torch.compile và VC-Attention FP8.
pipeline_config:
  variant: nvfp4
torch_compile_config:
  enable: true
compilation_config:
  resolutions: [[2048, 2048]]
  num_frames: [1]
  modes: [t2i, i2i]
attention_config:
  backend: TRTLLM
  quant_attention_config:
    qk_dtype: fp8
    v_dtype: fp8
    vc_attention: true
    vc_repair_budget: 0.005
Đối với Sol-Attention và Cache-DiT, hãy sao chép tệp này vào configs/flux3-nvfp4-sol-cache-1gpu.yaml, thay thế attention_config và thêm cache_config:
pipeline_config:
  variant: nvfp4
torch_compile_config:
  enable: true
compilation_config:
  resolutions: [[2048, 2048]]
  num_frames: [1]
  modes: [t2i, i2i]
attention_config:
  backend: TRTLLM
  sparse_attention_config:
    algorithm: sol_attn
    tau: 1.0
    disabled_until_timestep: 0.96
cache_config:
  cache_backend: cache_dit
  Fn_compute_blocks: 1
  Bn_compute_blocks: 0
  max_warmup_steps: 4
  max_continuous_cached_steps: 3
  residual_diff_threshold: 0.24
Ngưỡng cắt thời gian (timestep cutoff) 0,96 giữ cho 12 bước khử nhiễu đầu tiên ở mật độ cao cho FLUX 3 Image Klein Base 50 bước và 4 bước đầu tiên ở mật độ cao cho FLUX 3 Image Klein distilled 16 bước dưới lịch trình α=6,93 được đóng gói. Đối với cài đặt 16 bước mật độ cao được khuyến nghị ở trên, hãy đặt disabled_until_timestep: 0,94. Ngưỡng cắt chỉ định mức nhiễu chứ không phải số bước. Xóa cache_config để sử dụng Sol-Attention không có Cache-DiT.
Đặt --visual_gen_args trong các lệnh suy luận ngoại tuyến hoặc phục vụ thành đường dẫn của tệp YAML đã chọn của bạn. Đặt kích thước ảnh thành 2048×2048 để khớp với các ví dụ hiệu suất.
Kết luận và hướng triển khai tiếp theo
TensorRT LLM VisualGen hỗ trợ chạy suy luận FLUX 3 Image Klein với nhiều tùy chọn tối ưu hiệu năng có thể cấu hình. NVFP4, các kernel được hợp nhất, biên dịch, thực thi đa GPU và CUDA Graphs giúp tăng tốc thực thi; attention lượng tử hóa và thưa cùng bộ đệm cung cấp thêm mức giảm độ trễ với tác động có thể đo được đến chất lượng đầu ra. Kết hợp lại, chúng mang lại tốc độ tạo T2I nhanh hơn tới 3,46 lần và I2I nhanh hơn 4,45 lần khi sử dụng một GPU duy nhất trên NVIDIA DGX B200, so với suy luận BF16 VANILLA chưa được biên dịch.
Bắt đầu:
- Chạy ví dụ FLUX 3 từ đầu đến cuối
- Khám phá runtime và tiện ích tối ưu hóa của TensorRT LLM VisualGen
- Gửi báo cáo lỗi hoặc chia sẻ kết quả trên TensorRT LLM GitHub
Bài viết liên quan
- CUDA 13.5 Toolkit: hỗ trợ GA cho Vera Rubin, MPS v3, CUDA Tile đa GPU và CCCL 3.5
- NVIDIA Nemotron 3.5 Super VL: xây dựng agent chuyên biệt với suy luận đa phương thức
- RTX Spark sau 30 ngày: hiệu năng thực chiến và kịch bản triển khai AI cục bộ
- Từ cuDSS đến FOX Blueprint: Ngăn xếp GPU và thư viện NVIDIA trong kỹ thuật – sản xuất công nghiệp châu Âu
- Chạy các mô hình AI Frontier-Class trên 8 nodes NVIDIA DGX Spark