Các tác nhân luôn hoạt động (always-on agents) đang đảm nhận các quy trình doanh nghiệp dài hơn và phức tạp hơn. Một yêu cầu duy nhất có thể bao gồm việc đọc tài liệu, kiểm tra thông tin từ nhiều nguồn, tuân thủ chính sách công ty và gọi một số công cụ.
NVIDIA Nemotron 3.5 Super VL là một mô hình đa phương thức mở, có thể tùy chỉnh cho các quy trình chuyên biệt này. Kiến trúc mixture-of-experts (MoE) 120B tham số của nó kích hoạt 12B tham số cho mỗi token, cân bằng giữa sức mạnh mô hình và hiệu quả suy luận.
Trên một GPU duy nhất, mô hình này mang lại thông lượng cao hơn tới 5 lần cho các tác vụ agent so với các mô hình mở khác trong cùng phân khúc kích thước.
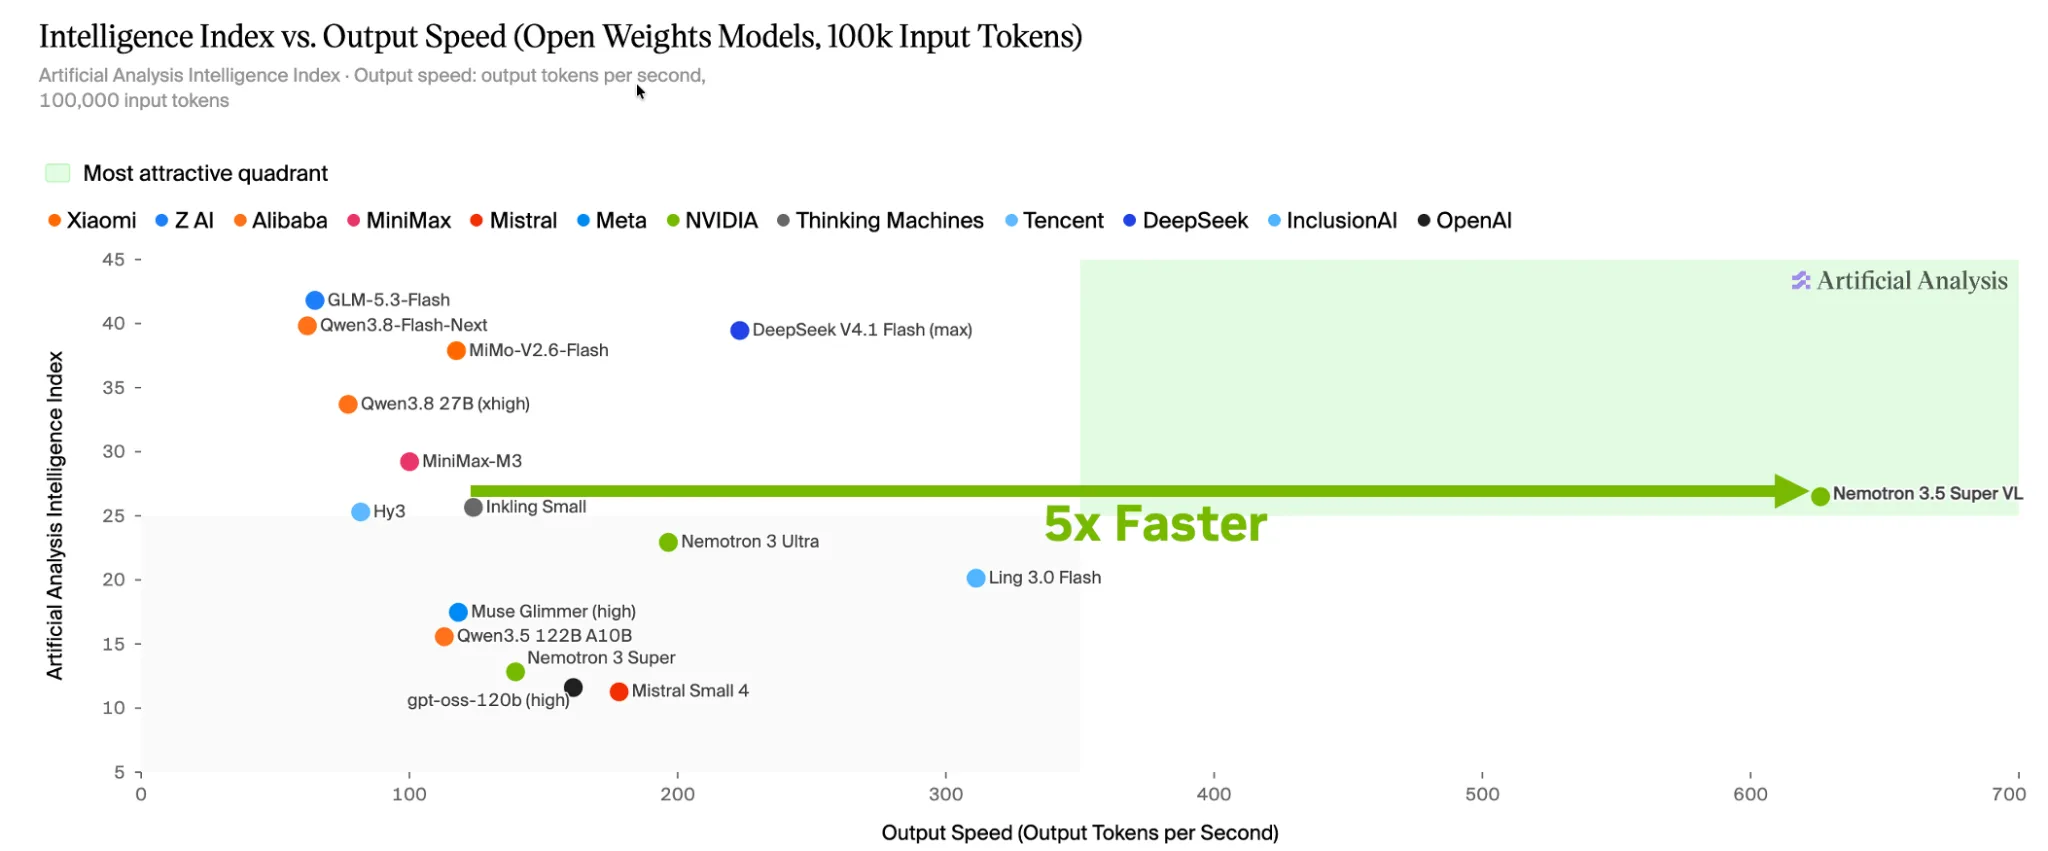 Hình 1. Nemotron 3.5 Super VL đạt hơn 600 TPS trong các tác vụ agent trên chỉ số phân tích trí tuệ Artificial Analysis tại endpoint Baseten
Mô hình kết hợp khả năng suy luận, tuân theo chỉ thị và sử dụng công cụ với việc hiểu văn bản, hình ảnh, tài liệu và video. Bằng cách kết hợp các khả năng này vào một mô hình duy nhất, các nhóm có thể xử lý các tác vụ văn bản và thị giác mà không cần triển khai các mô hình thị giác-ngôn ngữ văn bản và thị giác riêng biệt hoặc truyền ngữ cảnh tác vụ giữa chúng.
Các nhà phát triển có thể huấn luyện sau (post-train) Nemotron 3.5 Super VL bằng NVIDIA NeMo sử dụng dữ liệu, công cụ, chính sách và quy trình làm việc của riêng họ. Bài viết này giải thích cách sử dụng nền tảng đó để xây dựng các tác nhân doanh nghiệp chuyên dụng và mô tả các kỹ thuật huấn luyện và suy luận hỗ trợ cho nó.
Tại sao chọn Nemotron 3.5 Super VL cho các tác nhân chuyên biệt?
Các tác nhân cần hiểu cả nhiệm vụ của chúng lẫn môi trường hoạt động. Một tác nhân dịch vụ khách hàng phải tuân thủ chính sách hoàn hàng của công ty. Các tác nhân nghiên cứu kết nối bằng chứng giữa các nguồn, trong khi các tác nhân tài liệu diễn giải bảng biểu, biểu đồ và bố cục trang.
Nemotron 3.5 Super VL kết hợp khả năng suy luận và hiểu thị giác trong nhiều quy trình làm việc của tác tử, bao gồm:
- Lập trình: Kiểm thử và xác thực mã, phân tích lỗi và đề xuất cách sửa.
- Nghiên cứu trên web: Tìm kiếm trên các trang web, kết nối thông tin và xác minh câu trả lời.
- Trí tuệ tài liệu: Trích xuất thông tin từ bảng biểu, biểu đồ và bố cục trang để tạo ra các bản tóm tắt và báo cáo.
- An ninh mạng: Xác định các lỗ hổng bảo mật và phân loại mối đe dọa để ưu tiên khắc phục.
- Hiểu video: Trích xuất thông tin cho tìm kiếm, xem xét nội dung và phân tích sự cố.
Trong một hệ thống các mô hình, Nemotron 3.5 Super VL xử lý các công việc chuyên biệt, nhiều bước đòi hỏi khả năng suy luận, sử dụng công cụ và hiểu biết kết hợp giữa văn bản và hình ảnh. Các mô hình nhỏ hơn, chẳng hạn như NVIDIA Nemotron 3.5 Lightning, xử lý các tác vụ văn bản có khối lượng lớn, trong khi các mô hình tiên phong như NVIDIA Nemotron 3 Ultra giải quyết các vấn đề lập kế hoạch và điều phối phức tạp.
Tùy chỉnh Nemotron 3.5 Super VL cho dữ liệu, công cụ và chính sách của lĩnh vực
Các tác nhân chuyên dụng phải học cách một tổ chức vận hành. Thuật ngữ chuyên ngành, giao diện công cụ, quy trình vận hành và yêu cầu chính sách định hình cách các tác nhân hoàn thành nhiệm vụ một cách thành công.
Các tổ chức trong các ngành từ an ninh mạng, tài chính đến y tế đang huấn luyện hậu (post-training) Nemotron 3.5 Super VL để vượt trội hơn các mô hình tiên phong về độ chính xác và hiệu quả trong các quy trình sản xuất của họ. Ví dụ:
- Scale AI, một nhà cung cấp dữ liệu và công nghệ AI, đã huấn luyện lại Nemotron 3.5 Super VL để xử lý tín dụng nhà cung cấp tự động tại Skydance Corporation, một công ty truyền thông và giải trí. Chi phí suy luận cho tác vụ này sẽ giảm 40 lần và độ trễ giảm 5 lần.
- Ramp, một nhà cung cấp nền tảng vận hành tài chính, đang chuyển đổi hình ảnh hóa đơn thành JSON có cấu trúc chứa thông tin thương nhân, ngày tháng và dữ liệu thanh toán. Ramp kỳ vọng thông lượng cao hơn tới 50% và độ trễ thấp hơn 10 lần.
- AI21 và Alice đã hậu huấn luyện Nemotron 3.5 Super VL cho tình báo mối đe dọa và phân tích lỗ hổng, cải thiện độ chính xác lên 41%.
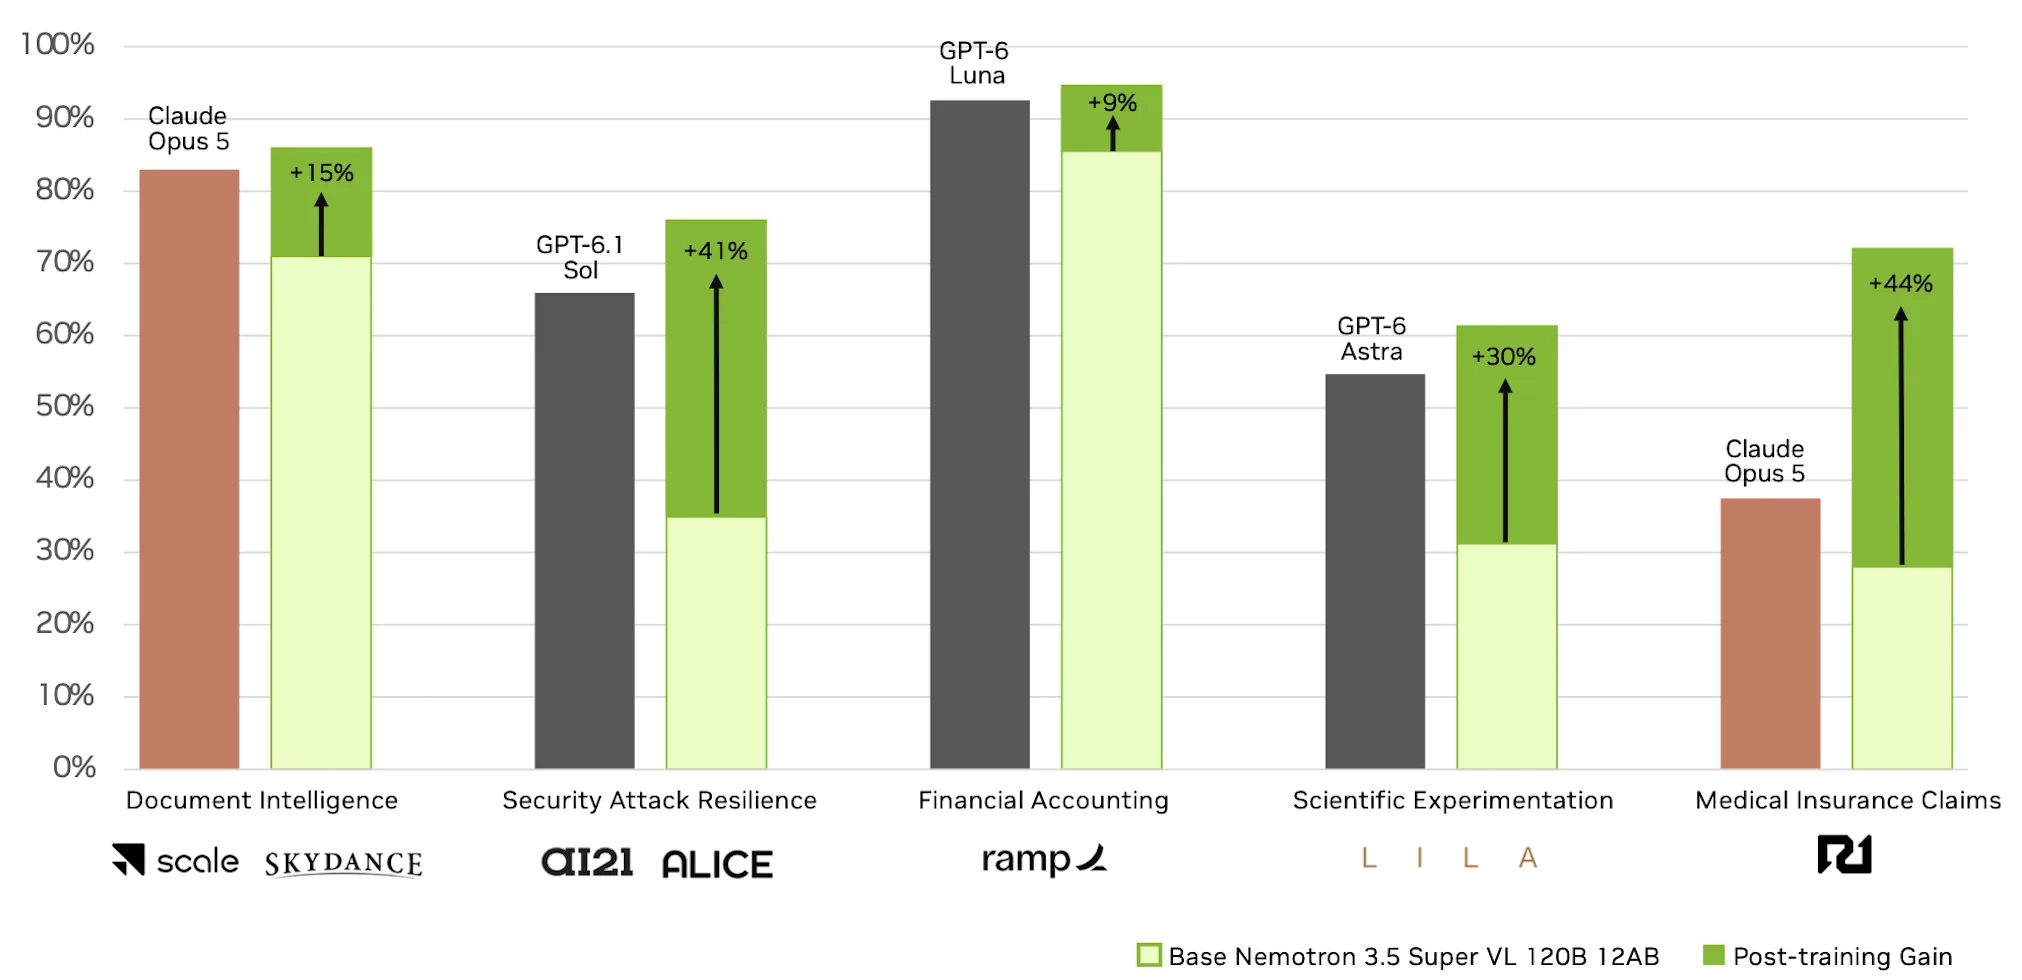 Hình 2. Nemotron 3.5 Super VL sau hậu huấn luyện đạt hiệu suất hàng đầu cho các tác vụ chuyên biệt trên nhiều ngành
Các nhóm có thể sử dụng các thư viện mở NVIDIA NeMo để huấn luyện hậu (post-train) các mô hình nhằm đáp ứng những yêu cầu này. Các nhà phát triển có thể sử dụng NVIDIA NeMo AutoModel để tinh chỉnh giám sát (SFT) và thích ứng hạng thấp (LoRA) nhằm dạy các hành vi đặc thù theo lĩnh vực. Học tăng cường (RL) cải thiện hiệu suất trong các môi trường tác nhân (agentic) phản ánh quy trình làm việc của tổ chức.
Song song với Nemotron 3.5 Super VL, NVIDIA đang phát hành các bộ dữ liệu mở trên Hugging Face. Các bộ dữ liệu này bao gồm dữ liệu sử dụng công cụ tác nhân và hội thoại, bộ dữ liệu suy luận tài chính và gọi công cụ, dữ liệu tuân theo chỉ thị và trò chuyện, dữ liệu chuyển đổi và dịch ngữ cảnh dài, dữ liệu công bằng, cùng 40 bộ dữ liệu thị giác-ngôn ngữ. Những bộ dữ liệu này có thể bổ sung cho dữ liệu độc quyền trong SFT và RL.
Đối với dữ liệu đa phương thức, hãy bắt đầu với các tài nguyên NeMo Data Designer dành cho trả lời câu hỏi về biểu đồ và hiểu tài liệu dài. Khám phá NVIDIA NeMo RL và NVIDIA NeMo Gym để đánh giá dựa trên RL và môi trường.
Các tổ chức có thể điều chỉnh và triển khai trọng số mở của mô hình trong các môi trường cục bộ, trung tâm dữ liệu hoặc đám mây được hỗ trợ để đáp ứng các yêu cầu về hạ tầng và dữ liệu của họ. Để biết thêm về các tài nguyên tùy chỉnh, hãy xem sách hướng dẫn sử dụng Nemotron 3.5 Super VL trên GitHub.
Kết hợp hiểu biết văn bản và thị giác trong một quy trình duy nhất
Nemotron 3.5 Super VL kết hợp hiểu biết về văn bản, hình ảnh, tài liệu và video với khả năng suy luận và tuân theo chỉ thị để trả lời các câu hỏi xuyên suốt các đầu vào này.
Quá trình đào tạo thị giác bao gồm biểu đồ, bảng biểu, nhận dạng ký tự quang học (OCR), tài liệu nhiều trang và khả năng hiểu video. Quy trình SFT hai giai đoạn đào tạo các thành phần ngôn ngữ và thị giác, kết hợp bằng chứng thị giác với suy luận, trò chuyện, an toàn, dữ liệu ngữ cảnh dài và các quỹ đạo tác nhân.
Đối với trí tuệ tài liệu, cùng một mô hình có thể diễn giải một biểu đồ, liên kết nó với một bảng biểu ở nơi khác trong tài liệu và tóm tắt cả hai. Các nhà phát triển có thể tùy chỉnh quy trình làm việc theo tài liệu và tiêu chí đánh giá của riêng họ.
Dữ liệu huấn luyện đa dạng được tạo ra bằng NeMo Data Designer đã giúp mô hình hiểu tốt hơn các biểu đồ phức tạp. Trên CharXiv, một bộ benchmark về suy luận biểu đồ, mô hình đạt 80,8%, so với 63% của Nemotron 3 Nano Omni. Với khả năng diễn giải mã Python, mô hình đạt 84%. Để biết thêm về phương pháp và những bài học rút ra, hãy đọc bài phân tích chuyên sâu về hiểu biểu đồ và đường ống câu hỏi-trả lời biểu đồ mã nguồn mở.
Mô hình này được xây dựng với sự hỗ trợ và chuyên môn từ các tổ chức thuộc Nemotron Coalition. Ví dụ, các bộ dữ liệu chất lượng cao từ Perplexity đã giúp cải thiện và tối ưu hóa quá trình huấn luyện giữa của mô hình. Các môi trường từ Prime Intellect cho phép xây dựng các mô hình giáo viên tốt hơn.
Nemotron 3.5 Super VL cũng là một trong những mô hình mã nguồn mở hàng đầu trên bảng xếp hạng OCRBench v2.
Độ chính xác và hiệu quả trong các tác vụ agent
Các đánh giá của Nemotron 3.5 Super VL bao gồm Hermes, LangChain, OpenClaw, OpenCode, Pi, Codex và Claude. Ngoài các tác vụ lập trình, các nhà cung cấp khung agent sử dụng các đánh giá riêng của họ để kiểm tra một loạt các tác vụ agent. Trên Hermes Bench và các đánh giá hành vi của LangChain, Nemotron 3.5 Super VL đạt điểm cao hơn Nemotron 3 Ultra.
| Mô hình | Hermes Bench | LangChain Evals |
|---|---|---|
| Nemotron 3 Ultra | 56,33% | 84,3% |
| Nemotron 3.5 Super VL | 63,44% | 87,05% |
Bảng 1. Nemotron 3.5 Super VL đạt điểm cao hơn Nemotron 3 Ultra trong các đánh giá Hermes Bench và LangChain
Đối với các tác nhân hoạt động liên tục, hiệu quả quyết định mức độ công việc mà một triển khai có thể hoàn thành. Thông lượng, mức sử dụng token, các cuộc gọi công cụ và số bước cần thiết để đạt được kết quả chính xác đều ảnh hưởng đến thời gian hoàn thành tác vụ.
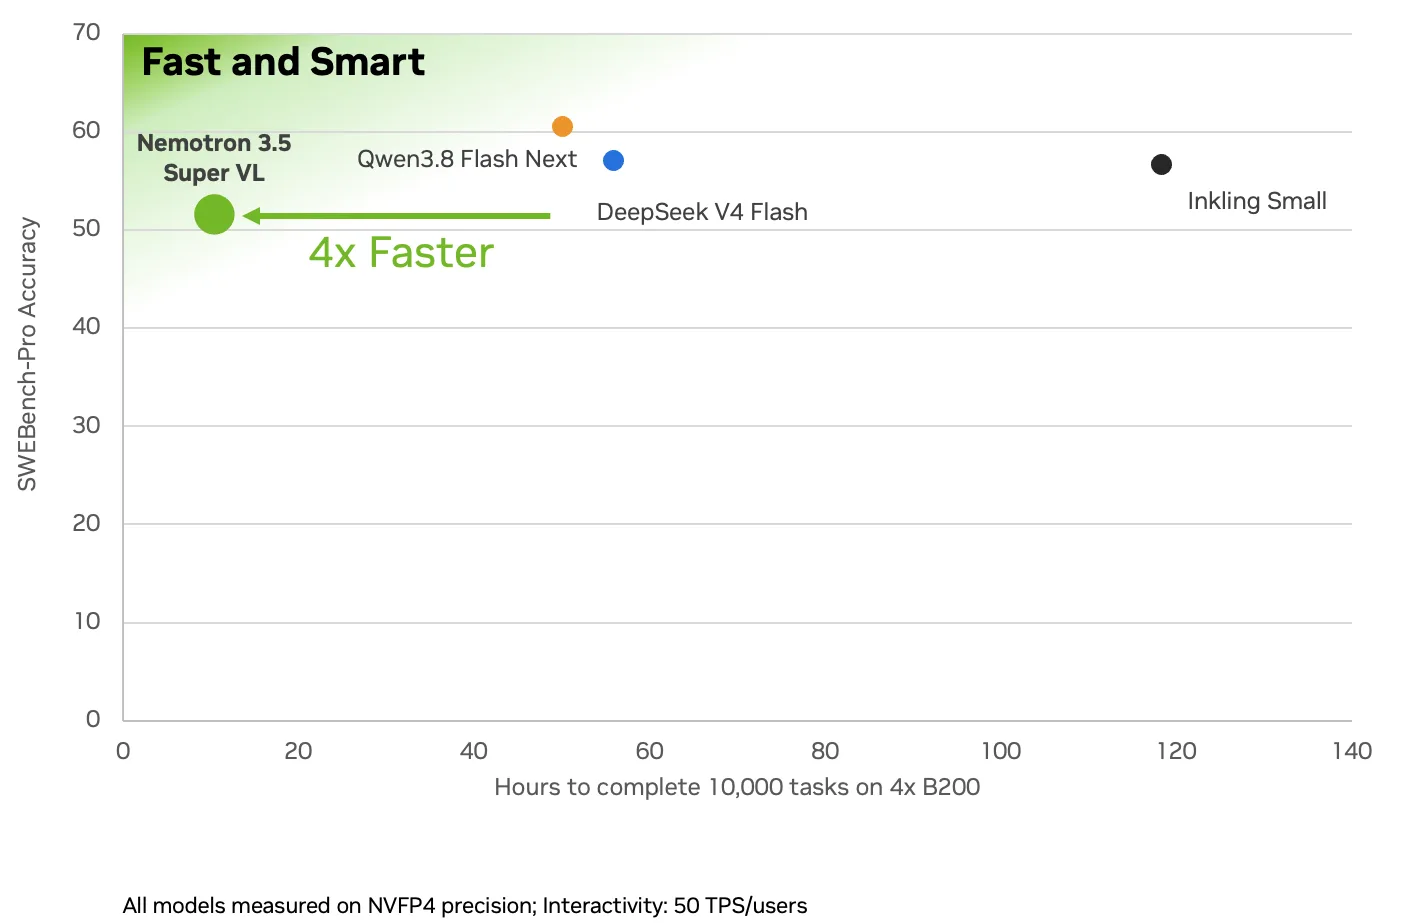 Hình 3. Nemotron 3.5 Super VL sử dụng thông lượng cao hơn và hiệu quả token tốt hơn để hoàn thành tác vụ nhanh gấp 4 lần
Mô hình này cũng được tối ưu hóa để chạy cục bộ trên NVIDIA DGX Spark. Một đánh giá độc lập từ EXO Labs đã xếp Nemotron 3.5 Super VL vào biên Pareto về độ chính xác và thời gian hoàn thành tác vụ.
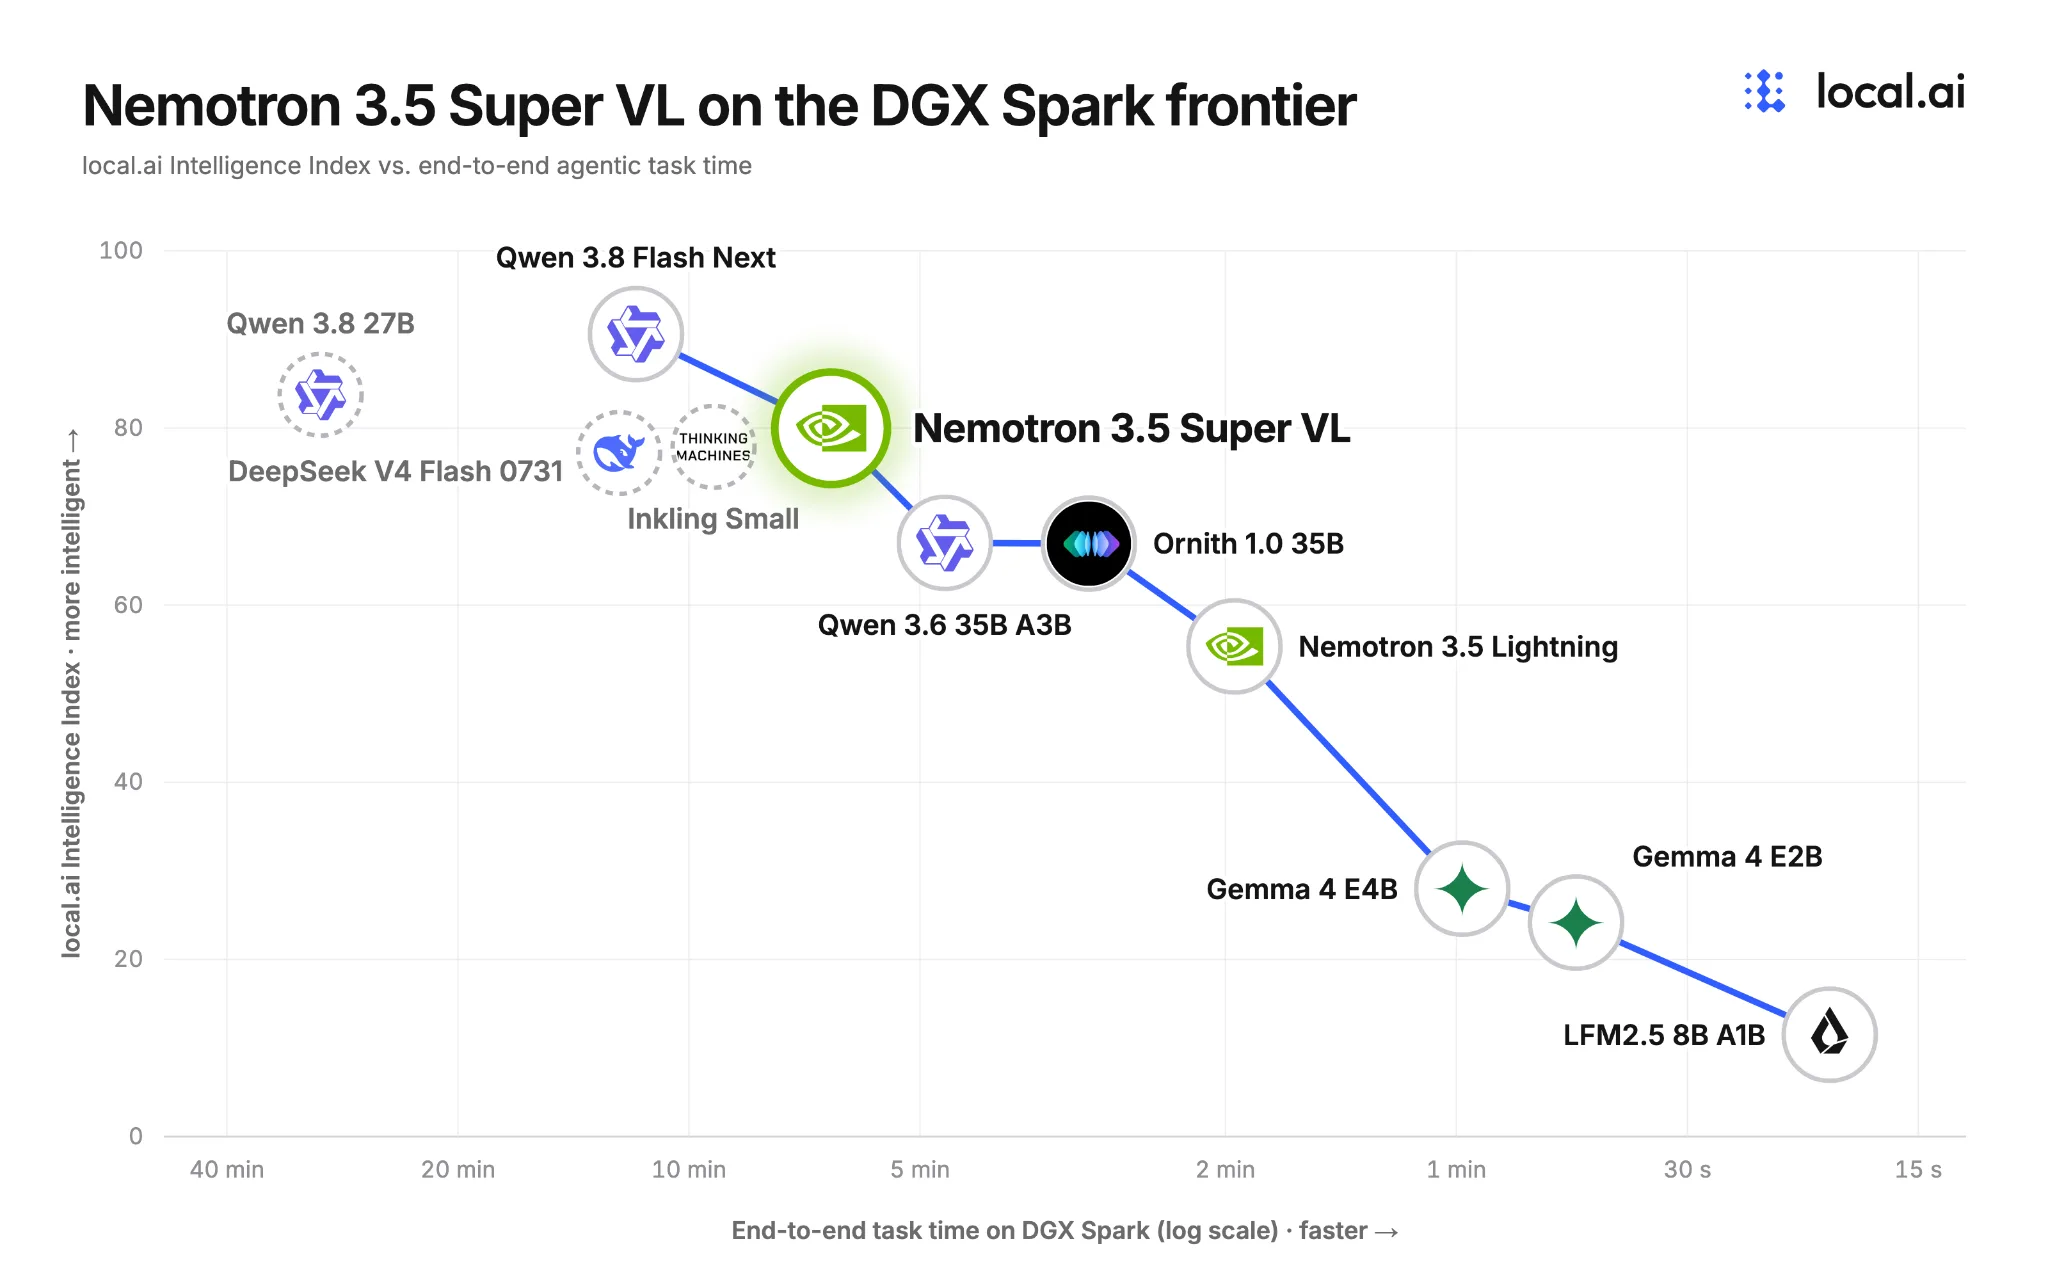 Hình 4. Nemotron 3.5 Super VL cân bằng độ chính xác và tốc độ cho các tác vụ agent trên DGX Spark
Nemotron 3.5 Super VL bên trong
Mô hình được xây dựng trên nền tảng vững chắc và sử dụng kiến trúc lai, giải mã suy đoán, tái sử dụng ngữ cảnh và độ chính xác hỗn hợp để giảm khối lượng suy luận qua các lần gọi tác nhân lặp lại.
Xây dựng mô hình cơ sở vững mạnh
Nemotron 3.5 Super VL được chưng cất từ Nemotron 3 Ultra. Khả năng lập trình của Ultra, kết hợp với tổn thất SkewReverse được sử dụng trong quá trình chưng cất, đã giúp cải thiện độ chính xác của mã.
Trong quá trình đào tạo hậu, chưng cất chính sách đa giáo viên (MOPD) kết hợp sự hướng dẫn từ các giáo viên chuyên biệt trên văn bản và thị giác. Mô hình tạo ra các phản hồi, và các giáo viên chấm điểm chúng cho suy luận và theo dõi video, sử dụng công cụ thị giác và sự phù hợp.
Việc huấn luyện bổ sung trên các ví dụ về hành động của tác tử (agent), kho mã nguồn và các tác vụ kỹ thuật phần mềm đã cải thiện hiệu suất của mô hình trên các tác vụ tác tử. Nemotron 3.5 Super VL vượt trội hơn Nemotron 3 Super trên SWE-bench và Terminal-Bench trong nhiều cấu hình đánh giá khác nhau.
Việc tiền huấn luyện tiếp tục với dữ liệu tự nhiên và tổng hợp chất lượng cao đã cải thiện khả năng xử lý ngôn ngữ Ấn Độ (Indic) và góp phần nâng cao điểm tổng thể sau khi huấn luyện hậu xử lý. Giai đoạn này đã bổ sung 10 tỷ token Ấn Độ, được lấy từ tập con 12 ngôn ngữ của Nemotron-pretraining-Indic-v1 và văn bản Ấn Độ tự nhiên.
NVIDIA đang phát hành bộ dữ liệu đầy đủ, bao gồm khoảng 2,8T token trong 22 ngôn ngữ Ấn Độ và được phát triển cùng với IIT Madras và phòng thí nghiệm AI4Bharat. Các kết quả sau đây dựa trên Nemotron 3.5 Super VL đã được huấn luyện lại.
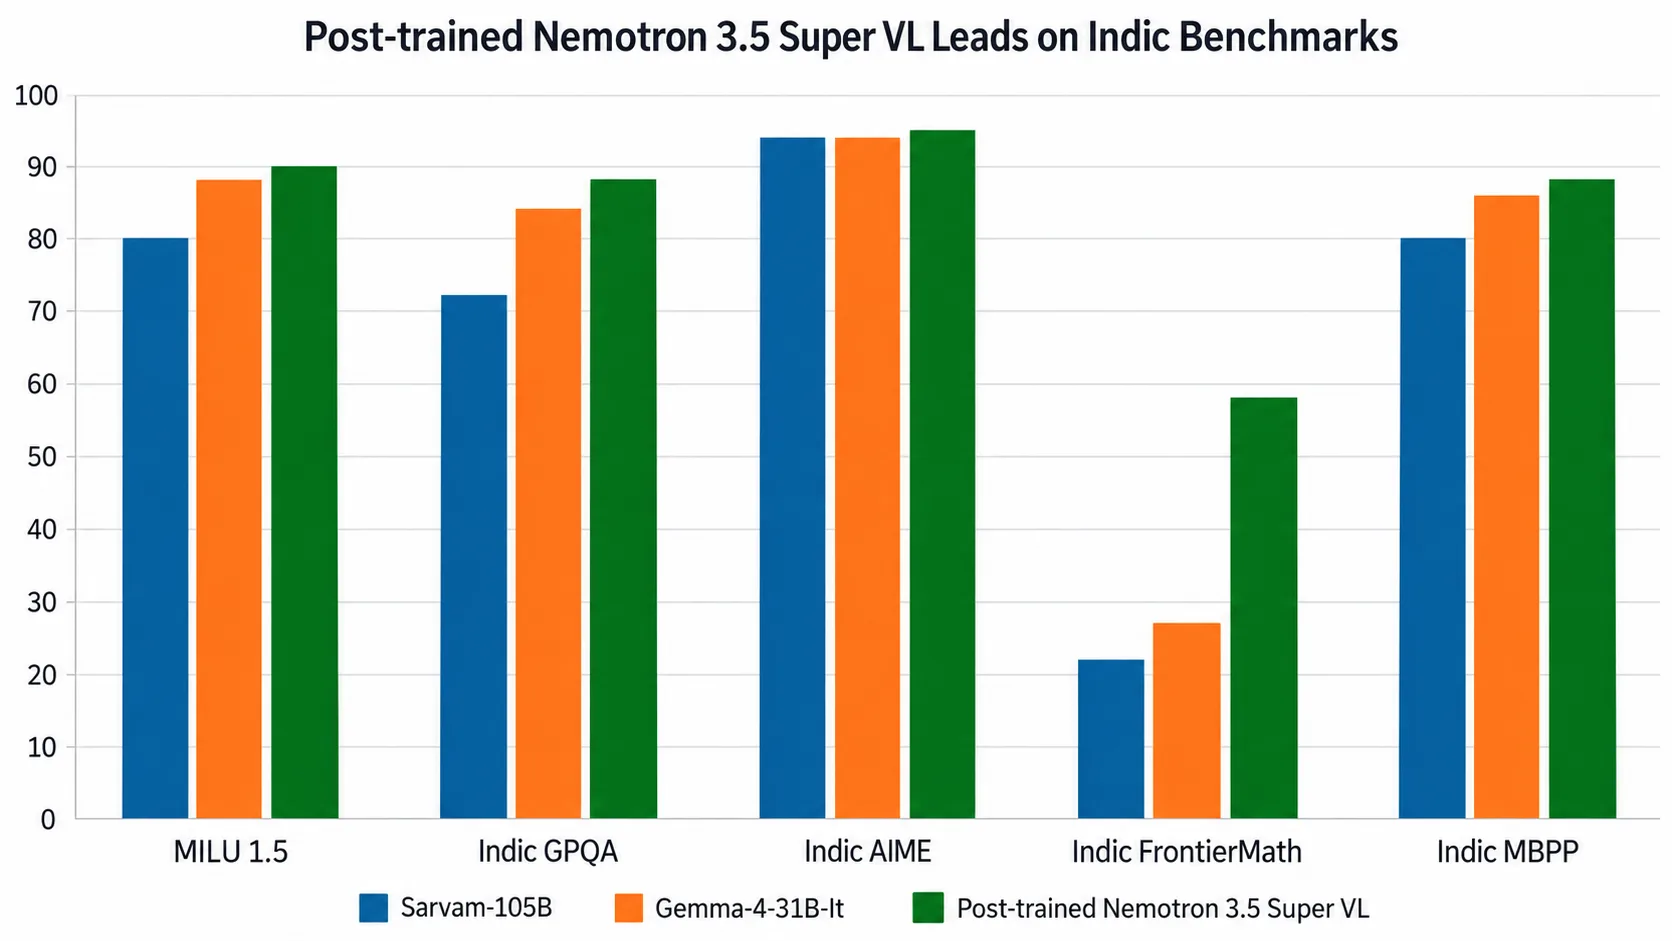 Hình 5. Nemotron 3.5 Super VL đạt độ chính xác hàng đầu trên các bộ đánh giá Indic, nhờ vào dữ liệu Indic chuyên biệt
Các nhà phát triển có thể sử dụng NeMo để xây dựng trên nền tảng này và tùy chỉnh Nemotron 3.5 Super VL cho ứng dụng của họ, điều chỉnh khả năng suy luận và tác nhân (agentic) của nó phù hợp với dữ liệu, công cụ và quy trình làm việc của họ.
LiLiCorr: Một kỹ thuật giải mã suy đoán mã nguồn mở
LiLiCorr cải thiện giải mã suy đoán song song bằng cách đánh giá đồng thời các ứng viên token trên toàn bộ bản thảo, nắm bắt các phụ thuộc mà dự đoán token độc lập bỏ sót. Một mạng nhẹ tính toán điểm tương thích trong một lần duy nhất để tạo ra các bản thảo nhất quán hơn, chỉ để lại bước lựa chọn cuối cùng tuần tự với chi phí thấp.
Trên DGX Spark, LiLiCorr là bộ tạo bản thảo được khuyến nghị cho suy luận độ trễ thấp với Nemotron 3.5 Super VL. Nó mang lại tốc độ tạo token nhanh hơn tới 2,3 lần so với giải mã không có suy đoán.
NVFP4 và độ chính xác hỗn hợp
Mô hình sử dụng NVIDIA Model Optimizer để lượng tử hóa sau khi huấn luyện và chưng cất nhận thức lượng tử hóa (QAD). Công thức NVFP4 sử dụng trọng số và kích hoạt 4-bit trên kiến trúc NVIDIA Blackwell. Cùng một checkpoint chạy trên các nền tảng không phải Blackwell với trọng số 4-bit và kích hoạt 16-bit. Độ chính xác được chọn riêng cho các thành phần nhạy cảm.
NVFP4 giúp mô hình nhỏ gọn hơn, và QAD giúp nó giữ được độ chính xác ở độ chính xác thấp hơn. Trong quá trình QAD, mô hình lượng tử hóa học cách khớp với đầu ra của mô hình BF16 gốc, điều này thu hẹp khoảng cách độ chính xác do lượng tử hóa gây ra. QAD cũng hỗ trợ lưu trữ bộ đệm khóa-giá trị (KV) ở NVFP4 thay vì FP8 trong khi vẫn đáp ứng các mục tiêu về độ chính xác. Vì QAD diễn ra trong quá trình huấn luyện, nó không thêm bất kỳ chi phí suy luận nào.
Dự đoán đa token
Dự đoán đa token (MTP) mang lại cho Nemotron 3.5 Super VL một bộ phác thảo nội bộ, đề xuất một số token để mô hình chính xác nhận trong một lần truyền trực tiếp. Việc chấp nhận nhiều token cùng lúc làm giảm số lượng bước xác nhận tiêu tốn nhiều tài nguyên tính toán cần thiết để tạo ra phản hồi.
Một giai đoạn đào tạo tăng cường MTP chuyên biệt đã đồng bộ hóa thêm bộ phác thảo với mô hình cuối cùng.
Tái sử dụng ngữ cảnh giữa các lượt của tác tử
Các tác tử liên tục truyền lại các hướng dẫn hệ thống, định nghĩa công cụ và lịch sử hội thoại cho mô hình. Bộ đệm tiền tố (prefix caching) tái sử dụng kết quả tính toán từ các đầu vào chung đó.
Các tối ưu hóa phục vụ của mô hình giữ nguyên cả bộ đệm chú ý (attention caches) và trạng thái đệ quy Mamba. Các điểm kiểm tra Mamba bổ sung làm giảm lượng phát lại (replay) cần thiết để khôi phục đầu vào cho giải mã suy đoán, trong khi việc kiểm tra nội bộ giúp tránh các lần chạy mô hình thừa trong quá trình xử lý prompt.
Đơn giản hóa triển khai sản xuất với NVIDIA NIM và NVIDIA Dynamo
NVIDIA NIM đóng gói các mô hình với các bộ máy suy luận được tối ưu hóa, các cấu hình đã được xác thực và các API tiêu chuẩn cho triển khai trên đám mây và trung tâm dữ liệu. NIM nhận được các bản cập nhật liên tục về bảo mật, tính năng và hiệu suất. Hỗ trợ doanh nghiệp có sẵn thông qua NVIDIA AI Enterprise. Bắt đầu với NIM.
NVIDIA Dynamo hỗ trợ các tối ưu hóa suy luận phân tán để tăng thông lượng và giảm độ trễ, bao gồm định tuyến nhận thức bộ đệm KV, quản lý bộ đệm KV và cung cấp dịch vụ tách rời.
Trên 16 GPU NVIDIA B200 với tốc độ 50 token mỗi giây cho mỗi người dùng, định tuyến nhận thức KV với tính liên kết phiên và chuyển bộ đệm KV ra ngoài phục vụ nhiều người dùng hơn tới 8 lần trong khi giảm độ trễ token đầu tiên xuống 85%. Bắt đầu với các công thức triển khai Dynamo.
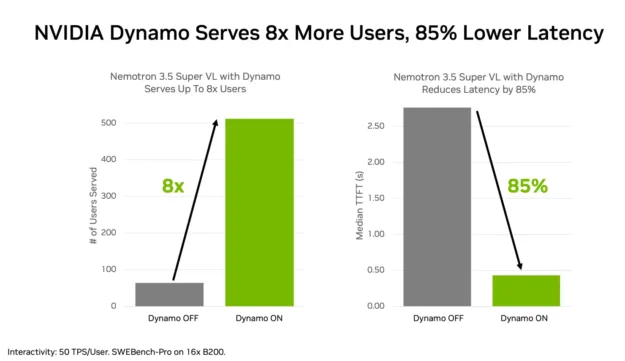 Hình 6. NVIDIA Dynamo phục vụ nhiều người dùng hơn 8 lần và giảm độ trễ token đầu tiên xuống 85% ở cùng tốc độ token mỗi người dùng
Bắt đầu với Nemotron 3.5 Super VL
Xây dựng các tác nhân chuyên dụng với khả năng suy luận đa phương thức và sử dụng công cụ. Tùy chỉnh mô hình cho các quy trình làm việc chuyên biệt, sau đó triển khai trong môi trường được hỗ trợ.
Phiên bản phát hành bao gồm các checkpoint cơ bản, đã huấn luyện sau và đã lượng tử hóa NVFP4, kèm theo công thức huấn luyện, dữ liệu và môi trường học tăng cường.
Xem báo cáo kỹ thuật của Nemotron 3.5 để biết chi tiết về mô hình và Hugging Face hoặc ModelScope để biết hướng dẫn triển khai. Để truy cập mô hình được lưu trữ, xem OpenRouter.
Hệ sinh thái đối tác Các đối tác hỗ trợ tùy chỉnh và triển khai Nemotron 3.5 Super VL cho các quy trình làm việc theo lĩnh vực:
-
Post-training: AfterQuery, AgileRL, AI21, Alice, Applied Compute, Baseten, Bespoke Labs, Databricks, distil labs, Fastino Labs, Fireworks AI, Handshake, Mercor, Mindbeam, ms-swift, Multiverse Computing, Prime Intellect, Reasonable, River AI, Scale AI, Thinking Machines Lab (Tinker), TNG, Trajectory.
-
Inference software: Actual Computer, Canonical, Exo, LM Studio, Ollama, SGLang, Unsloth, vLLM.
-
Harnesses & Agent frameworks: Aible, Cline, Hermes Agent, Kilo Code, LangChain, LM Studio Bionic, OpenClaw, OpenCode, OpenHands, Pi.
-
Hosted inference providers: Baseten, Bitdeer AI, BLACKBOX.AI, CoreWeave, Crusoe, DeepInfra, DigitalOcean, fal.ai, Fireworks AI, FriendliAI, GMI Cloud, Lambda, Modal, Nebius, Nscale, Together AI.
-
Cloud platforms: Amazon SageMaker JumpStart, Google Cloud Gemini Enterprise Agent Platform, MSFT Foundry, OCI Enterprise AI.
-
Hardware, Infra & GSI: Dell, HPE Services, Red Hat, HCLTech, Infosys, Tata Consultancy Services.
-
AI natives: APMIC, Cognition, Daily, Domyn, Dream, Eon, Factory AI, H Company, Harvey, Inflection AI, Navan, NextLM, NYB.AI, Orca Security, Perplexity, Ramp, Terray, Two Delta, Versos.
Bài viết liên quan
- Những cỗ máy tạo ra những cỗ máy
- Mở rộng quy trình lập trình Agentic với Muse Spark Open của Meta trên NVIDIA GB300 NVL72
- Đánh giá hiệu năng suy luận LLM quy mô lớn với AIPerf
- Một nền tảng, hai cấu hình: Giải mã sự khác biệt giữa NVIDIA DGX Spark 64GB và 128GB
- Thêm các trình điều khiển runtime cho các tác nhân AI với NVIDIA OpenShell