Meta ra mắt Muse Spark Open, một mô hình mixture-of-experts (MoE) được tối ưu hóa cho lập trình với 816B tham số, 42B tham số hoạt động và cửa sổ ngữ cảnh 1M token. Được huấn luyện trên NVIDIA GB300 NVL72 Blackwell Ultra dành riêng cho các quy trình lập trình agentic, mô hình này mang lại độ chính xác cao hơn trong lần thử đầu tiên, khả năng gọi công cụ đáng tin cậy và sự hiểu biết sâu sắc về mã nguồn xuyên suốt các kho lưu trữ. Cửa sổ ngữ cảnh 1M token có thể chứa toàn bộ một dự án, bao gồm các phụ thuộc phức tạp, mã nguồn cũ và hàng nghìn tệp tin mà không cần chia nhỏ tác vụ thành các phần.
Với tư cách là một mô hình suy luận, Muse Spark Open bổ sung khả năng nhận thức âm thanh và video bên cạnh việc hiểu hình ảnh và tài liệu, hoạt động một cách bản địa và đáng tin cậy trên những gì nó nhìn thấy, nghe được và đọc được. Các checkpoint NVFP4 do Meta tạo ra và được tối ưu hóa cho NVIDIA Blackwell Ultra giúp thu nhỏ dung lượng bộ nhớ của tất cả 816B tham số với khả năng tăng tốc Tensor Core FP4 bản địa. Ít byte hơn được di chuyển cho mỗi token để tăng số token mỗi giây cho mỗi người dùng, và bộ nhớ được giải phóng hỗ trợ bộ đệm KV lớn hơn cho các phiên ngữ cảnh dài đồng thời, mang lại thông lượng cao hơn và chi phí thấp hơn cho mỗi token.
Được thiết kế riêng cho lập trình agentic và hiểu đa phương thức trên văn bản, hình ảnh, video và âm thanh
Các mô hình lập trình chung được tối ưu hóa cho các hoàn thành một lần như tạo một hàm, viết một bài kiểm tra đơn vị hoặc đề xuất một sửa đổi inline. Chúng xuất sắc trong các nhiệm vụ rời rạc, có phạm vi rõ ràng, nơi ngữ cảnh nhỏ và câu trả lời ngay lập tức. Lập trình agentic đòi hỏi một điều gì đó hoàn toàn khác. Lập kế hoạch cho một refactor đa tệp, điều hướng hàng nghìn tệp, phục hồi từ các bài kiểm tra thất bại và phối hợp các subagent trong các khoảng thời gian dài đòi hỏi một mô hình được xây dựng cho công việc nhiều bước, kéo dài.
Muse Spark Open được xây dựng dành riêng cho các tác vụ này, mang lại độ chính xác cao hơn ngay từ lần thử đầu tiên, khả năng gọi công cụ đáng tin cậy và hiểu sâu về mã nguồn xuyên suốt các kho lưu trữ. Nó lập kế hoạch, hành động, quan sát và tự sửa lỗi. Nó hỗ trợ thực hiện tác vụ nhiều bước với việc sử dụng công cụ, đánh giá đầu ra và tinh chỉnh lặp lại. Mô hình sử dụng điều kiện mục tiêu để duy trì hướng đi và nén ngữ cảnh để giữ lại kiến thức cần thiết nhằm duy trì tiến độ trong các phiên chạy dài. Với cửa sổ ngữ cảnh 1 triệu token, nó nắm giữ toàn bộ dự án, bao gồm các phụ thuộc phức tạp, mã nguồn cũ và hàng nghìn tệp mà không cần chia nhỏ tác vụ thành từng phần.
Ngoài việc viết mã, nó còn tìm kiếm trên web (bao gồm duyệt web đa phương tiện), tạo và điều phối các tác nhân con cho các tác vụ có thể phân rã, và tận dụng khả năng sử dụng máy tính được thống nhất trên desktop, di động và trình duyệt. Nó tạo ra phần bình luận riêng trước mỗi hành động, giúp các nhà phát triển biết tác nhân đang làm gì và tại sao.
Bộ mã hóa nhận thức 1,8B của mô hình xử lý bản địa văn bản, hình ảnh, khung video và âm thanh xen kẽ mà không cần các đường ống riêng biệt cho từng phương thức. Điều này có nghĩa là mô hình suy luận về những gì nó nhìn thấy, nghe được và đọc được trong một lần xử lý thống nhất duy nhất. Điều này phù hợp với các quy trình làm việc của nhà phát triển bao gồm ảnh chụp màn hình, sơ đồ, nhật ký lỗi và video hướng dẫn trong cùng một phiên tác tử. Định tuyến MoE thưa chỉ kích hoạt 42B trong tổng số 816B tham số cho mỗi token, mang lại khả năng tác tử tiên phong với chi phí phục vụ chỉ bằng một phần nhỏ so với các mô hình đặc tại quy mô tương đương.
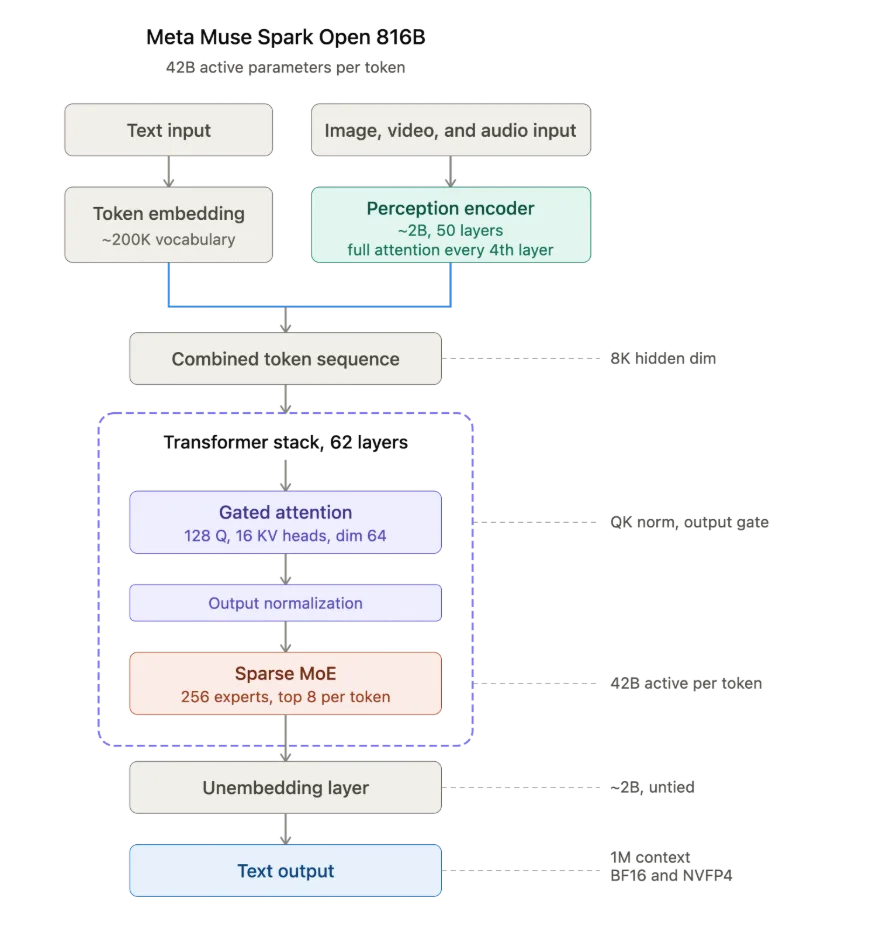 Hình 1. Kiến trúc MoE thưa của Muse Spark Open kích hoạt 42B trong số 816B tham số cho mỗi token thông qua định tuyến top 8 trên 256 chuyên gia
Muse Spark Open tối ưu hiệu năng trên GB300 NVL72
NVIDIA GB300 NVL72 có kiến trúc theo quy mô rack, tích hợp 72 GPU NVIDIA Blackwell Ultra vào một nền tảng duy nhất. Vùng NVIDIA NVLink lớn với 72 GPU cho phép truyền thông hiệu quả ở tốc độ 130 TB/s, loại bỏ các điểm nghẽn xuất hiện khi lưu lượng chuyên gia phải vượt qua các mạng thương mại thông thường. Đối với một mô hình MoE thưa như Muse Spark Open, nơi mỗi token được định tuyến đến tám trong số 256 chuyên gia, băng thông đó trực tiếp quyết định mức độ thông lượng lý thuyết mà một triển khai có thể đạt được.
Các tác vụ agentic biến các tương tác đơn lượt tĩnh thành các quy trình đa bước có khả năng suy luận, gọi công cụ, điều phối các subagent và mang ngữ cảnh ngày càng lớn từ lượt này sang lượt khác. Ngay khi cài đặt, Muse Spark Open chạy các tác vụ agentic trên NVIDIA GB300 NVL72 đạt lên đến 50K token mỗi giây cho mỗi GPU và lên đến 600 token mỗi giây cho mỗi người dùng, cho phép các nhà máy AI chạy các mô hình tham số lớn trong môi trường sản xuất với thông lượng cao và độ trễ thấp.
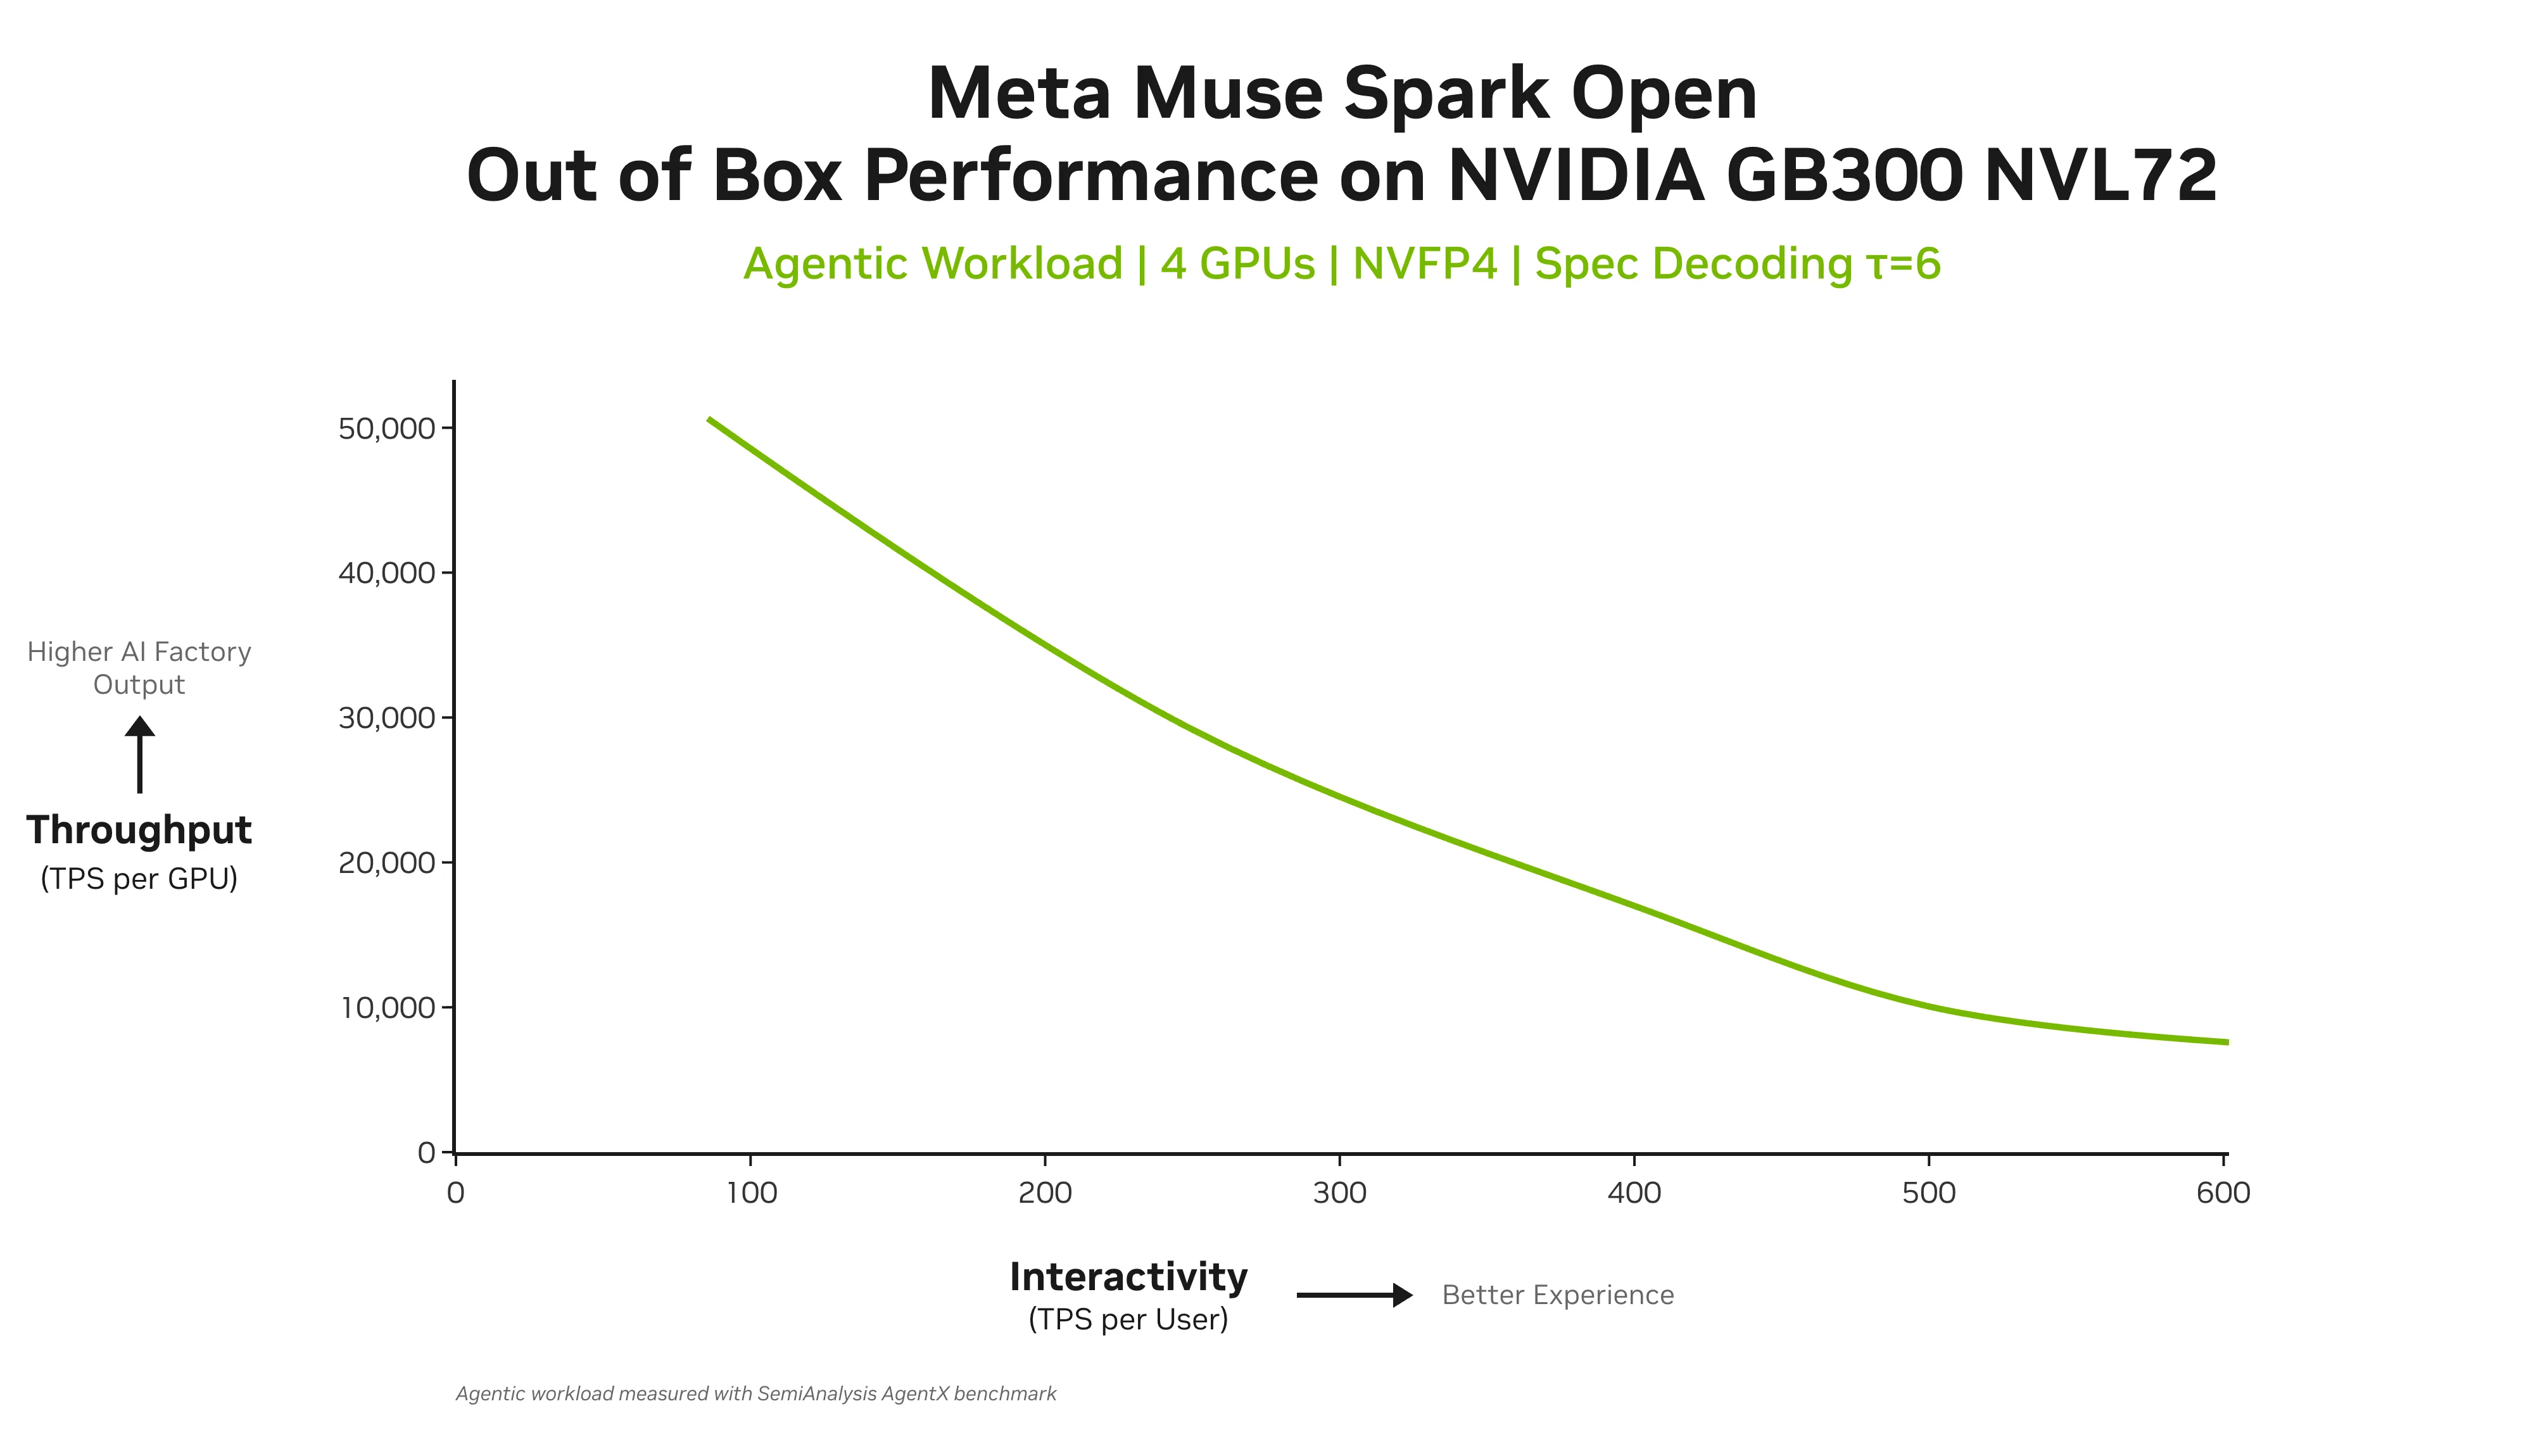 Hình 2. Chạy các tác vụ agentic, Muse Spark Open trên bốn GPU NVIDIA Blackwell với giải mã suy đoán đạt hơn 50K token mỗi giây cho mỗi GPU và hơn 600 token cho mỗi người dùng
Các tùy chọn triển khai linh hoạt cho Muse Spark Open
NVIDIA hỗ trợ nhiều bộ suy luận (inference stacks) để đáp ứng nhu cầu đa dạng của nhà phát triển. SGLang, vLLM và TensorRT LLM cho phép nhà phát triển kiểm soát trực tiếp cấu hình phục vụ, song song hóa và gộp lô (batching) trên nền tảng tính toán tăng tốc của NVIDIA. TensorRT LLM bổ sung các bộ máy biên dịch (compiled engines) được tinh chỉnh cho GPU NVIDIA. NVIDIA Dynamo công bố các công thức triển khai (deployment recipes) cho cả ba, và tách riêng quá trình prefill khỏi decode trên các nhóm GPU chuyên dụng, nhờ đó xử lý prompt phụ thuộc vào sức mạnh tính toán sẽ không làm chậm quá trình tạo token. Cơ chế định tuyến nhận thức bộ đệm KV (KV cache-aware routing) của nó gửi mỗi yêu cầu đến worker đã giữ sẵn tiền tố (prefix) liên quan, tránh việc tính toán trước khi ngữ cảnh tích lũy qua các phiên agentic dài.
Huấn luyện sau (post-train) Muse Spark Open với NeMo AutoModel và Megatron Bridge
Các nhà phát triển có thể huấn luyện sau (post-train) Muse Spark Open trên các bộ dữ liệu đặc thù theo lĩnh vực bằng cách sử dụng NVIDIA NeMo AutoModel, một thư viện huấn luyện PyTorch native với hỗ trợ checkpoint Hugging Face native và không yêu cầu chuyển đổi mô hình. Nó cho phép thực hiện đầy đủ SFT và tinh chỉnh LoRA ngay lập tức, được tối ưu hóa cho việc thử nghiệm nhanh chóng trên nhiều trường hợp đặc thù theo ngành khác nhau.
Các nhà phát triển cũng có thể tận dụng NVIDIA Megatron Bridge để chuyển đổi các checkpoint Hugging Face sang định dạng Megatron khi họ sẵn sàng cho việc huấn luyện quy mô sản xuất lớn nhằm tận dụng các tối ưu hóa.
Bắt đầu với Muse Spark Open được tăng tốc bằng GPU
Để bắt đầu, tải xuống trọng số Muse Spark Open NVFP4 từ Hugging Face. Đối với triển khai trong môi trường sản xuất, hãy thử NVIDIA NIM có thể tải xuống. NIM giảm quy trình thiết lập xuống chỉ một lệnh duy nhất, thay thế các chu kỳ đánh giá hiệu năng và tinh chỉnh bằng một container tự động chọn backend phục vụ và độ chính xác tốt nhất cho phần cứng được phát hiện.
Bài viết liên quan
- Những cỗ máy tạo ra những cỗ máy
- NVIDIA Nemotron 3.5 Super VL hỗ trợ các tác nhân chuyên biệt với khả năng suy luận đa phương thức
- Đánh giá hiệu năng suy luận LLM quy mô lớn với AIPerf
- Một nền tảng, hai cấu hình: Giải mã sự khác biệt giữa NVIDIA DGX Spark 64GB và 128GB
- Thêm các trình điều khiển runtime cho các tác nhân AI với NVIDIA OpenShell