Bạn đang triển khai một mô hình trên một hệ thống. Nó khởi động, các câu lệnh đầu vào nhận được phản hồi. Bây giờ là câu hỏi khó: Tốc độ này có nhanh không?
Bản năng của bạn có thể dẫn bạn đến việc gửi các lệnh curl, tự viết một kịch bản asyncio, hoặc dùng AI để tạo ra một công cụ tạo tải độc nhất khác. Tất cả các phương pháp này đều gặp phải cùng một vấn đề: giới hạn hiệu suất của tiến trình đơn, GIL của Python hạn chế tính đồng thời, hoặc các con số được đo lường so với một tham chiếu do chính bạn xây dựng. Dù theo cách nào, bạn cũng sẽ nhận được những kết quả mà bạn không thể hoàn toàn tin tưởng, đi kèm với các công cụ mà bạn sẽ phải viết lại ngay khi các yêu cầu thay đổi.
Bạn cần một máy khách tải (load client) có thể làm bão hòa một máy chủ thực tế mà không trở thành điểm nghẽn, tạo ra kết quả đầu ra mà bạn có thể hành động dựa trên đó, và chỉ mất năm phút để cấu hình, chứ không phải năm giờ. Đó chính là NVIDIA AIPerf.
Những điểm khác biệt của AIPerf
AIPerf là người kế nhiệm chính thức của GenAI-Perf và được viết lại hoàn toàn từ đầu. Các lựa chọn thiết kế phản ánh những bài học xương máu từ việc chạy các benchmark LLM ở quy mô lớn:
- Sự tách biệt hoàn toàn khỏi kiến trúc cũ. AIPerf không chạy trên Perf Analyzer như GenAI-Perf từng làm. Đây là một bước nhảy vọt về kiến trúc và là lý do khiến AIPerf có thể mở rộng quy mô như hiện nay. Nếu bạn đang chuyển đổi một quy trình làm việc hiện có, hướng dẫn di chuyển sẽ đề cập đến các điểm khác biệt chính.
- Client không nên là điểm nghẽn. Hầu hết các công cụ benchmark, bao gồm cả GenAI-Perf, sử dụng kiến trúc single-process, trở nên bị giới hạn bởi GIL (Global Interpreter Lock) khi xử lý độ đồng thời thực tế hoặc tỷ lệ yêu cầu. AIPerf là một hệ thống multiprocess: các worker process tạo tải, các dịch vụ record-processor riêng biệt xử lý kết quả, và mọi thứ được phối hợp thông qua ZMQ. Cấu trúc này cho phép benchmarking server chính xác hơn bằng cách ngăn AIPerf trở thành điểm nghẽn phía client.
- Độ rộng của workload phản ánh chính xác những gì bạn thực sự chạy. AIPerf hỗ trợ hơn 15 loại endpoint: chat, responses, xếp hạng NIM, tạo ảnh, và nhiều hơn nữa — cùng với các bộ dữ liệu công khai như ShareGPT và định dạng trace replay từ Mooncake, Baseten, WEKA (AgentX), và các nguồn khác. Dù bạn đang chạy một bài kiểm tra nhanh dạng smoke test tổng hợp hay phát lại lưu lượng sản xuất đã ghi nhận, bạn không cần một công cụ khác.
- Định dạng tải mà bạn thực sự kiểm soát. AIPerf hỗ trợ các mô hình đến theo dạng hằng số, Poisson và gamma với khả năng điều chỉnh độ bùng nổ, gia tăng dần cho độ đồng thời và tốc độ yêu cầu, cũng như các phân phối tổng hợp bao gồm tỷ lệ phạm vi vLLM/SGLang cho ISL/OSL thay đổi. Bạn kiểm soát định dạng của tải, không chỉ là khối lượng.
Bài kiểm tra đầu tiên của bạn: ISL/OSL tổng hợp trên vLLM
Trong hướng dẫn này, chúng tôi sẽ sử dụng Qwen3-0.6B được phục vụ thông qua vLLM. Việc lựa chọn mô hình là có chủ đích; nó đủ nhỏ để chạy trên một GPU duy nhất và đủ nhanh để lặp lại quá trình mà không cần chờ đợi. Mục đích không phải là đánh giá hiệu năng cụ thể của Qwen3-0.6B; mà là thiết lập vòng đo lường. Một khi đã có vòng đo đó, việc thay thế bằng một mô hình hoặc điểm cuối khác chỉ là thay đổi một tham số.
Bắt đầu máy chủ
Kéo và khởi động vLLM với trình phân tích lý luận được bật:
docker pull vllm/vllm-openai:latest
docker run --gpus all -p 8000:8000 -e HF_TOKEN vllm/vllm-openai:latest \
  --model Qwen/Qwen3-0.6B \
  --reasoning-parser qwen3 \
  --host 0.0.0.0 --port 8000
Cài đặt AIPerf
Chúng ta có thể sử dụng uv để cài đặt một bản sao trung tâm:
uv tool install aiperf
Hoặc cho một môi trường ảo:
uv venv venv
source venv/bin/activate
uv pip install aiperf
Một lưu ý về nền tảng: trên kiến trúc aarch64, gói phụ thuộc crick chỉ được phân phối dưới dạng mã nguồn và yêu cầu bộ công cụ biên dịch C (build-essential trên Debian/Ubuntu, Development Tools trên RHEL). Nếu quá trình cài đặt bị treo ở gói đó, đó là lý do.
Chạy bài kiểm tra
Với máy chủ đã khởi động và AIPerf đã được cài đặt, chúng ta có thể chạy hồ sơ đầu tiên của mình:
aiperf profile \
  --model Qwen/Qwen3-0.6B \
  --endpoint-type chat \
  --streaming \
  --url localhost:8000 \
  --synthetic-input-tokens-mean 128 \
  --synthetic-input-tokens-stddev 0 \
  --output-tokens-mean 128 \
  --output-tokens-stddev 0 \
  --extra-inputs min_tokens:128 \
  --extra-inputs ignore_eos:true
Một vài cờ ở đây đang thực hiện nhiều công việc hơn vẻ bề ngoài của chúng:
--synthetic-input-tokens-stddev 0 và --output-tokens-stddev 0 cố định tải công việc ở chính xác 128 token đầu vào và 128 token đầu ra cho mỗi yêu cầu. Điều này tái tạo một bài kiểm tra chuẩn tĩnh thường được sử dụng, trong đó độ dài yêu cầu và độ dài đầu ra được giữ không đổi.
--extra-inputs min_tokens:128 và --extra-inputs ignore_eos:true báo cho mô hình thực sự phát ra 128 token thay vì dừng sớm. Không có các tham số này, số lượng token đầu ra chỉ mang tính chất gợi ý. Mô hình sẽ dừng bất cứ khi nào nó hoàn tất một cách tự nhiên, điều này có thể ngắn hơn nhiều so với mục tiêu OSL của bạn. Kết quả thông lượng cuối cùng sẽ thấp hơn mức đáng lẽ phải có, và chúng không thể tái lập giữa các lần chạy.
--streaming là bắt buộc nếu bạn muốn đo TTFT và ITL. Không có streaming, máy chủ sẽ gom toàn bộ phản hồi vào một batch trước khi gửi, và không có sự kiện token đầu tiên hoặc token giải mã để đo lường.
Những gì bạn sẽ thấy
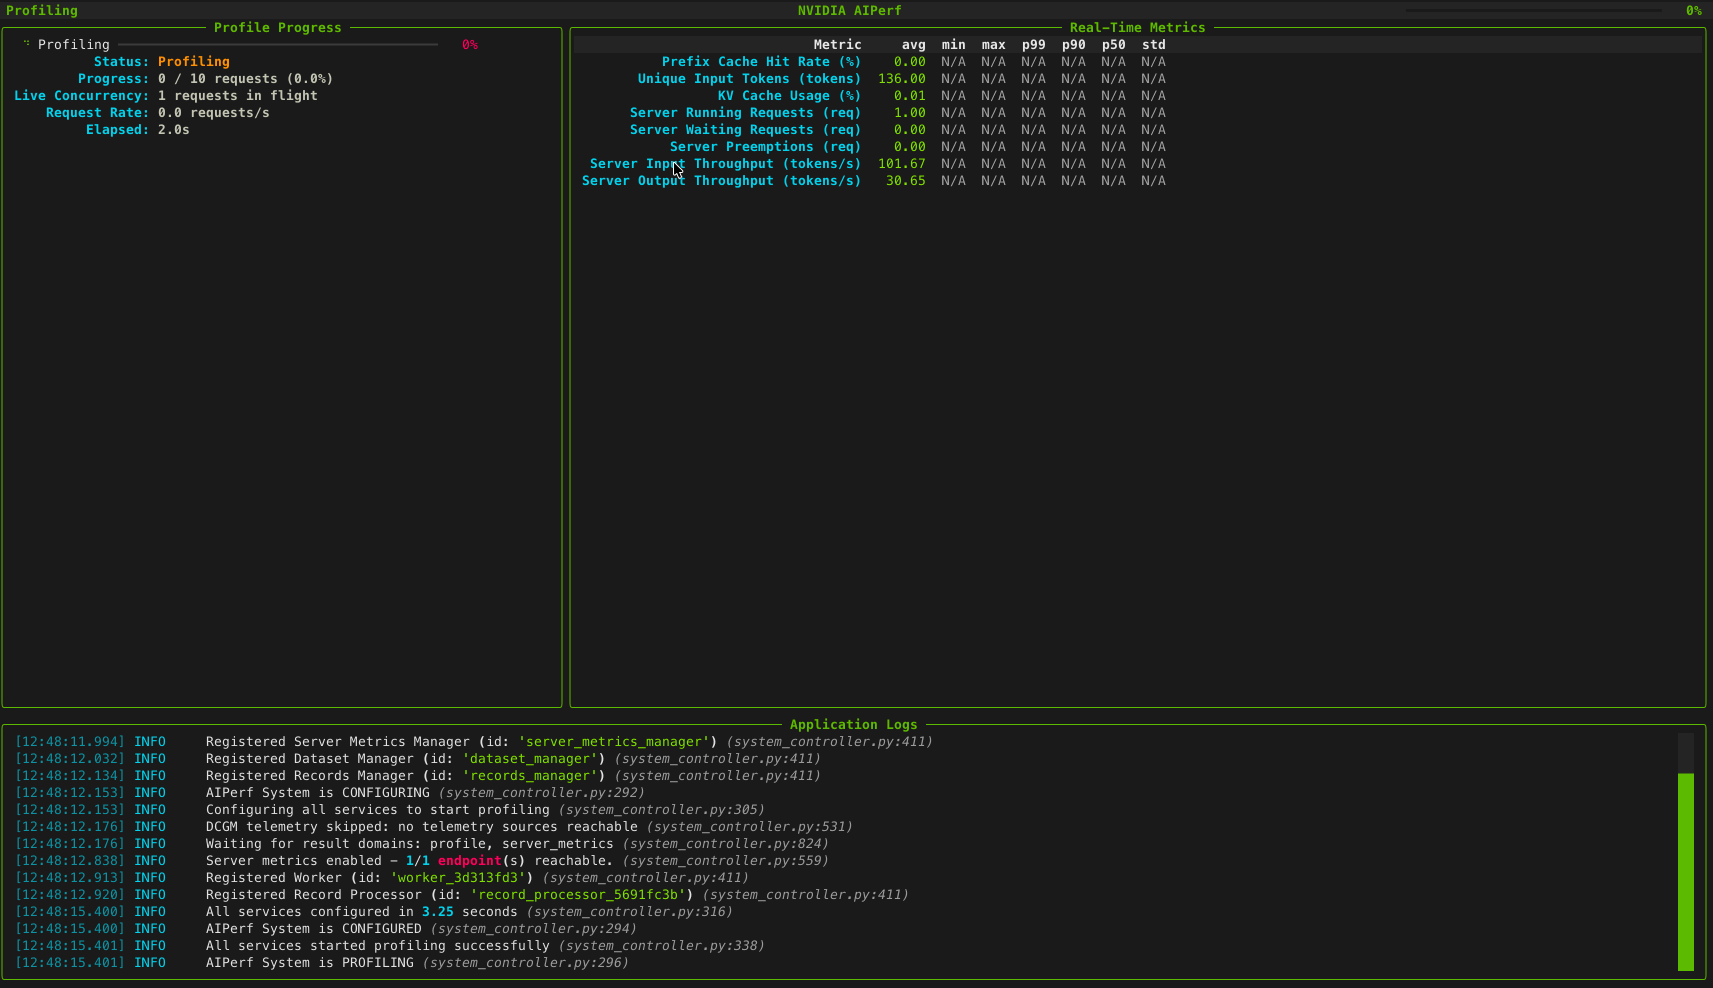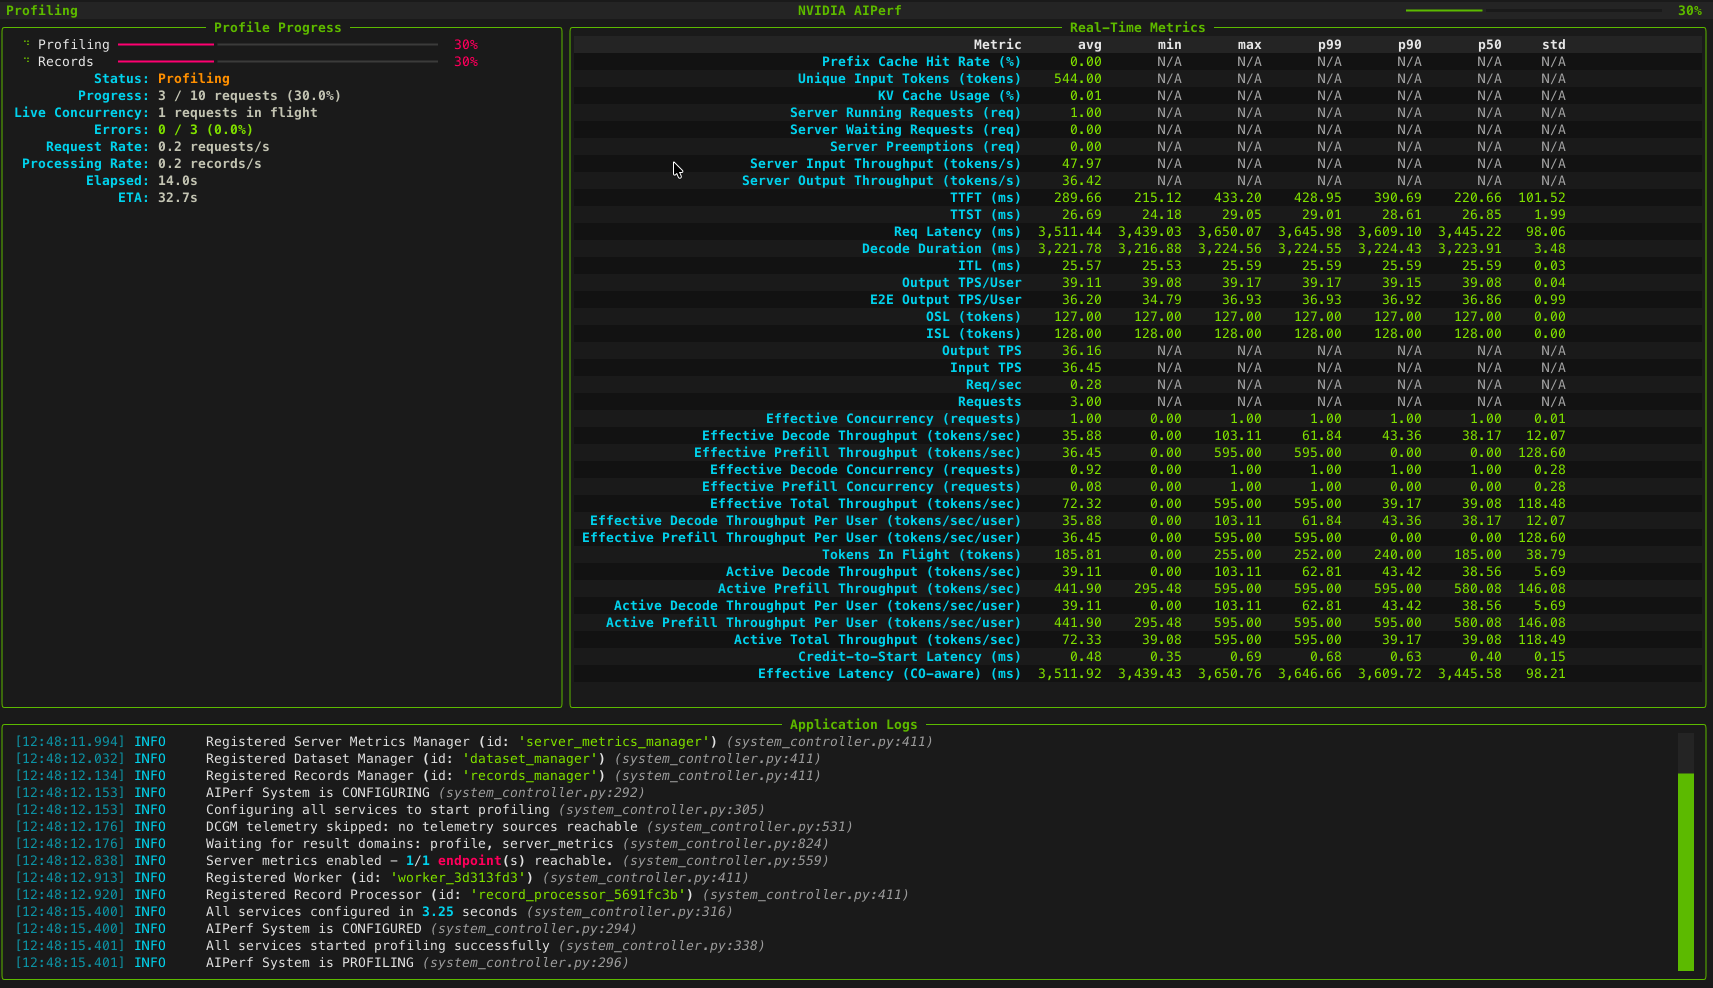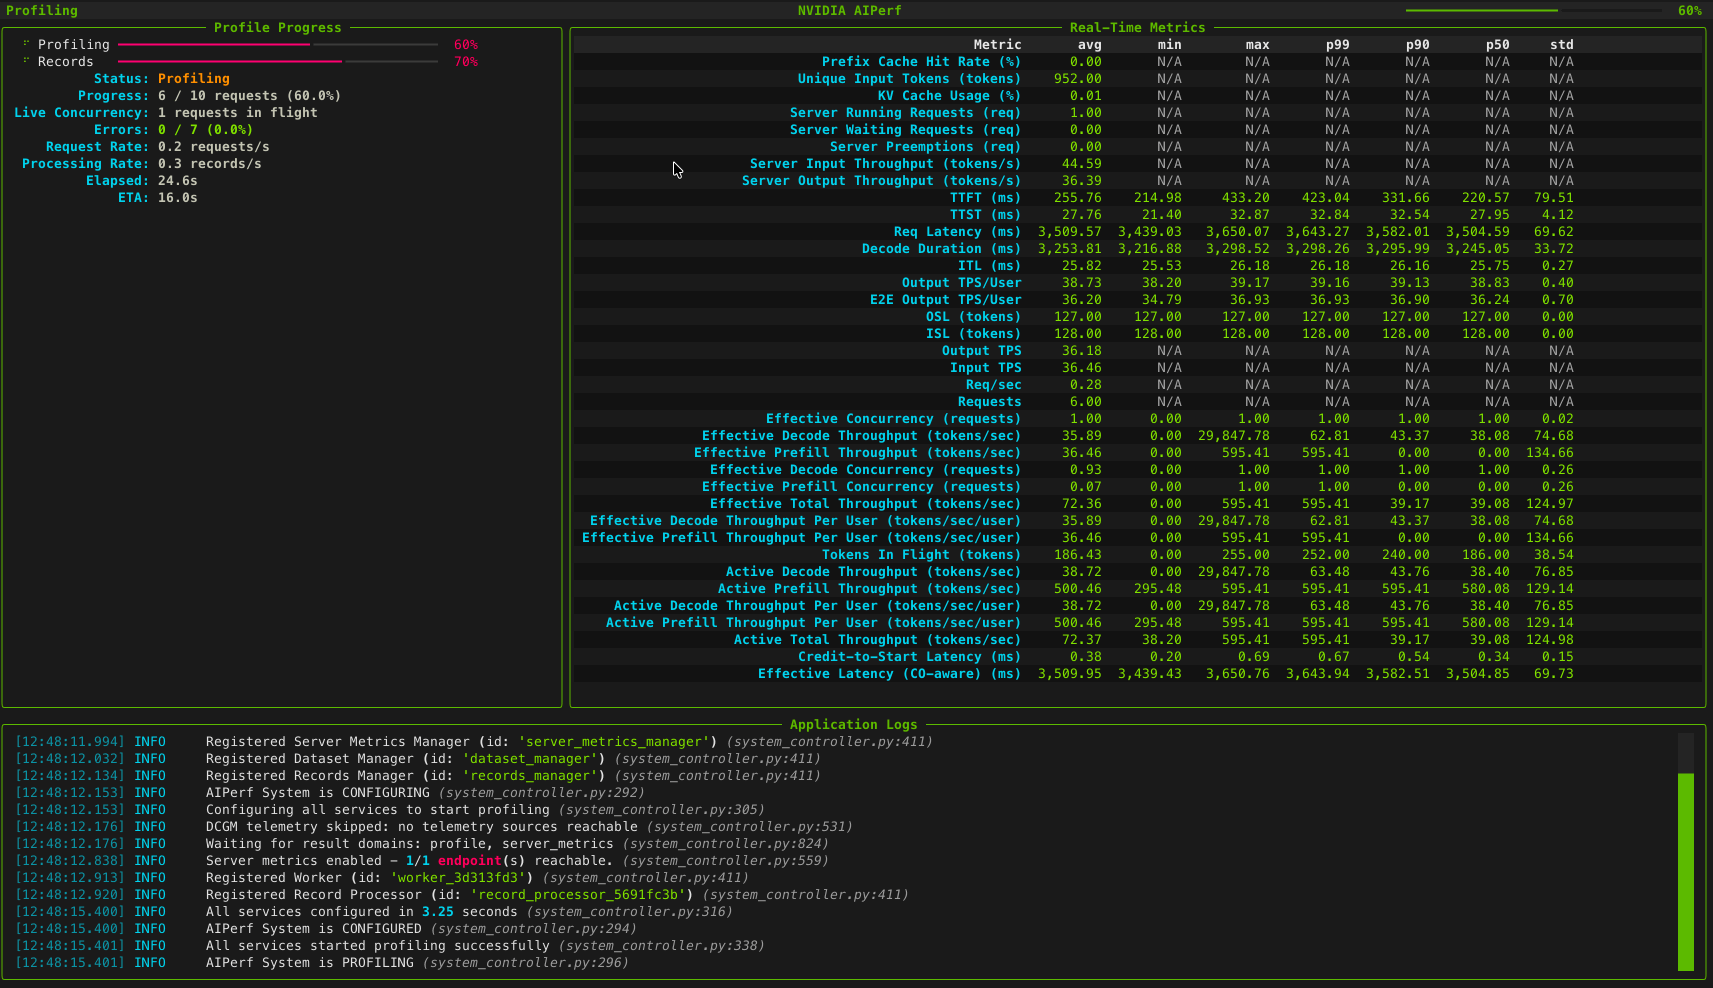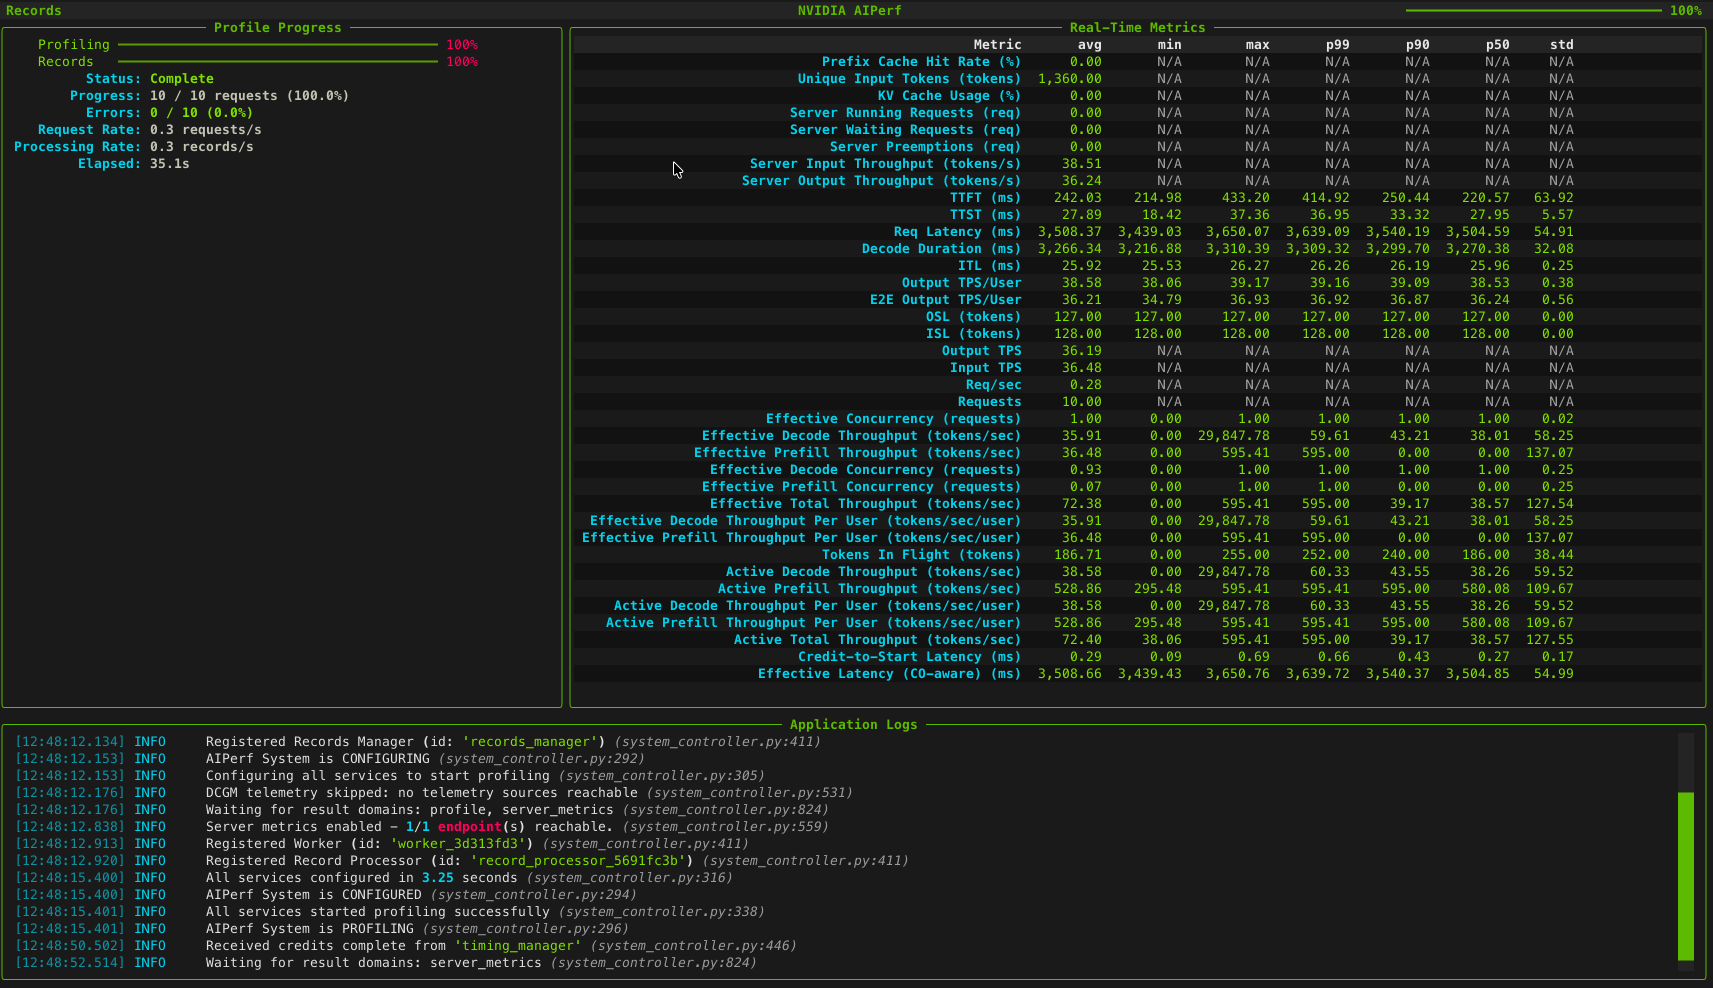 Hình 1. Một ví dụ về hoạt ảnh của giao diện người dùng bảng điều khiển trực tiếp AIPerf. Bảng điều khiển trực tiếp hiển thị tiến trình của phiên chạy, danh sách các chỉ số cùng với phân bố của chúng, cũng như nhật ký sự kiện đang chạy từ phía máy chủ backend của AIPerf
Chúng ta sẽ cùng xem cách đọc các con số này trong phần tiếp theo. Hiện tại, hãy chú ý đến hình dạng của đầu ra trong Hình 2, bên dưới: độ trễ được phân tích theo phần trăm, thông lượng tính bằng token trên giây, và các thống kê cấp yêu cầu đều được hiển thị trong một nơi. Đây là đường cơ sở để bạn so sánh mọi thứ khác với.
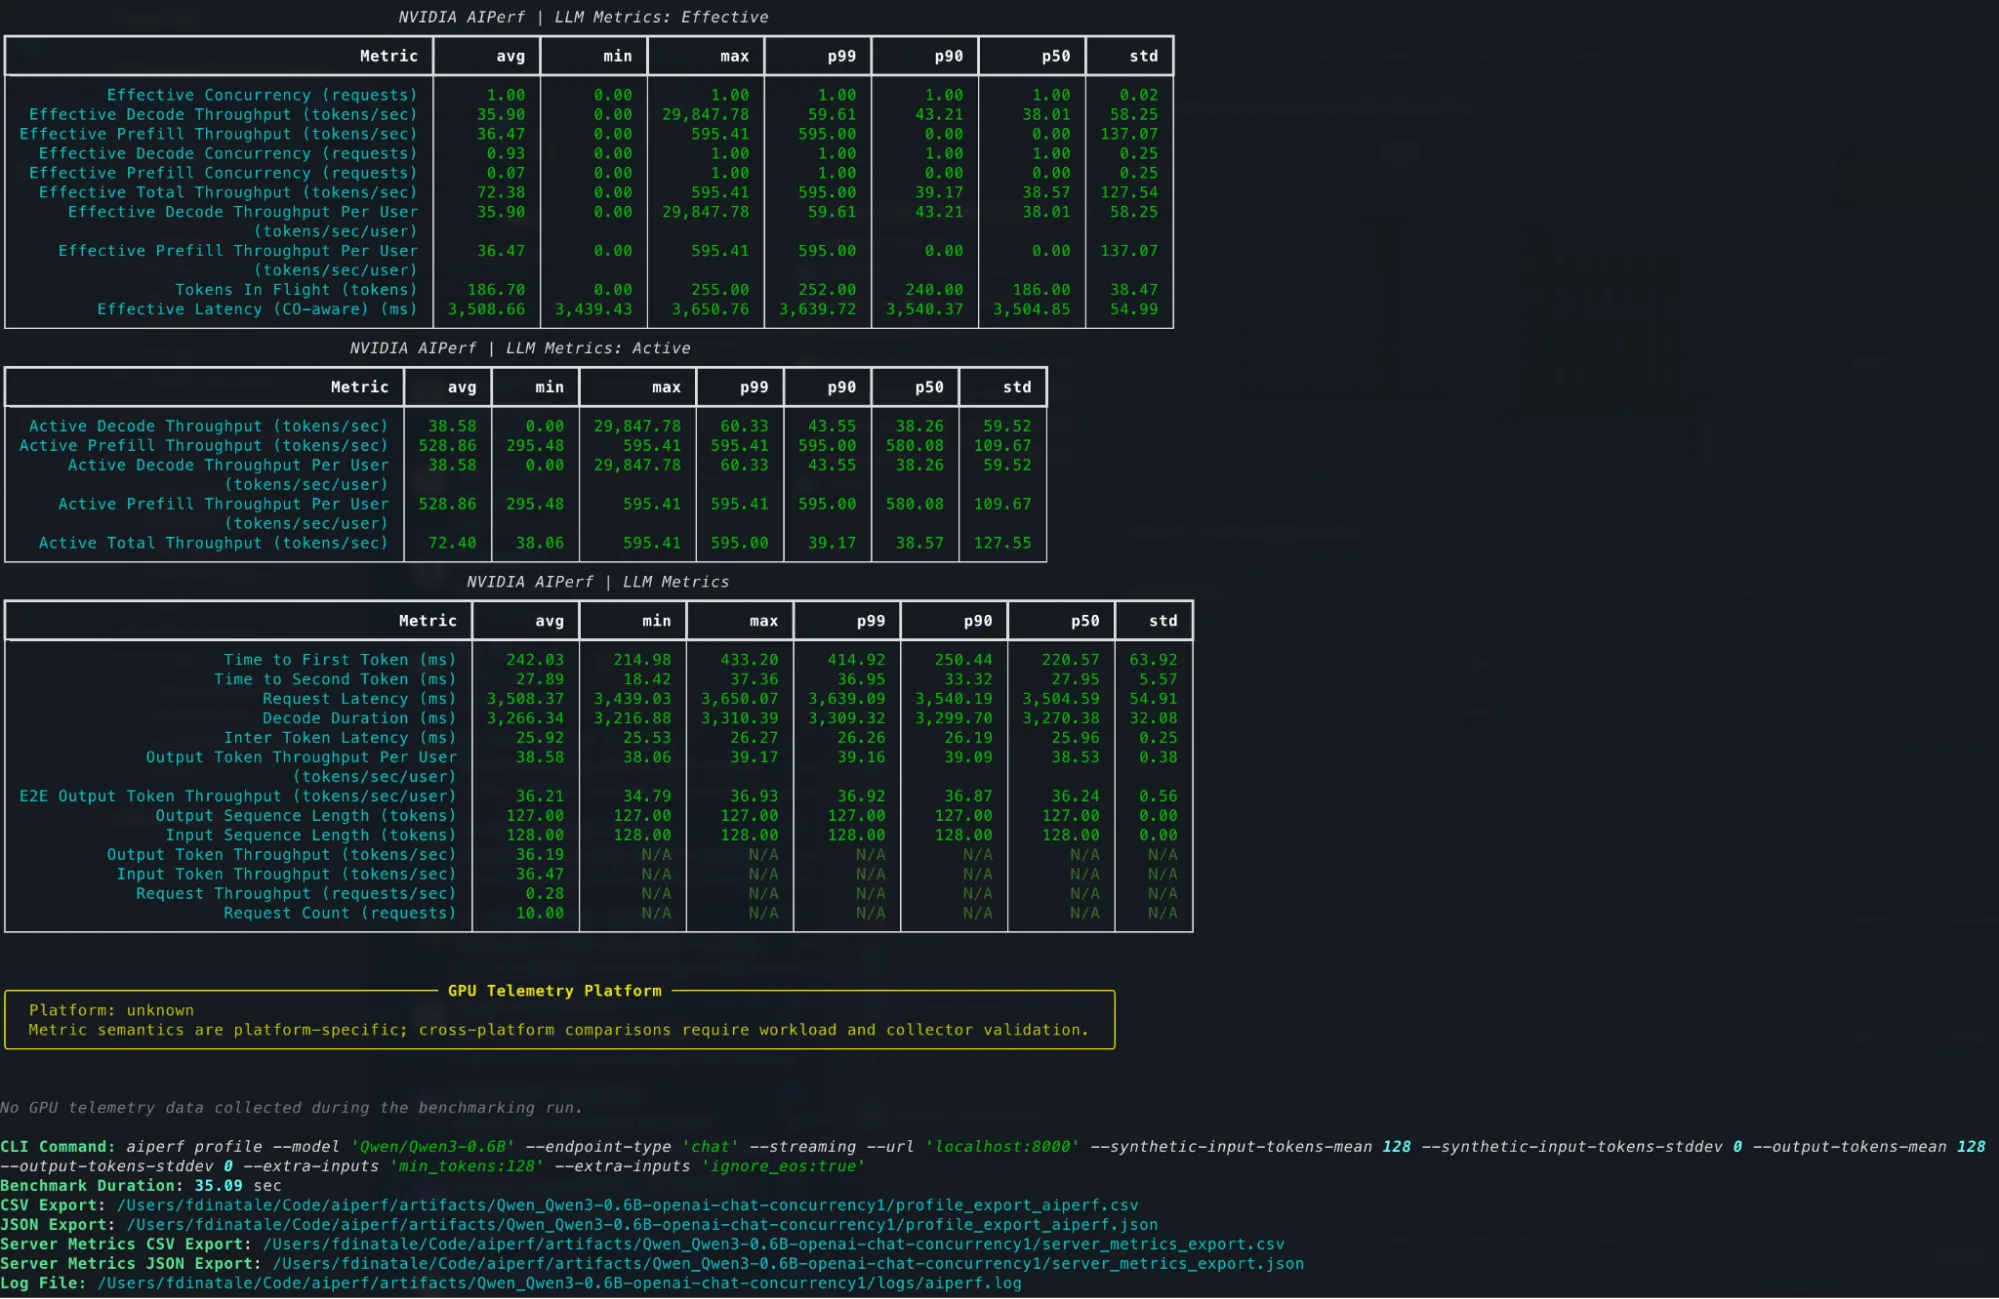 Hình 2. Một ví dụ về ảnh chụp màn hình của các chỉ số đầu ra ở cuối một lần chạy AIPerf, bao gồm tóm tắt các số liệu hiệu quả, hoạt động, thống kê tóm tắt cho nhiều loại chỉ số khác nhau cùng với phân tích phần trăm để xem xét nhanh, lệnh dòng lệnh sao chép và vị trí đầu ra
Đọc các con số: Những gì AIPerf hiển thị
Sau khi một lần chạy hoàn tất, AIPerf in ra bảng các chỉ số ra màn hình console và ghi toàn bộ kết quả vào định dạng CSV và JSON. Dưới đây là những gì bạn đang xem.
Bốn chỉ số cốt lõi:
- TTFT (Thời gian đến Token đầu tiên) — Khoảng thời gian từ khi yêu cầu được gửi đến khi nhận được token đầu tiên. Đây là tín hiệu độ trễ chính cho các trường hợp sử dụng tương tác.
- ITL (Độ trễ giữa các Token) — Thời gian giữa các token liên tiếp trong quá trình tạo. ITL cao cho thấy giai đoạn giải mã đang gặp khó khăn, ngay cả khi TTFT có vẻ ổn định.
- Độ trễ yêu cầu — Thời gian cuối cùng để tạo ra toàn bộ phản hồi. Kết hợp chi phí tiền xử lý (prefill) và giải mã (decode) thành một con số duy nhất.
- Thông lượng token đầu ra — Số token được tạo ra mỗi giây trên tất cả các yêu cầu đồng thời. Đây là tín hiệu thông lượng chính cho việc lập kế hoạch năng lực.
Để biết định nghĩa đầy đủ về các chỉ số này cũng như mọi chỉ số khác mà AIPerf báo cáo, hãy xem Tài liệu Tham chiếu Chỉ số.
Thu thập bức tranh toàn cảnh. Mỗi chỉ số trên được báo cáo theo phân tích phần trăm (p25, p50, p75, p90, p95, p99) cùng với các giá trị tối thiểu, tối đa, trung bình và độ lệch chuẩn. Những phân tích này quan trọng vì chúng có thể làm nổi bật các phân phối đuôi dài; một máy chủ có giá trị trung bình TTFT lành mạnh nhưng có giá trị p99 bất thường có vẻ ổn khi xét tổng thể nhưng lại thất bại trong môi trường sản xuất.
Vượt ra ngoài bốn yếu tố cốt lõi. Khi có sẵn DCGM hoặc pynvml, AIPerf cũng thu thập thông tin về mức tiêu thụ điện năng, mức sử dụng và dung lượng bộ nhớ của GPU vào cùng một kết quả chạy. Việc tương quan một đỉnh độ trễ với sự kiện áp lực bộ nhớ không yêu cầu một phiên phân tích riêng biệt, vì dữ liệu telemetry đã có sẵn.
Mở rộng thêm: Cấu hình một mẫu lưu lượng
Bây giờ khi chúng ta đã làm quen với một bài kiểm tra hiệu năng tĩnh, chúng ta có thể bắt đầu khám phá những khía cạnh năng động hơn. Phần trên đã cung cấp một mẫu lưu lượng truy cập cực kỳ cố định, nhưng lưu lượng truy cập suy luận thực tế không tuân theo một mẫu tĩnh. Để thực hiện kiểm tra hiệu năng với một kịch bản ít cứng nhắc hơn, chúng ta có thể sử dụng một số núm điều chỉnh tác vụ tổng hợp của AIPerf để đưa ra sự biến đổi cho các yêu cầu của mình.
aiperf profile \
  --model Qwen/Qwen3-0.6B \
  --endpoint-type chat \
  --streaming \
  --url localhost:8000 \
  --request-rate 10 \
  --arrival-pattern poisson \
  --synthetic-input-tokens-mean 512 \
  --synthetic-input-tokens-stddev 128 \
  --output-tokens-mean 128 \
  --output-tokens-stddev 32 \
  --random-seed 42 \
  --request-count 200
Một vài thay đổi đã xảy ra so với bài kiểm tra hiệu năng tĩnh ở trên.
--arrival-pattern poisson với --request-rate 10 có nghĩa là các yêu cầu đến với tốc độ trung bình 10 yêu cầu mỗi giây, với thời gian giữa các lần đến được lấy từ phân phối mũ. Máy chủ lúc này trải qua các đợt bùng phát và khoảng trống thay vì một luồng người dùng duy nhất, đây chính là cách hàng đợi hoạt động dưới lưu lượng thực tế.
--synthetic-input-tokens-stddev 128 đưa ra phương sai xung quanh giá trị trung bình 512 token, tạo ra sự kết hợp giữa các prompt ngắn và dài. Máy chủ phải xử lý các độ dài prompt khác nhau trong giai đoạn prefill thay vì các prompt giống hệt nhau.
--output-tokens-stddev 32 thêm phương sai ở phía đầu ra. Lưu ý rằng min_tokens và ignore_eos đã bị loại bỏ khỏi lệnh này. Trong bài kiểm tra tĩnh, các cờ này cố định đầu ra chính xác ở 128 token để giữ cho đường cơ sở sạch sẽ; chúng tôi đang chủ động bỏ ràng buộc đó để phân phối đầu ra có thể thay đổi.
--random-seed 42 giúp việc lấy mẫu thời gian theo phân phối Poisson và độ dài tổng hợp có thể tái lập. Chạy lại lệnh này sẽ tạo ra cùng một chuỗi các yêu cầu.
--streaming là bắt buộc. Nếu không có chế độ phát trực tiếp, máy chủ sẽ gom toàn bộ phản hồi vào một lô trước khi gửi, và không có các sự kiện token đầu tiên hoặc token giải mã để đo lường.
Nhìn vào các chỉ số LLM từ lần chạy này, các phân phối rộng hơn đáng kể so với đường cơ sở tĩnh — điều này là dự kiến khi có nhiều yêu cầu cạnh tranh đồng thời để truy cập GPU và độ dài tiền xử lý (prefill) khác nhau tùy theo từng yêu cầu.
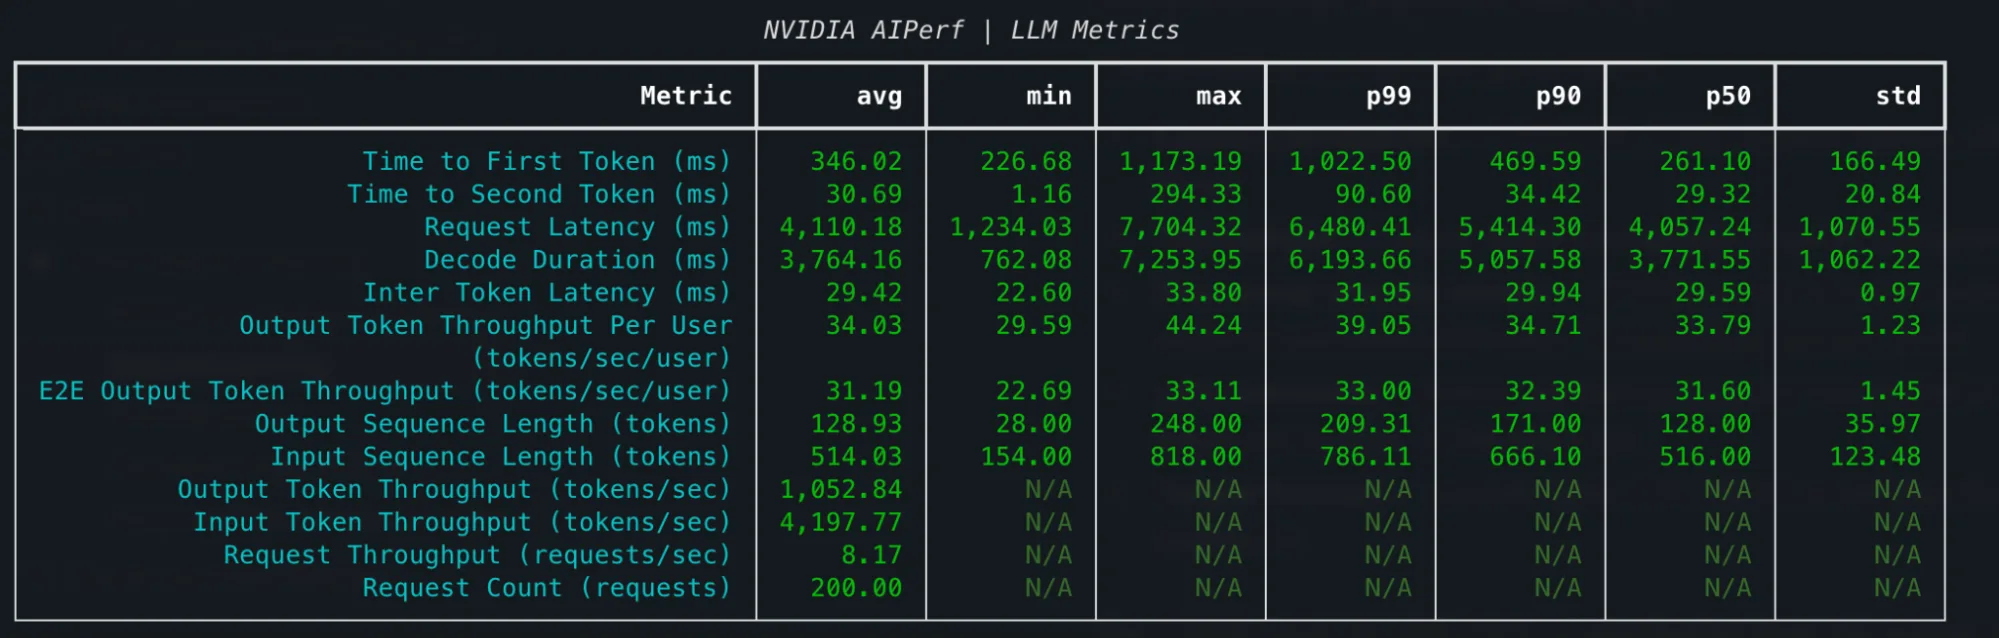 Hình 3. Một ảnh chụp màn hình ví dụ về các thống kê tóm tắt từ chế độ chạy với mô hình đến Poisson. Sự phân bố của các thống kê khác biệt đáng kể so với kịch bản tĩnh 512/128 do mô hình lưu lượng truy cập mới
Nhìn vào các biểu đồ trong Hình 4, bên dưới, bạn có thể thấy rằng dòng lệnh Poisson đã đưa ra một tốc độ yêu cầu có trung tâm, nhưng không hoàn toàn khớp, xung quanh 10 yêu cầu/giây. Tốc độ đến này mô phỏng sự dao động xung quanh thời điểm các yêu cầu đến so với chế độ không đổi, đảm bảo tốc độ cố định 10 yêu cầu/giây.
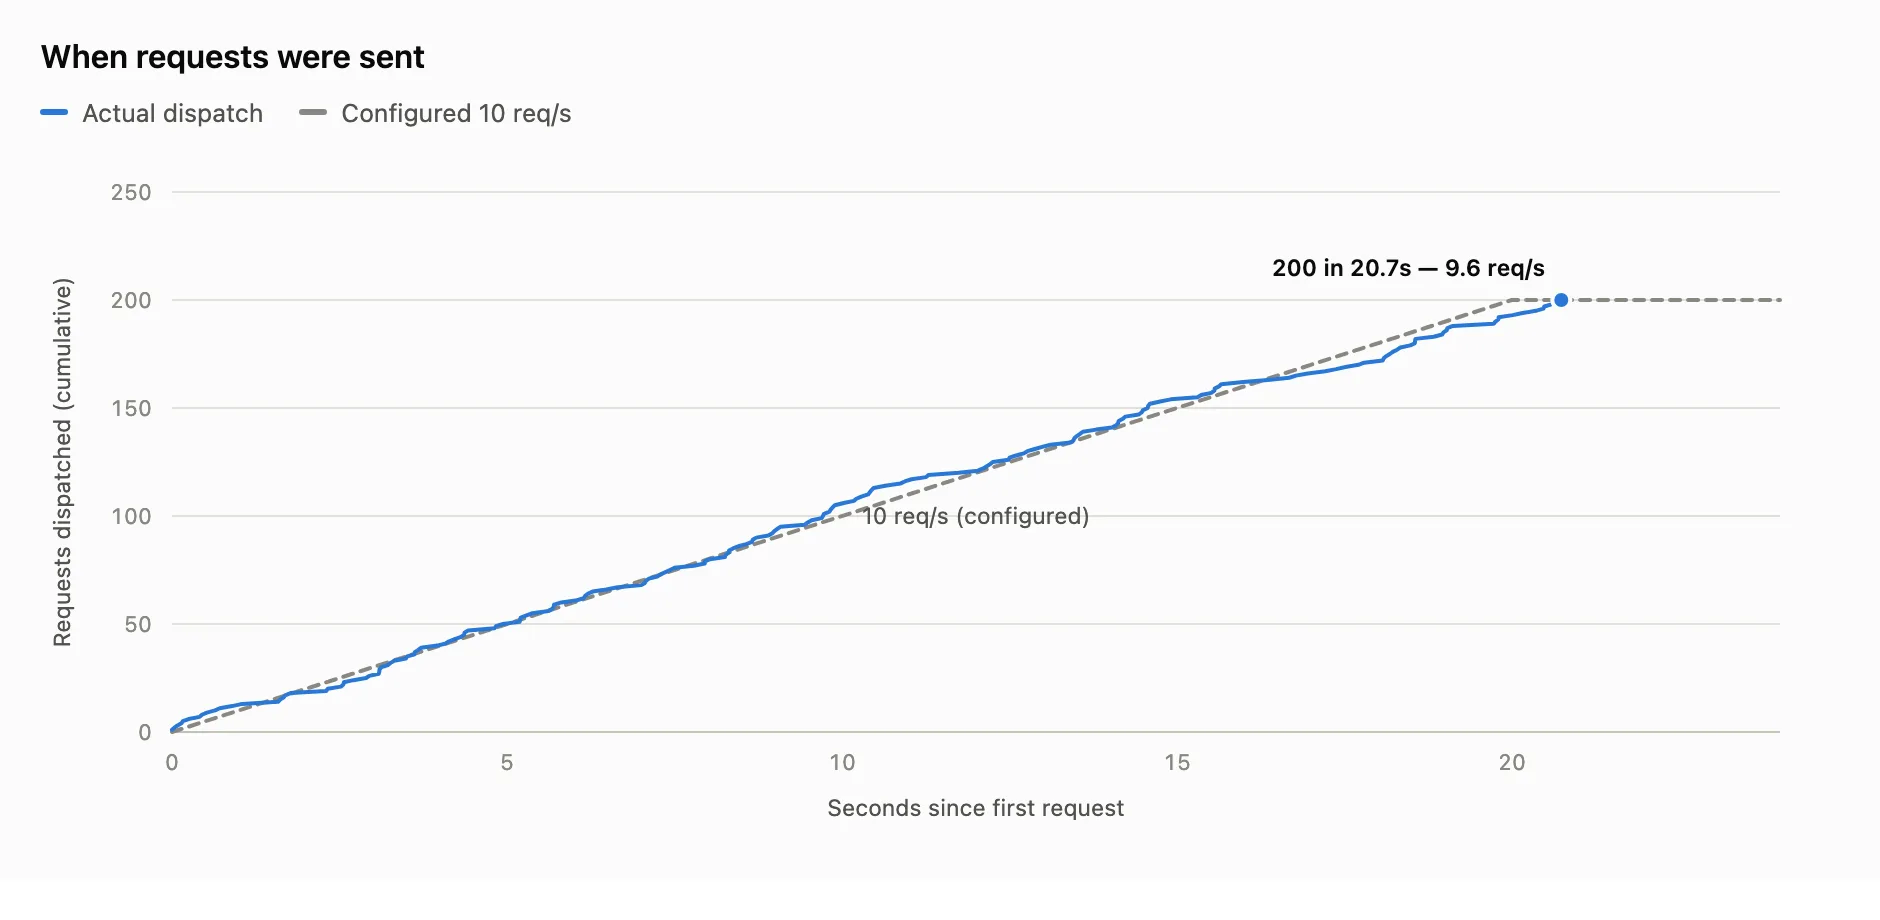 Hình 4. Độ trễ được báo cáo từ lúc yêu cầu đầu tiên được phân phối, so với chế độ 10 yêu cầu/giây không đổi, cho thấy sự biến đổi trong thời điểm phân phối tập trung xung quanh tốc độ yêu cầu đã chỉ định
Bạn có thể thấy trong Hình 5, bên dưới, rằng có sự biến đổi trong độ dài yêu cầu tập trung xung quanh giá trị trung bình là 512 token, với độ dài chuỗi đầu vào dao động từ 154 đến 818 token.
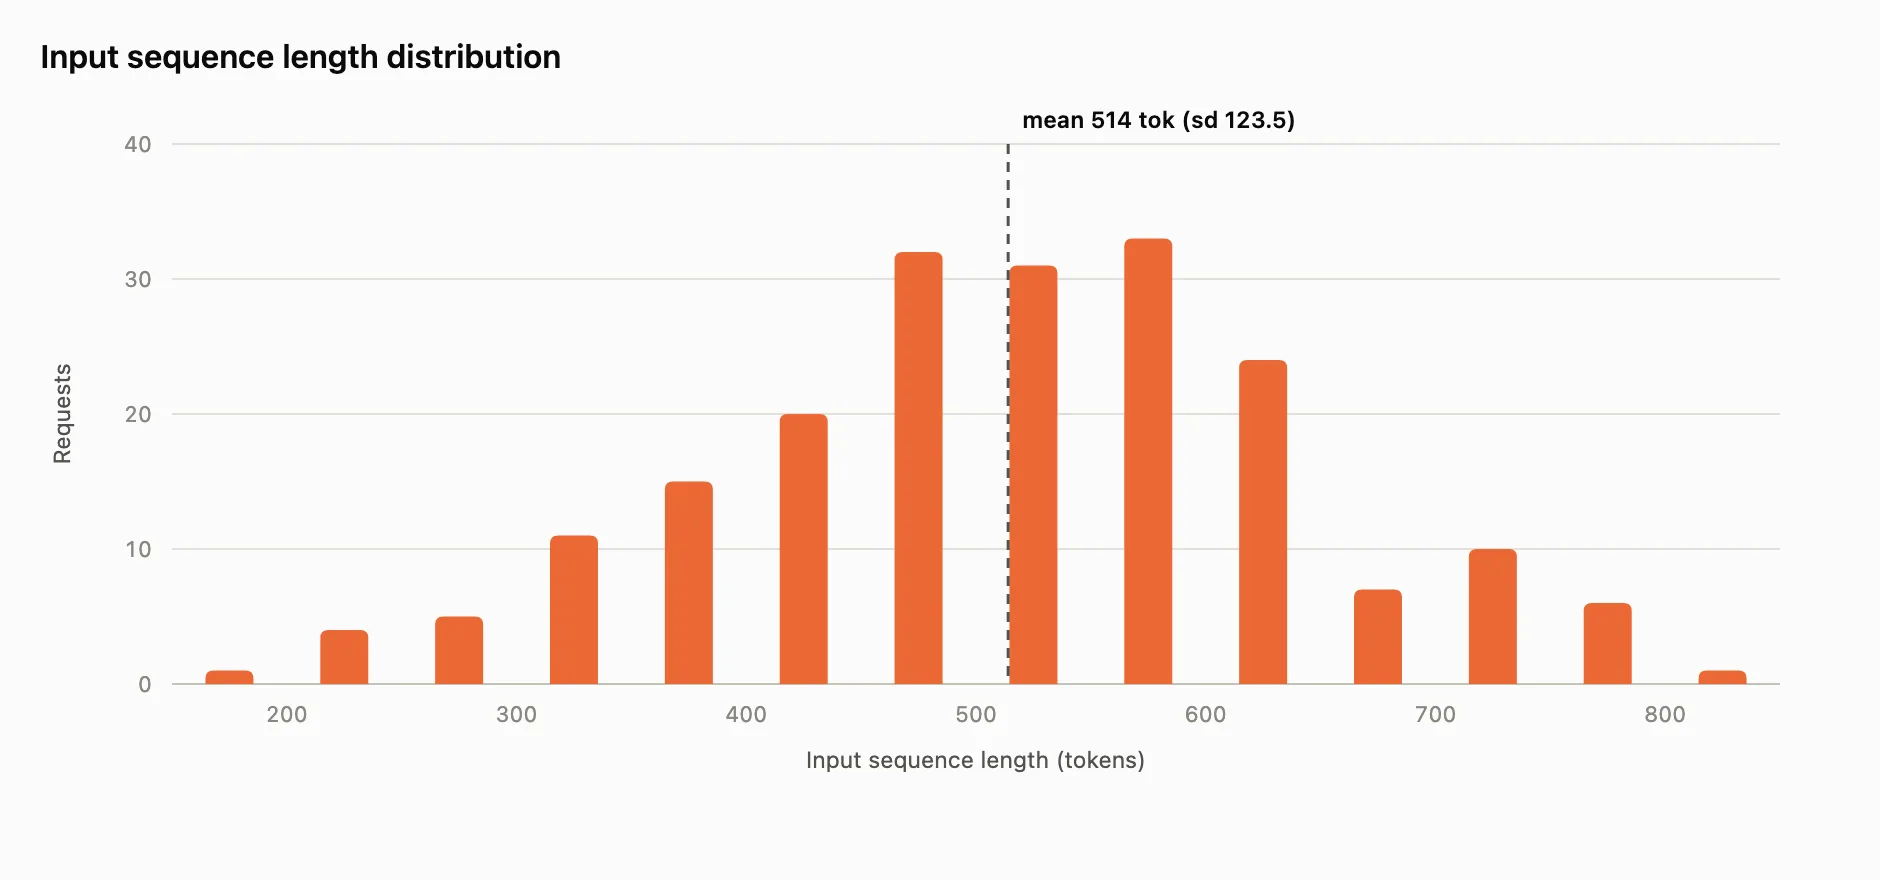 Hình 5. Một biểu đồ histogram cho thấy phân bố độ dài đầu vào (yêu cầu) tập trung xung quanh số lượng token trung bình 512 được yêu cầu
Khi so sánh TTFT giữa hai lần chạy, bạn có thể thấy rằng lần chạy theo phân phối Poisson cho thấy sự phân tán rộng hơn. Nhiều yêu cầu hơn đồng thời cạnh tranh quyền truy cập GPU, độ dài tiền xử lý (prefill) thay đổi và các thao tác tiền xử lý (prefill) cùng giải mã (decode) chồng lấn lên nhau. Trường hợp độ đồng thời đơn lẻ là một kịch bản lý tưởng hóa, chạy từng yêu cầu một để đạt được TTFT thấp nhất có thể, nhưng đánh đổi bằng thông lượng (throughput) thấp hơn.
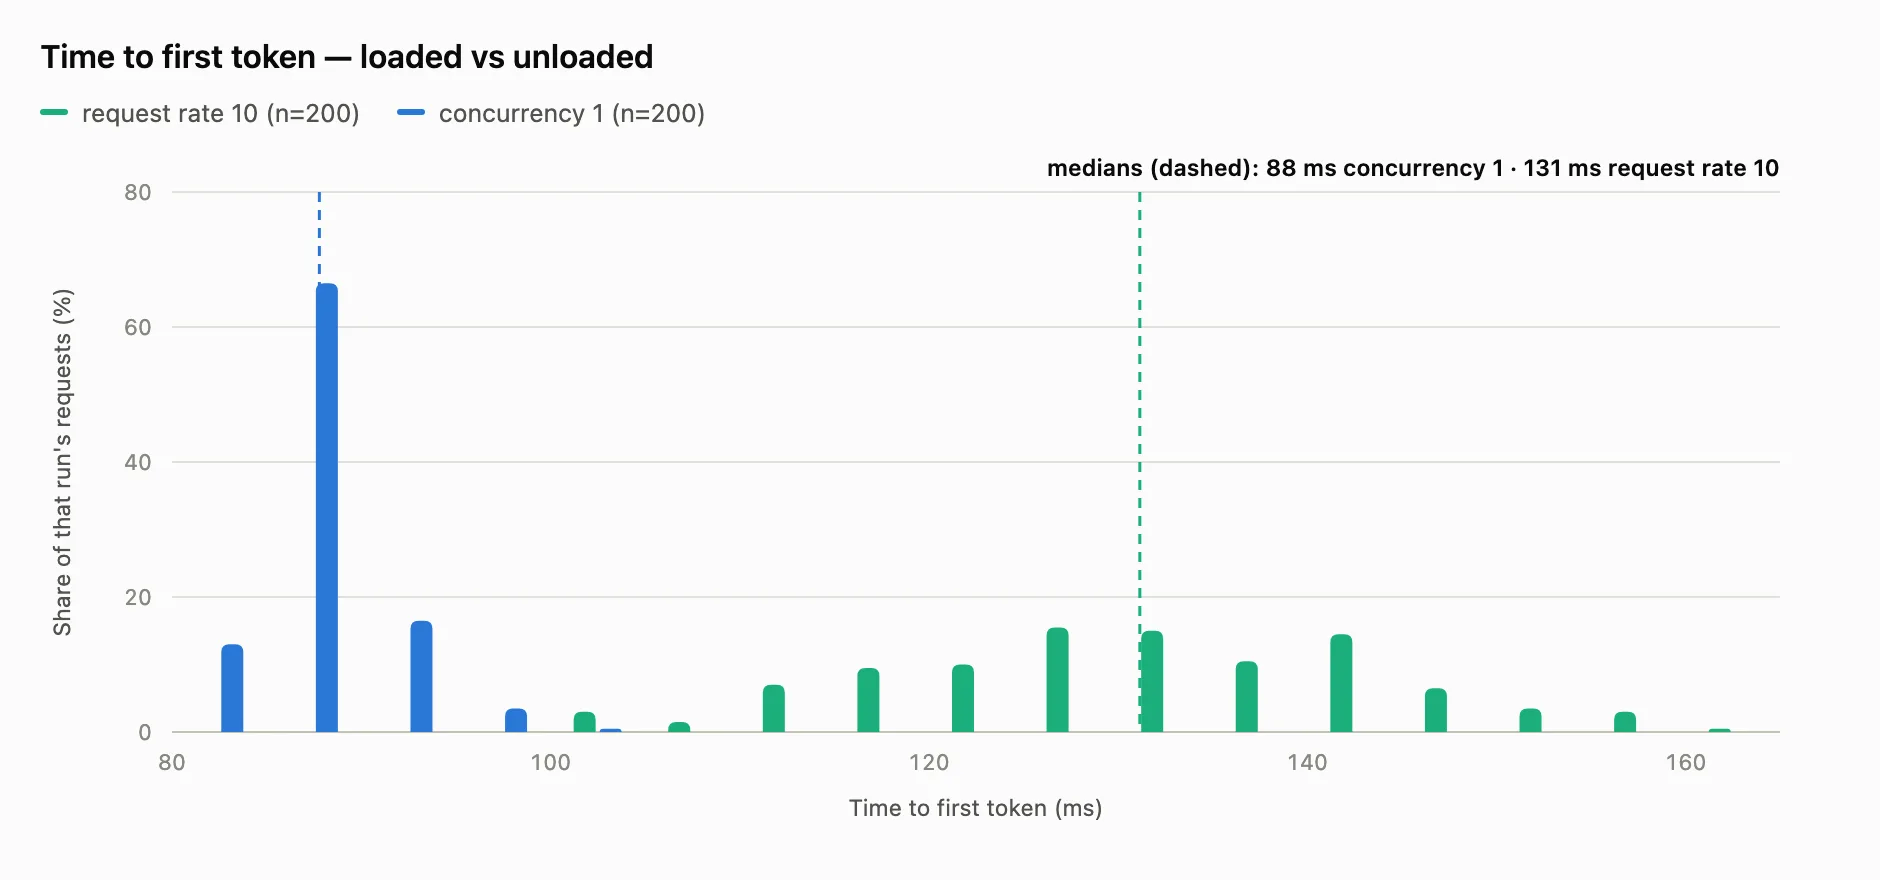 Hình 6. Biểu đồ histogram so sánh sự khác biệt trong phân phối thời gian đến token đầu tiên giữa một người dùng duy nhất đang hoạt động và mẫu đến Poisson mà AIPerf chạy
Trong Hình 6 ở trên, bạn có thể thấy rằng lần chạy với một người dùng duy nhất có biến động TTFT thấp hơn so với tải công việc đa dạng hơn nhiều trong thí nghiệm Poisson.
Còn nhiều điều để khám phá
Hướng dẫn này bao gồm các kiến thức cơ bản, nhưng AIPerf cũng được thiết kế cho các kịch bản phức tạp hơn.
Công cụ này xử lý các triển khai Kubernetes đa nút, cơ chế khởi động lại sử dụng lại KV cache, phát lại truy vết từ lưu lượng sản xuất, tổng hợp tiền tố, bộ dữ liệu tùy chỉnh và quét cấu hình qua các mức độ đồng thời.
Nếu bạn đang chạy suy luận phân tán ở quy mô lớn, hãy xem Cách NVIDIA Dynamo 1.0 Hỗ trợ Suy luận Đa nút ở Quy mô Sản xuất.
Các tài liệu hướng dẫn trong kho AIPerf là cách nhanh nhất để bắt đầu. Kho AIPerf và tài liệu là nguồn tham chiếu chính thức cho các tính năng mới và các đóng góp.
Lời cảm ơn
AIPerf là một nỗ lực hợp tác giữa NVIDIA và các cộng tác viên bên ngoài. Xin cảm ơn những người sau đây: Loki Ravi, Dan Ferguson và Sheng Moua (AWS) vì sự hợp tác liên tục, xác thực chéo giữa các công ty và những nỗ lực chuẩn hóa AIPerf; Aaron Batilo (Coreweave) vì trình xuất xuấtWeights & Biases, bộ dữ liệu spec-decode theo độ dài chấp nhận và việc tăng cường độ tin cậy của quá trình quét/treo credit dưới điều kiện đồng thời; Shounak Ray (Baseten) vì hỗ trợ phát lại dấu vết Baseten trung thành; Michael Feil (Baseten) vì tốc độ tải dấu vết nhanh hơn và các tiêu đề kết phiên. Cristian Lopez (Pinterest) vì sự hợp tác chặt chẽ của ông ấy trong phương pháp luận đánh giá hiệu năng dựa trên DAG. Chúng tôi rất biết ơn Ben Hamm vì những hướng dẫn về sản phẩm của ông ấy trong quá trình chúng tôi thiết kế, lập kế hoạch và triển khai AIPerf.
Bài viết liên quan
- Một nền tảng, hai cấu hình: Giải mã sự khác biệt giữa NVIDIA DGX Spark 64GB và 128GB
- Thêm các điều khiển thời gian chạy cho các tác nhân AI với NVIDIA OpenShell
- Giới thiệu NV-Reason-CT Open 3D CT VLM cho suy luận chuỗi suy nghĩ của bác sĩ chẩn đoán hình ảnh
- Open Agent Safety Platform: AI Agent cần một lớp an toàn nằm ngoài chính nó
- Thêm các runtime control cho các tác nhân AI với NVIDIA OpenShell