Bạn đã bao giờ mở terminal, gửi prompt cho Claude Code và không thấy phản hồi gì chưa? Trang trạng thái hệ thống báo lỗi mạng. Hoặc có thể một đợt tái cấu trúc (refactor) mã nguồn vừa làm cạn kiệt giới hạn mức sử dụng của nhóm bạn.
Claude Code là một AI agent hỗ trợ lập trình vô cùng mạnh mẽ, nhưng mặc định nó phụ thuộc vào máy chủ của Anthropic để hoạt động. Điều này kéo theo các vấn đề về thời gian hoạt động (uptime), ranh giới quyền riêng tư và chi phí. Câu hỏi thực tế được đặt ra là: Liệu chúng ta có thể chạy agent này cục bộ mà không cần truy cập cloud, không cần đăng nhập hay trả phí đăng ký?
Trong bài viết này, chúng ta sẽ cùng khám phá cách trỏ Claude Code vào một mô hình DeepSeek V4 (284 tỷ tham số) chạy hoàn toàn cục bộ trên một hệ thống NVIDIA DGX Spark duy nhất. Sau đó, chúng ta sẽ thử nghiệm khả năng sửa lỗi của agent này và so sánh với ba coding agent khác để đánh giá hiệu năng thực tế.
Ad
Claude Code Là Gì Và Tại Sao Nên Chạy Cục Bộ?
Claude Code là công cụ lập trình dựa trên terminal của Anthropic. Nó có thể đọc repository của bạn, chỉnh sửa file, chạy lệnh và lặp qua một chu trình agent (agent loop) hoàn chỉnh.
Theo mặc định, công cụ này kết nối với hạ tầng đám mây của Anthropic. Tuy nhiên, có ba lý do chính để bạn cân nhắc chạy nó bằng một mô hình cục bộ (Local LLM), vượt lên trên sự tiện lợi của AI đám mây:
-
Kiểm soát hoạt động và Uptime: Mô hình cục bộ được duy trì bởi chính đội ngũ của bạn, trên hạ tầng phần cứng của bạn. AI cục bộ loại bỏ hoàn toàn sự phụ thuộc vào các dịch vụ API bên thứ ba.
-
Quyền riêng tư và bảo mật dữ liệu: Mã nguồn, các câu prompt, log, thông tin đăng nhập và toàn bộ dữ liệu nội bộ không bao giờ rời khỏi môi trường của bạn. Điều này là bắt buộc đối với các nhóm làm việc với dữ liệu y tế (HIPAA), dữ liệu tài chính, mã nguồn độc quyền, hoặc các hệ thống bị cô lập mạng (air-gapped). Với Local LLM, dữ liệu nhạy cảm có thể được phân tích cục bộ.
-
Dự báo trước chi phí: Bạn sẽ không phải trả phí đăng ký theo số lượng người dùng hay số lượng token sử dụng. Sau khi đầu tư phần cứng một lần, bạn có thể chạy bao nhiêu vòng lặp agentic, kiểm thử hay refactor tùy thích; chi phí phát sinh duy nhất chỉ là điện năng tiêu thụ.
Sự đánh đổi ở đây là bạn đang sử dụng một mô hình có khả năng chạy cục bộ, thay vì một mô hình cloud sở hữu năng lực ở quy mô “frontier”. Hãy cùng đo lường xem sự đánh đổi này ảnh hưởng ra sao trên hệ thống NVIDIA DGX Spark thực tế.
Thay Đổi Mô Hình Mà Claude Code Sử Dụng
Claude Code sử dụng Anthropic Messages API (/v1/messages), nhưng nó hoàn toàn không quan tâm máy chủ nào trả lời API đó, miễn là máy chủ đó hỗ trợ cùng một giao thức.
Có hai công cụ máy chủ cục bộ có thể tạo ra các endpoint tương thích với Anthropic: DS4 (engine được sử dụng cho mô hình lớn trong bài test này) và Ollama. Chỉ cần trỏ biến môi trường ANTHROPIC_BASE_URL vào localhost của DS4 hoặc Ollama, Claude Code sẽ lập tức sử dụng mô hình cục bộ của bạn.
Bash
export ANTHROPIC_BASE_URL=http://localhost:8080 # máy chủ cục bộ của bạn
export ANTHROPIC_AUTH_TOKEN=dummy # máy chủ cục bộ sẽ bỏ qua tham số này
Chạy Mô Hình 284B Trên Hệ Thống NVIDIA DGX Spark
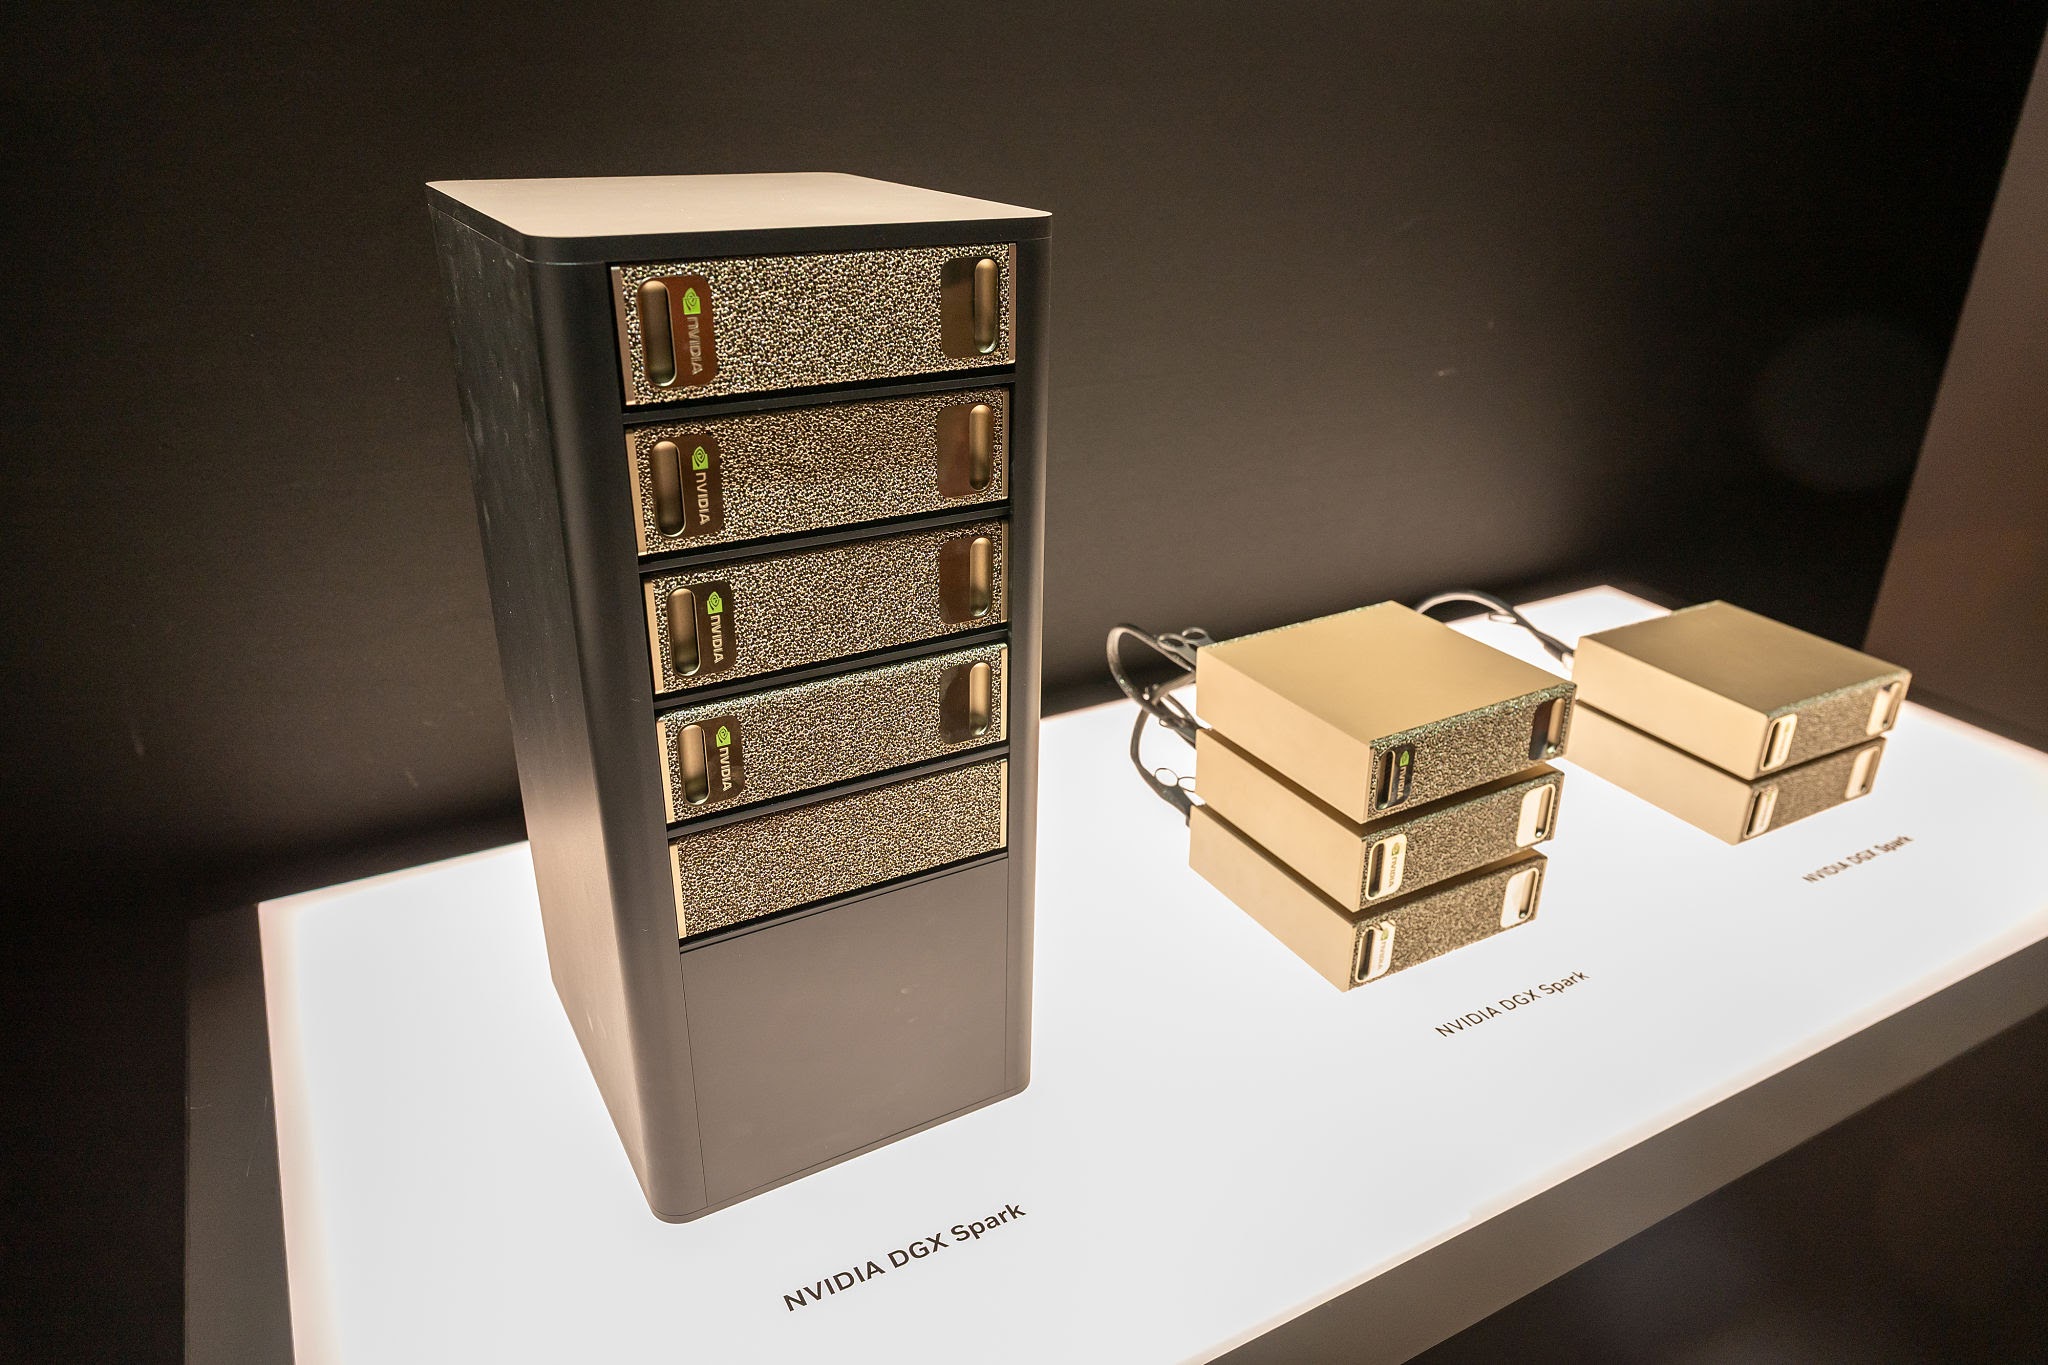
DeepSeek V4 Flash là một mô hình lớn với 284 tỷ tham số. Ở độ chính xác đầy đủ, nó chiếm khoảng 568 GB bộ nhớ trọng số (weights), một con số thường yêu cầu hệ thống cấp độ data center. Vậy làm thế nào để nó chạy trên một trạm NVIDIA DGX Spark duy nhất?
Phương pháp lượng tử hóa chọn lọc (Selective Q2 GGUF – dùng 2-bit cho hầu hết trọng số, và 8-bit cho các phần trọng yếu) đã nén mô hình xuống còn khoảng 86 GB. Mức dung lượng này vừa vặn trong 128 GB bộ nhớ thống nhất (unified memory) của DGX Spark. Chúng ta phục vụ mô hình này bằng DS4, một engine suy luận CUDA gốc được tối ưu cho kiến trúc này.
Kết quả đo lường thực tế trên NVIDIA DGX Spark:
-
86 GB trọng số, được tải vào bộ nhớ chỉ trong 10.5 giây.
-
Tốc độ sinh text: ~15 tokens/giây ở chế độ luồng đơn (single stream).
-
Context window: 128K token sử dụng thêm khoảng 3 GB bộ nhớ đệm (context buffer).
-
Sau khi tải: Còn trống khoảng 1 GB bộ nhớ. Mô hình hoạt động ổn định, nhưng gần như lấp đầy tài nguyên của máy.
Tại Việt Nam, Nhất Tiến Chung (NTC) tự hào là đối tác cấp Elite của mạng lưới NVIDIA Partner Network. Nếu doanh nghiệp của bạn đang tìm kiếm giải pháp chuyên dụng để chạy các mô hình AI ngôn ngữ lớn (LLM) và hệ thống Agentic AI cục bộ, đội ngũ chuyên gia của NTC sẵn sàng tư vấn các hạ tầng tiên tiến nhất từ NVIDIA DGX Spark, DGX B300, DGX GB300 cho đến việc quy hoạch thiết kế các hệ thống AI Factory hoặc SuperPOD quy mô lớn.
Hướng Dẫn Từng Bước: Triển Khai Claude Code Cục Bộ
Việc thiết lập chỉ cần ba bước cơ bản.
Bước 1: Phục vụ mô hình bằng DS4, cấu hình endpoint Anthropic trên cổng 8080:
Bash
./ds4-server --cuda \
-m DeepSeek-V4-Flash-IQ2XXS-...-imatrix.gguf \
--ctx 131072 --host 127.0.0.1 --port 8080 --cors
Bước 2: Trỏ Claude Code vào endpoint vừa tạo:
Bash
export ANTHROPIC_BASE_URL=http://localhost:8080
export ANTHROPIC_AUTH_TOKEN=dummy
export ANTHROPIC_MODEL=deepseek-v4-flash
Bước 3: Chạy Claude Code để giao tác vụ:
Bash
claude -p "fix the failing test" --model deepseek-v4-flash --dangerously-skip-permissions
Thiết lập này hoàn toàn không yêu cầu đăng nhập, không cần API key và không yêu cầu kết nối internet ngoài môi trường mạng nội bộ. (Tham số --dangerously-skip-permissions được dùng khi test tự động trên các repo thử nghiệm để AI không yêu cầu xác nhận trước mỗi lần chạy script).
Thử Nghiệm Claude Code Trên Tác Vụ Sửa Lỗi (Bug-fix)
Để kiểm tra độ hiệu quả, chúng tôi chuẩn bị một ứng dụng to-do nhỏ bằng Python có chứa một lỗi cố ý: cờ --due được chấp nhận khi gõ trên dòng lệnh nhưng không bao giờ được ứng dụng lưu lại. Trong số 13 bài test (test suite) đi kèm, có 2 bài test bị lỗi vì nguyên nhân này.
Chúng tôi giao cho Claude Code (sử dụng mô hình DeepSeek V4 nội bộ) một chỉ thị duy nhất: “Cờ --due đang bị bỏ qua — hãy tìm lỗi, sửa nó và chạy các bài test để chứng minh nó đã được sửa.”
Agent đã đọc qua mã nguồn project, xác định chính xác vị trí lỗi và tự động áp dụng bản vá:
Python
if due:
    todo["due"] = due
Ngay sau đó, agent tự chạy lại bộ test: kết quả 13/13 bài test thành công. Quá trình này được phân tích, lập luận và hoàn thành trong chưa tới 3 phút, hoàn toàn chạy cục bộ.
Đánh Giá: Claude Code vs OpenCode vs Qwen Code
Sức mạnh của một mô hình 284B là không thể bàn cãi, nhưng chúng tôi cũng muốn so sánh với các lựa chọn khác. Cùng một bài toán sửa lỗi được đưa qua ba coding agent và bốn mô hình nội bộ khác nhau.
| Công cụ điều phối (Harness) | DeepSeek-V4 284B | qwen3-coder-80B | qwen3.6-35B | Ornith-1.0-35B |
| OpenCode | 231 s · 13/13 | 20 s · 13/13 | 43 s · 13/13 | 43 s · 13/13 |
| Claude Code | 172 s · 13/13 | 60 s · 13/13 | 43 s · 13/13 | ✗ lỗi template |
| Qwen Code | 181 s · 13/13 | 31 s · 13/13 | 24 s · 13/13 | 43 s · 13/13 |
Phân tích kết quả:
-
Chất lượng không phải là rào cản: 11 trên 12 lần chạy đều sửa lỗi thành công tuyệt đối (13/13). Thất bại duy nhất của Ornith-35B khi kết hợp với Claude Code là do xung đột định dạng template (mô hình yêu cầu message hệ thống đứng trước, dẫn đến lỗi HTTP 400).
-
Mô hình quyết định thời gian thực thi: DeepSeek V4 284B tốn khoảng 170–230 giây vì tốc độ sinh khoảng 15 token/s. Trong khi đó, các mô hình coder cỡ trung và nhỏ hoàn thành chỉ trong 20–60 giây. Đối với các tác vụ lập trình và cấu trúc mã hàng ngày, một mô hình nhỏ và có tốc độ xử lý nhanh sẽ hữu ích hơn. Hãy dành mô hình 284B cho những công việc yêu cầu tư duy sâu.
-
Công cụ điều phối (Harness) rất quan trọng: Cùng sử dụng
qwen3-coder-80B, OpenCode hoàn thành trong 20 giây nhưng Claude Code lại cần đến 60 giây. AI Agent của bạn xử lý công việc hiệu quả đến đâu phụ thuộc rất nhiều vào công cụ điều phối phía trên.
Lựa Chọn Kiến Trúc Agent: Chiều Sâu vs. Chiều Rộng
Khi đã chạy được các AI agent trong mạng nội bộ, câu hỏi thực sự không phải là mô hình nào mạnh nhất, mà là luồng công việc (workflow) của nhóm bạn thiết kế như thế nào.
-
Chiều sâu (Depth): Nếu bài toán đòi hỏi một lời giải cực kỳ phức tạp, sử dụng mô hình “khổng lồ” như DeepSeek V4 284B sẽ đem lại kết quả tốt nhất. Ở tình huống này, khả năng gom lô (batching) tốc độ cao không quá quan trọng vì lượng yêu cầu ít.
-
Khối lượng trung bình (Middle): Đối với lập trình viên làm việc hàng ngày, mô hình cần phản hồi siêu tốc cho các luồng xử lý đơn lẻ, nhưng vẫn phải chịu tải tốt nếu tần suất truy vấn tăng.
qwen3-coder-80Blà một mô hình MoE rất lý tưởng cho trường hợp này. -
Chiều rộng (Breadth / Fan-out): Các luồng công việc khởi chạy hàng loạt agent phụ (sub-agents) cùng lúc — ví dụ: 8 công cụ review mã nguồn chạy song song. Ở kiến trúc này, engine AI bắt buộc phải xử lý batching hiệu quả. Đồng thời, mô hình nhỏ sẽ có lợi thế hơn do các agent chạy song song sẽ cạnh tranh bộ nhớ RAM để lưu trữ KV-cache context.
Lời Kết
Việc chạy Claude Code ở chế độ cục bộ là một chiến lược thực tiễn cho các doanh nghiệp CNTT muốn bảo mật tối đa dữ liệu, làm chủ uptime và cắt giảm chi phí API về lâu dài. Chỉ bằng việc trỏ môi trường phát triển vào một endpoint tương thích với Anthropic API, một trạm như DGX Spark có thể gánh vác vòng lặp agentic AI phức tạp để rà soát và tối ưu mã nguồn trong thực tế.
Khả năng của mô hình gốc giờ đây không còn là giới hạn duy nhất. Thành công của việc tích hợp AI Agent vào hạ tầng nằm ở sự cộng hưởng giữa mô hình tốt, engine suy luận tối ưu, công cụ điều phối (harness) thông minh và quan trọng nhất là một nền tảng phần cứng đáng tin cậy. Nếu doanh nghiệp của bạn đang lên kế hoạch triển khai AI chuyên sâu cho đội ngũ phát triển, Nhất Tiến Chung tự tin là đơn vị đồng hành cung cấp giải pháp máy chủ AI tối ưu nhất, bảo chứng bởi hệ sinh thái hạ tầng mạnh mẽ của NVIDIA.
NTC×AI
Bài viết liên quan
- So sánh các công cụ suy luận trên NVIDIA DGX Spark: Ollama, vLLM và DS4
- NVIDIA PAIR Virtual Inference Router mở rộng khả năng tính toán có sẵn trên mạng nội bộ của bạn
- Xây dựng chatbot AI nội bộ cho doanh nghiệp: Nhanh hơn, đúng ngữ cảnh hơn, kiểm soát tốt hơn
- Triển khai hệ thống Voice RAG bằng NVIDIA Riva framework trên hạ tầng cục bộ
- NVIDIA nâng cấp các AI Agent cục bộ trên RTX PC và DGX Spark