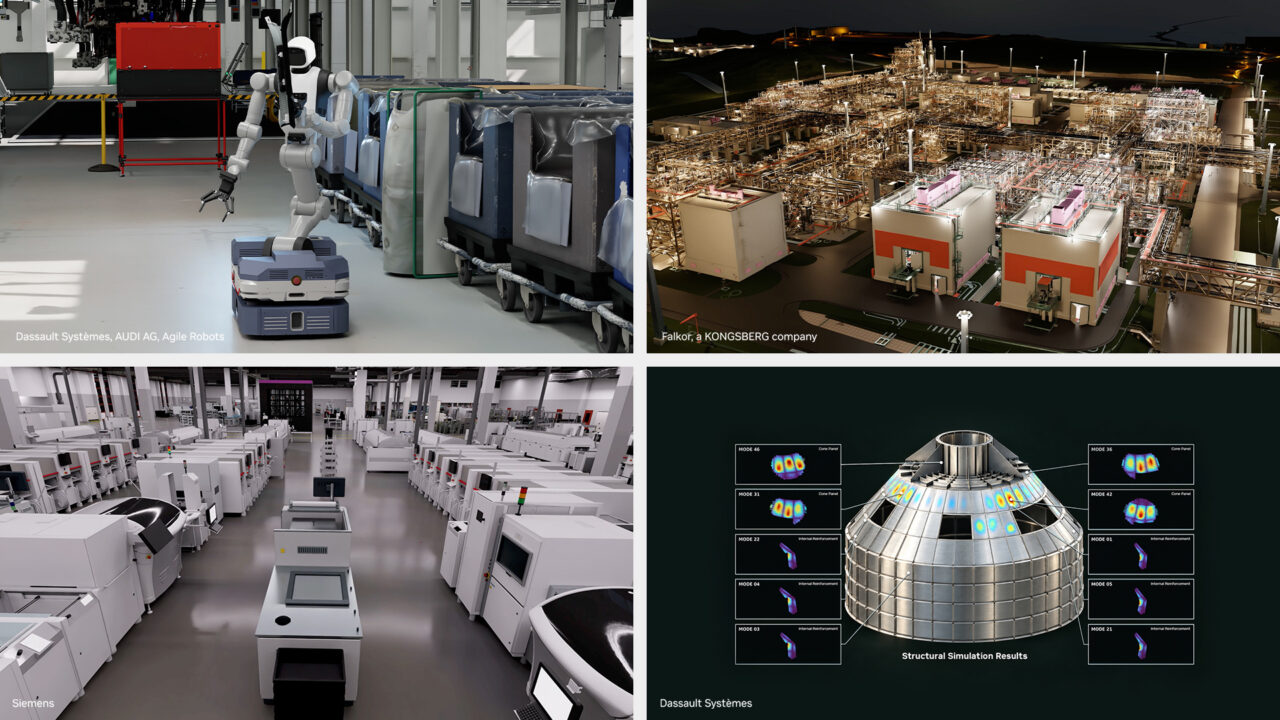
Bốn lớp công nghệ, một vòng đời: các tập đoàn công nghiệp châu Âu đang dùng thư viện NVIDIA CUDA-X, thư viện Omniverse, cùng hai họ mô hình mở Cosmos và Nemotron để rút ngắn toàn bộ chu trình từ bản vẽ CAD đến dây chuyền sản xuất.
Tại GTC Berlin ngày 21/10/2026, NVIDIA công bố ba mốc kỹ thuật đáng chú ý cho ngành công nghiệp: thư viện giải hệ thưa cuDSS phát hành chính thức (GA), Factory Operations Blueprint (FOX) mở truy cập sớm trên GitHub, và loạt ca triển khai của Siemens, Mercedes-Benz, Audi, Schaeffler, Leonardo, Saab, Infineon, Schneider Electric và nhiều hãng khác.
FOX Blueprint: bộ não tác tử cho nhà máy, nay đã mở truy cập sớm
NVIDIA Factory Operations Blueprint (FOX) là thiết kế tham chiếu để xây dựng một tác tử quản lý nhà máy (factory manager agent) chạy liên tục, điều phối một đội tác tử chuyên biệt và máy móc. Từ GTC Berlin, mã nguồn mở truy cập sớm trên GitHub.
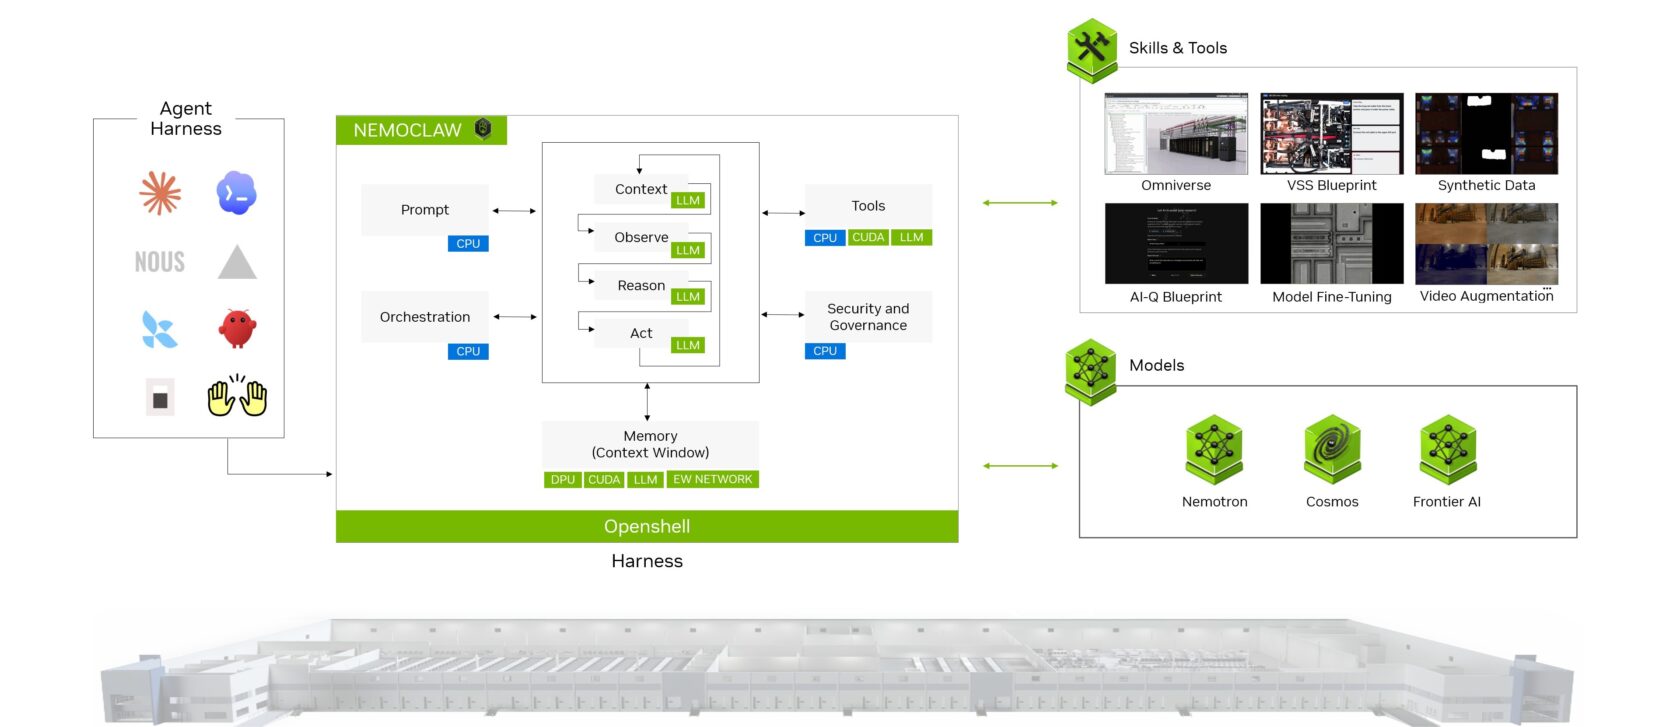
Ngăn xếp phần mềm. FOX được xây dựng trên NemoClaw (khung chạy tác tử), AI-Q Blueprint (truy xuất và lập luận trên dữ liệu doanh nghiệp) và mô hình mở Nemotron. Tác tử kết nối với mô hình tiên phong gồm Cosmos (thị giác – vật lý) và Nemotron (ngôn ngữ – lập luận), cùng tri thức nền từ CAD, PLM, phần mềm mô phỏng và các hệ thống IT/OT. Chính sách quyền hạn và guardrail do OpenShell đảm nhiệm.
Ba khả năng kỹ thuật cốt lõi:
- Kết nối hệ thống và tác tử: tích hợp nguồn dữ liệu công nghiệp, máy móc, ứng dụng và đội robot qua API chuẩn và agent skills.
- Tự động hóa huấn luyện mô hình: dùng kỹ năng NVIDIA TAO để phát hiện lỗ hổng độ chính xác, sinh dữ liệu tổng hợp, tinh chỉnh và tái triển khai mô hình thị giác.
- Vận hành quy trình thông minh: tác tử kiểm tra ngoại quan, tuân thủ quy trình và vận chuyển vật tư dựa trên Metropolis VSS blueprint; dữ liệu thời gian thực được hiển thị trên bản sao vận hành xây bằng thư viện Omniverse.
Điểm đáng chú ý về mô hình: với in-context learning của Cosmos, tác tử thích nghi bằng ví dụ và tài liệu đính kèm trong ngữ cảnh, không cần fine-tuning. Điều này rút ngắn đáng kể thời gian đưa một ca kiểm tra mới vào vận hành.
| Tác tử chuyên biệt | Việc làm | Thành phần NVIDIA |
|---|---|---|
| Kiểm tra ngoại quan (visual inspection) | Phát hiện lỗi sản phẩm, linh kiện từ camera | Cosmos VLM, Metropolis VSS, TAO |
| Phân tích nguyên nhân gốc (root cause) | Đối chiếu phát hiện thị giác với log máy để tìm nguyên nhân | Nemotron, AI-Q, Cosmos |
| Tạo báo cáo | Tổng hợp sự cố, năng suất, chất lượng theo ca | Nemotron, AI-Q |
| Quản lý đội robot (fleet) | Điều phối AMR, humanoid, giảm thiết bị dự phòng | Isaac, Omniverse, OpenShell |
| Kiểm tra tuân thủ SOP | Xác minh thao tác lắp ráp theo quy trình chuẩn | Metropolis VSS, Cosmos 3 |
Siemens là ca triển khai đầu tiên ở châu Âu. Siemens tích hợp tác tử xây trên FOX vào Intelligence Center X, hệ thống doanh nghiệp tác tử của hãng, để tìm nguyên nhân gốc và điều phối vận hành, ước tính tiết kiệm 20% chi phí. Tác tử Process Preparation X dùng công cụ và kỹ năng Cosmos Data Factory để sinh ảnh lỗi tổng hợp cho kiểm tra bo mạch. Tại nhà máy điện tử Erlangen, cách làm này giúp giảm 40% thời gian hiệu chuẩn quy trình kiểm tra.
Siemens và Maserati
Phần cứng tham chiếu. FOX được tối ưu cho DGX Station với siêu chip GB300 Grace Blackwell Ultra Desktop: 20 PFLOPS FP4, 748GB bộ nhớ nhất quán (coherent), chạy mô hình đến 1.000 tỷ tham số. GPU Blackwell Ultra nối CPU Grace qua NVLink-C2C, phù hợp với vòng lặp gọi mô hình liên tục của NemoClaw.
Tăng tốc kỹ thuật từ bản thiết kế đầu tiên: CUDA-X, cuDSS, PhysicsNeMo và Warp
Mô phỏng chạy nhanh hơn đồng nghĩa với nhiều phương án thiết kế được thử hơn trước khi làm mẫu vật lý. Mốc kỹ thuật lớn nhất ở GTC Berlin là cuDSS, thư viện CUDA-X giải hệ phương trình thưa (sparse direct solver), chính thức GA.
cuDSS giải bài toán gì? Phần lớn bộ giải phần tử hữu hạn (FEA), điện từ trường và mô phỏng linh kiện bán dẫn đều quy về việc giải lặp đi lặp lại các hệ tuyến tính thưa cỡ lớn Ax = b. Bước này thường chiếm phần lớn thời gian chạy và là nút cổ chai của toàn bộ mô phỏng. cuDSS chuyển bước đó lên GPU, có giao diện C, C++, Python và Fortran, mở rộng từ một workstation đến cụm máy chủ nhiều GPU.
| Ứng dụng ISV | Bộ giải / sản phẩm | Khách hàng | Kết quả công bố |
|---|---|---|---|
| Dassault Systèmes | Abaqus (kết cấu), CST (điện từ) | Ngành ô tô | Nhanh hơn 8–10x với cuDSS |
| Synopsys | Sentaurus Device | Infineon | 12x ở mô phỏng đánh thủng 3D linh kiện công suất |
| Synopsys | S-Litho | imec | Đến 40x trên mô hình của imec |
| Applied Materials | Ginestra | Nội bộ | Đến 10x so với CPU cho bước giải thưa |
| COMSOL | COMSOL Multiphysics | ZEISS SMT | 4x ở mô phỏng plasma EUV, hoàn tất trong 6 ngày 14 giờ |
| Cadence | Celsius (nhiệt, cong vênh chip 3D) | Nokia | Phân tích thiết kế phức tạp nhanh hơn |
| Siemens | Simcenter STAR-CCM+ | Mercedes-Benz | So sánh khí động học nhiều phương án xe trên GPU |
Mô hình thay thế bằng AI vật lý. Bên cạnh bộ giải số, châu Âu đang dùng hai khung của NVIDIA để huấn luyện mô hình thay thế (surrogate) học từ dữ liệu mô phỏng:
- PhysicsNeMo: khung huấn luyện mô hình AI vật lý (neural operator, PINN, GNN) trên PyTorch. Autodesk đưa PhysicsNeMo và Warp vào NavPack, tích hợp với Alias, để nhà thiết kế tại Bentley dự đoán hiệu năng xe ngay trong lúc tạo hình.
- Warp: khung Python viết kernel mô phỏng vật lý khả vi, biên dịch thẳng sang CUDA. UniversalAGI dùng Warp để tăng tốc mô hình nền Latent Interaction Field Transformer, đánh giá hàng nghìn điều kiện sóng và hướng tàu theo thời gian thực cho Saab, thay vì hàng ngày. Tác tử Sofia của Fermioniq dịch yêu cầu ngôn ngữ tự nhiên thành bộ giải dòng chảy sông xây trên Warp cho Deltares và các bộ của Hà Lan.
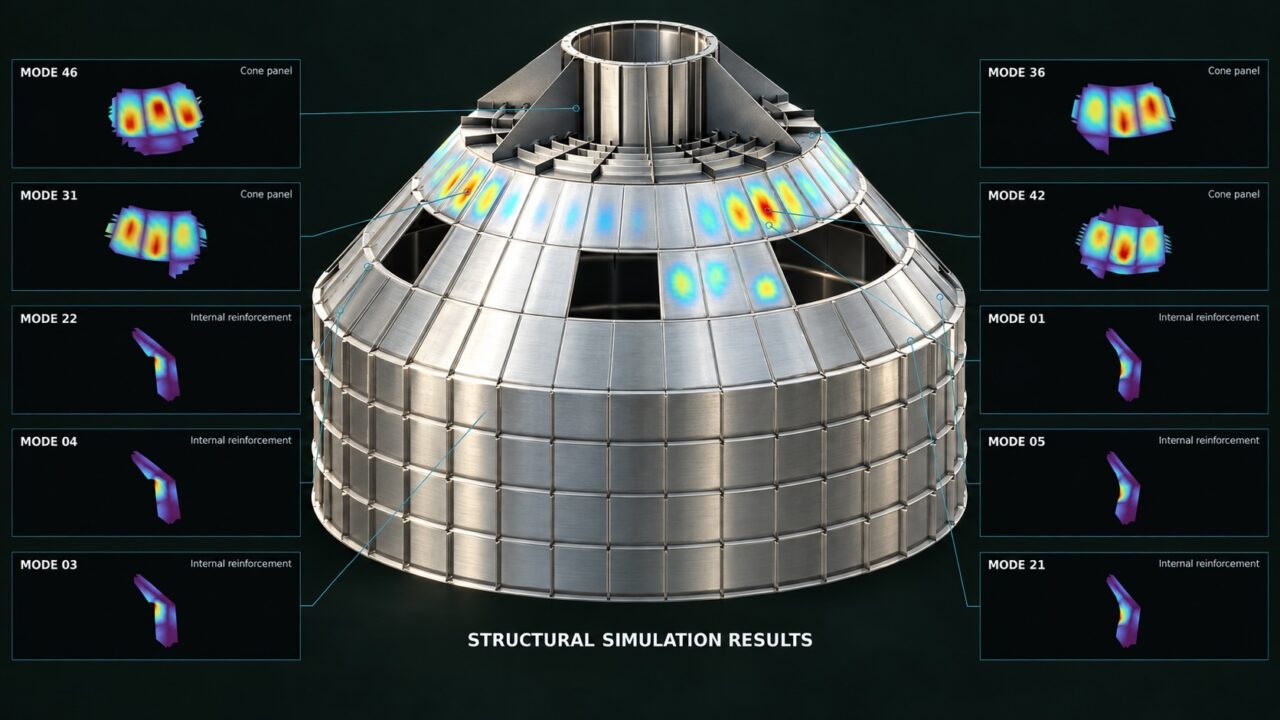
Omniverse cho trực quan hóa kết quả kỹ thuật. Leonardo cùng Neural Concept dùng thư viện Omniverse để ghép hình học máy bay với kết quả khí động học trong một cảnh OpenUSD; PhysicsX làm tương tự cho hình học thân tàu và trường áp suất của đội GB1 tại America’s Cup.
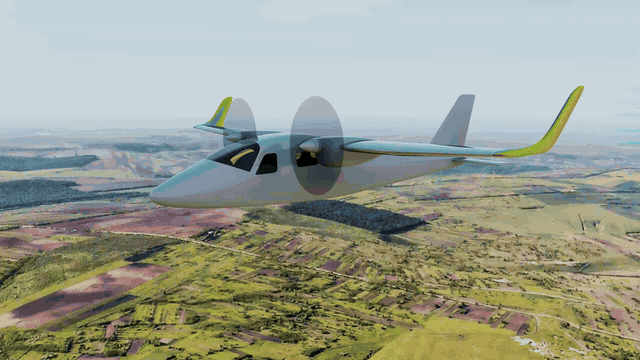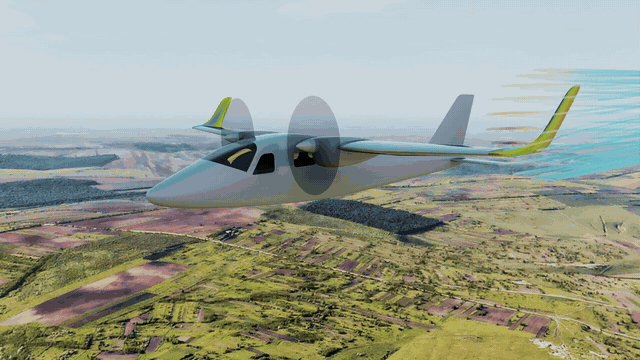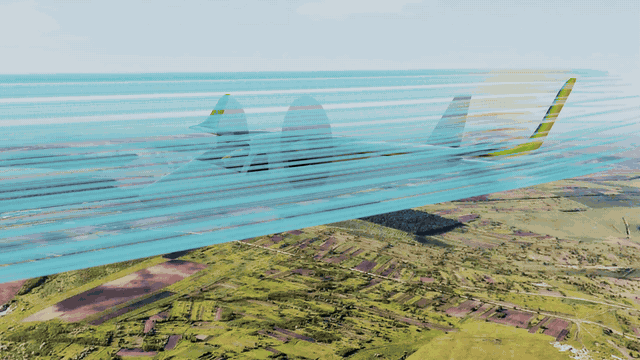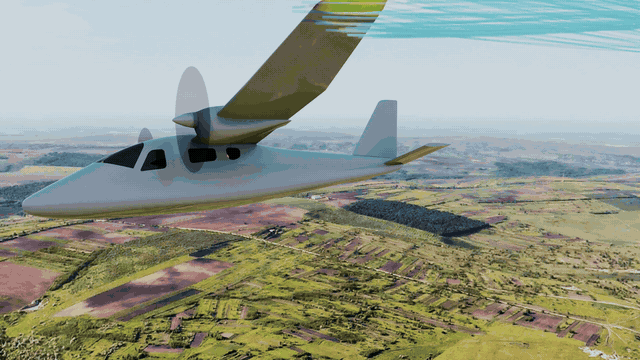
Tác tử trong vòng lặp thiết kế. Các hãng xe dùng LEO và AURA Virtual Companions của Dassault Systèmes, chạy trên Nemotron, để điều phối CATIA AI Agents và SIMULIA AI Agents với bộ giải SIMULIA tăng tốc bằng CUDA-X; mục tiêu là thiết kế và thử nghiệm ảo cửa xe trước khi làm mẫu. Mistral cũng công bố kế hoạch dùng CUDA-X, Warp và Omniverse để tăng tốc mô phỏng và sinh dữ liệu huấn luyện cho mô hình AI kỹ thuật.
Kiểm thử nhà máy và robot trong môi trường ảo: Omniverse, Isaac và OpenUSD
Thư viện Omniverse và Isaac cho phép xây bản sao số nhà máy và mô phỏng robot để đánh giá hệ thống sản xuất và hành vi robot trước khi thay đổi bất cứ thứ gì trên sàn nhà máy. Nền tảng dữ liệu chung là OpenUSD: một cảnh mô tả hình học, vật liệu, vật lý và metadata thiết bị, nhiều ứng dụng cùng đọc – ghi qua các lớp (layer) riêng.
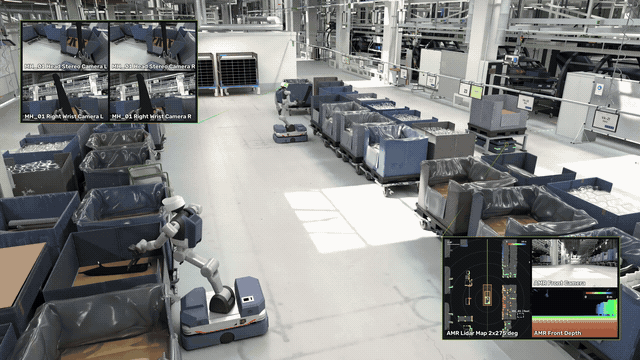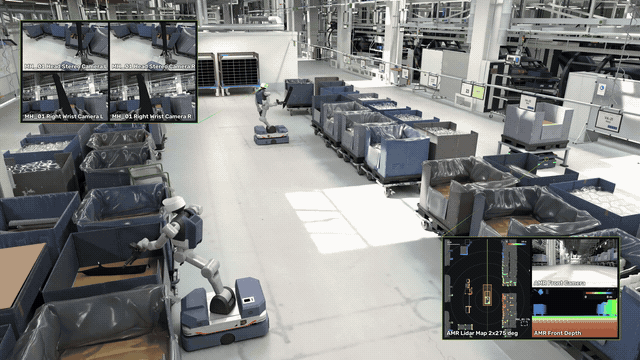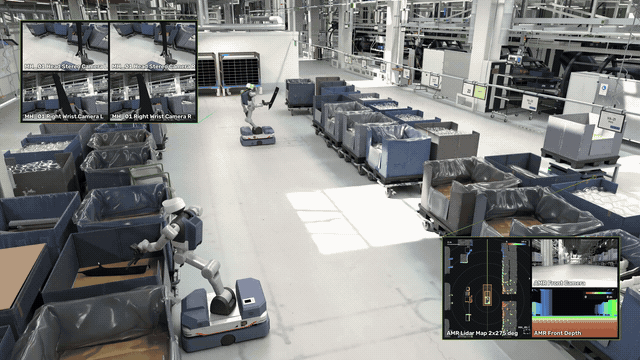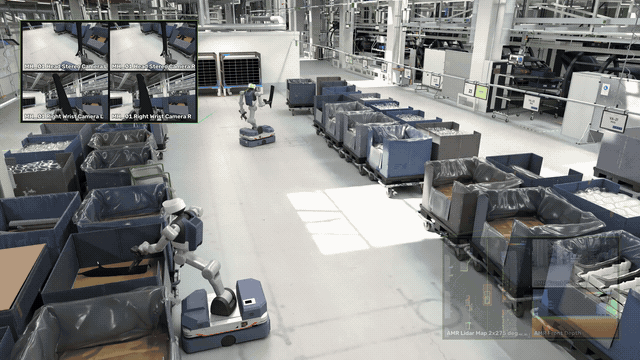
Chuỗi công cụ kỹ thuật. Omniverse cung cấp kết xuất RTX, vật lý PhysX và trình chuyển đổi CAD sang OpenUSD; Isaac Sim (xây trên Omniverse) thêm mô phỏng cảm biến (camera, LiDAR, IMU), vật lý robot và tạo dữ liệu tổng hợp; Isaac Lab dùng cho huấn luyện học tăng cường. Tài sản thiết bị theo chuẩn SimReady mang sẵn thuộc tính vật lý và kết nối để đưa thẳng vào mô phỏng.
| Công ty | Bài toán | Công cụ | Thành phần NVIDIA |
|---|---|---|---|
| Audi | Thử nghiệm ý tưởng sản xuất pin trước khi có thiết bị thật | Bản sao số dây chuyền pin | Thư viện Omniverse |
| Audi, Dassault Systèmes, Agile Robots | Mô phỏng và xác thực humanoid di động, quy trình logistics | Virtual twin trong DELMIA | Thư viện Omniverse, mô phỏng cảm biến |
| Schaeffler | Đánh giá hành vi cơ cấu chấp hành (actuator) khớp robot humanoid | Bản sao số linh kiện | Khung mô phỏng Isaac |
| Volkswagen Sachsen, Wandelbots | Xác thực quy trình lắp ráp số hóa tại Transparent Factory | Wandelbots NOVA + Isaac Sim | Omniverse, OpenUSD |
| Mercedes-Benz | Kiểm tra xe và xác minh lắp kính chắn gió | Tác tử thị giác tại nhà máy | Cosmos 3, Metropolis VSS |
Vòng lặp sim-to-real. Quy trình điển hình của các hãng trên gồm bốn bước lặp: (1) nhập CAD và bố trí dây chuyền thành cảnh OpenUSD với tài sản SimReady; (2) mô phỏng cảm biến, vật lý và chương trình robot trong Isaac Sim để sinh dữ liệu tổng hợp và kiểm tra quy trình; (3) huấn luyện hoặc tinh chỉnh mô hình (TAO, Cosmos, Isaac Lab); (4) triển khai lên robot thật và dùng dữ liệu vận hành cập nhật ngược lại bản sao số. Cosmos đóng vai trò mô hình thế giới (world model): sinh video và biến thể cảnh có tính vật lý để mở rộng dữ liệu huấn luyện vượt ra ngoài những gì có thể quay thực tế.
Tác tử có trí tuệ không gian và bản sao số hạ tầng
Mô phỏng không dừng ở dây chuyền lắp ráp: cùng cách tiếp cận OpenUSD + Omniverse được dùng cho nhà máy chế biến, cơ sở năng lượng và cả nhà máy AI.
Falkor: tác tử “nhìn thấy” cơ sở công nghiệp. Falkor, công ty thuộc KONGSBERG, tích hợp tác tử và thư viện Omniverse vào nền tảng của mình. Hạ tầng là máy ảo Microsoft Azure NCv6 chạy GPU RTX PRO 6000 Blackwell Server Edition. Tác tử kết hợp ba nguồn: dữ liệu kỹ thuật (P&ID, CAD), dữ liệu vận hành (cảm biến, lịch bảo trì) và hình học 3D thiết bị, để quan sát, mô phỏng và lập luận về toàn bộ cơ sở trong các ca kiểm tra và bảo trì ngành dầu khí, năng lượng.
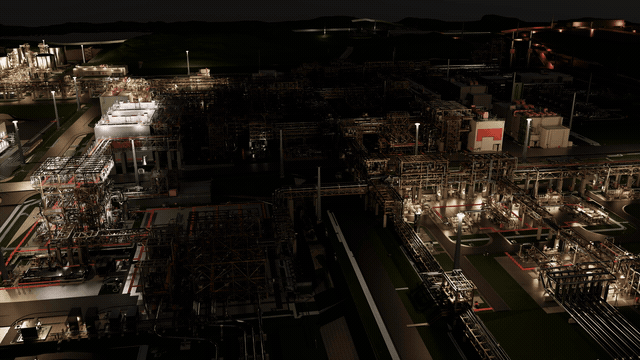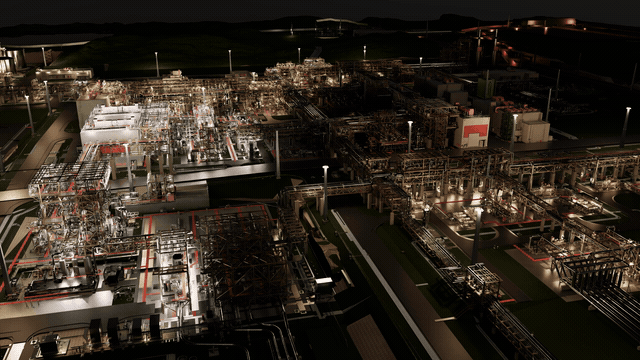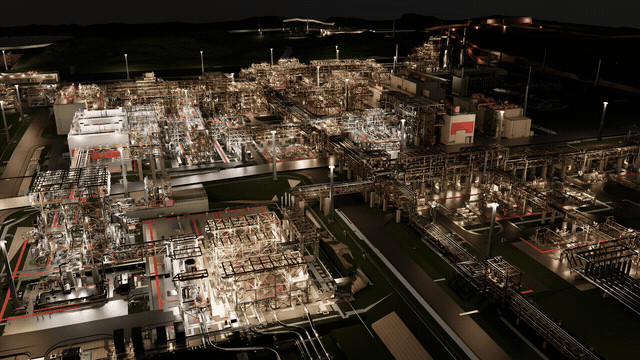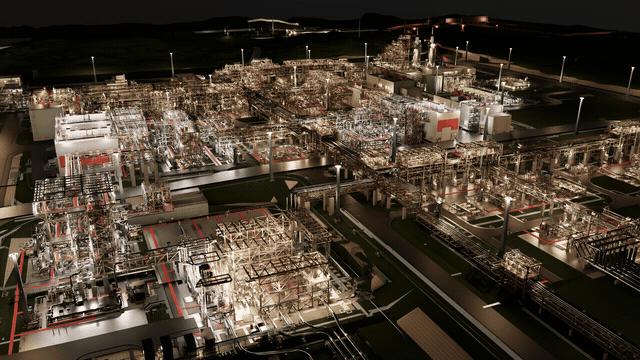
Vì sao RTX PRO 6000 Blackwell Server Edition phù hợp cho ca này: GPU có 96GB GDDR7, vừa kết xuất RTX (ray tracing, DLSS) cho cảnh OpenUSD lớn, vừa chạy suy luận VLM và LLM cho tác tử trên cùng một card, nên một máy ảo có thể vừa hiển thị bản sao số vừa phục vụ tác tử.
Bản sao số nhà máy AI. Schneider Electric cùng AVEVA phát triển bản sao số nhà máy AI cho Nscale bằng thư viện Omniverse, để kỹ sư so sánh cấu hình điện, làm mát và thiết bị trước khi thay đổi vật lý. Quy trình này đã được NTC AI phân tích chi tiết trong bài Phát triển bản sao số nhà máy AI với quy trình làm việc có sự hỗ trợ của tác tử, với kiến trúc DSX nối pipeline tài sản SimReady, dịch vụ mô phỏng và mô hình thay thế.
Bản đồ công nghệ: thư viện nào, GPU nào, ở bước nào
Ghép các ca triển khai ở trên lại, ngăn xếp NVIDIA cho công nghiệp châu Âu xếp thành bốn giai đoạn nối tiếp trên cùng một nền mô hình mở và GPU Blackwell.
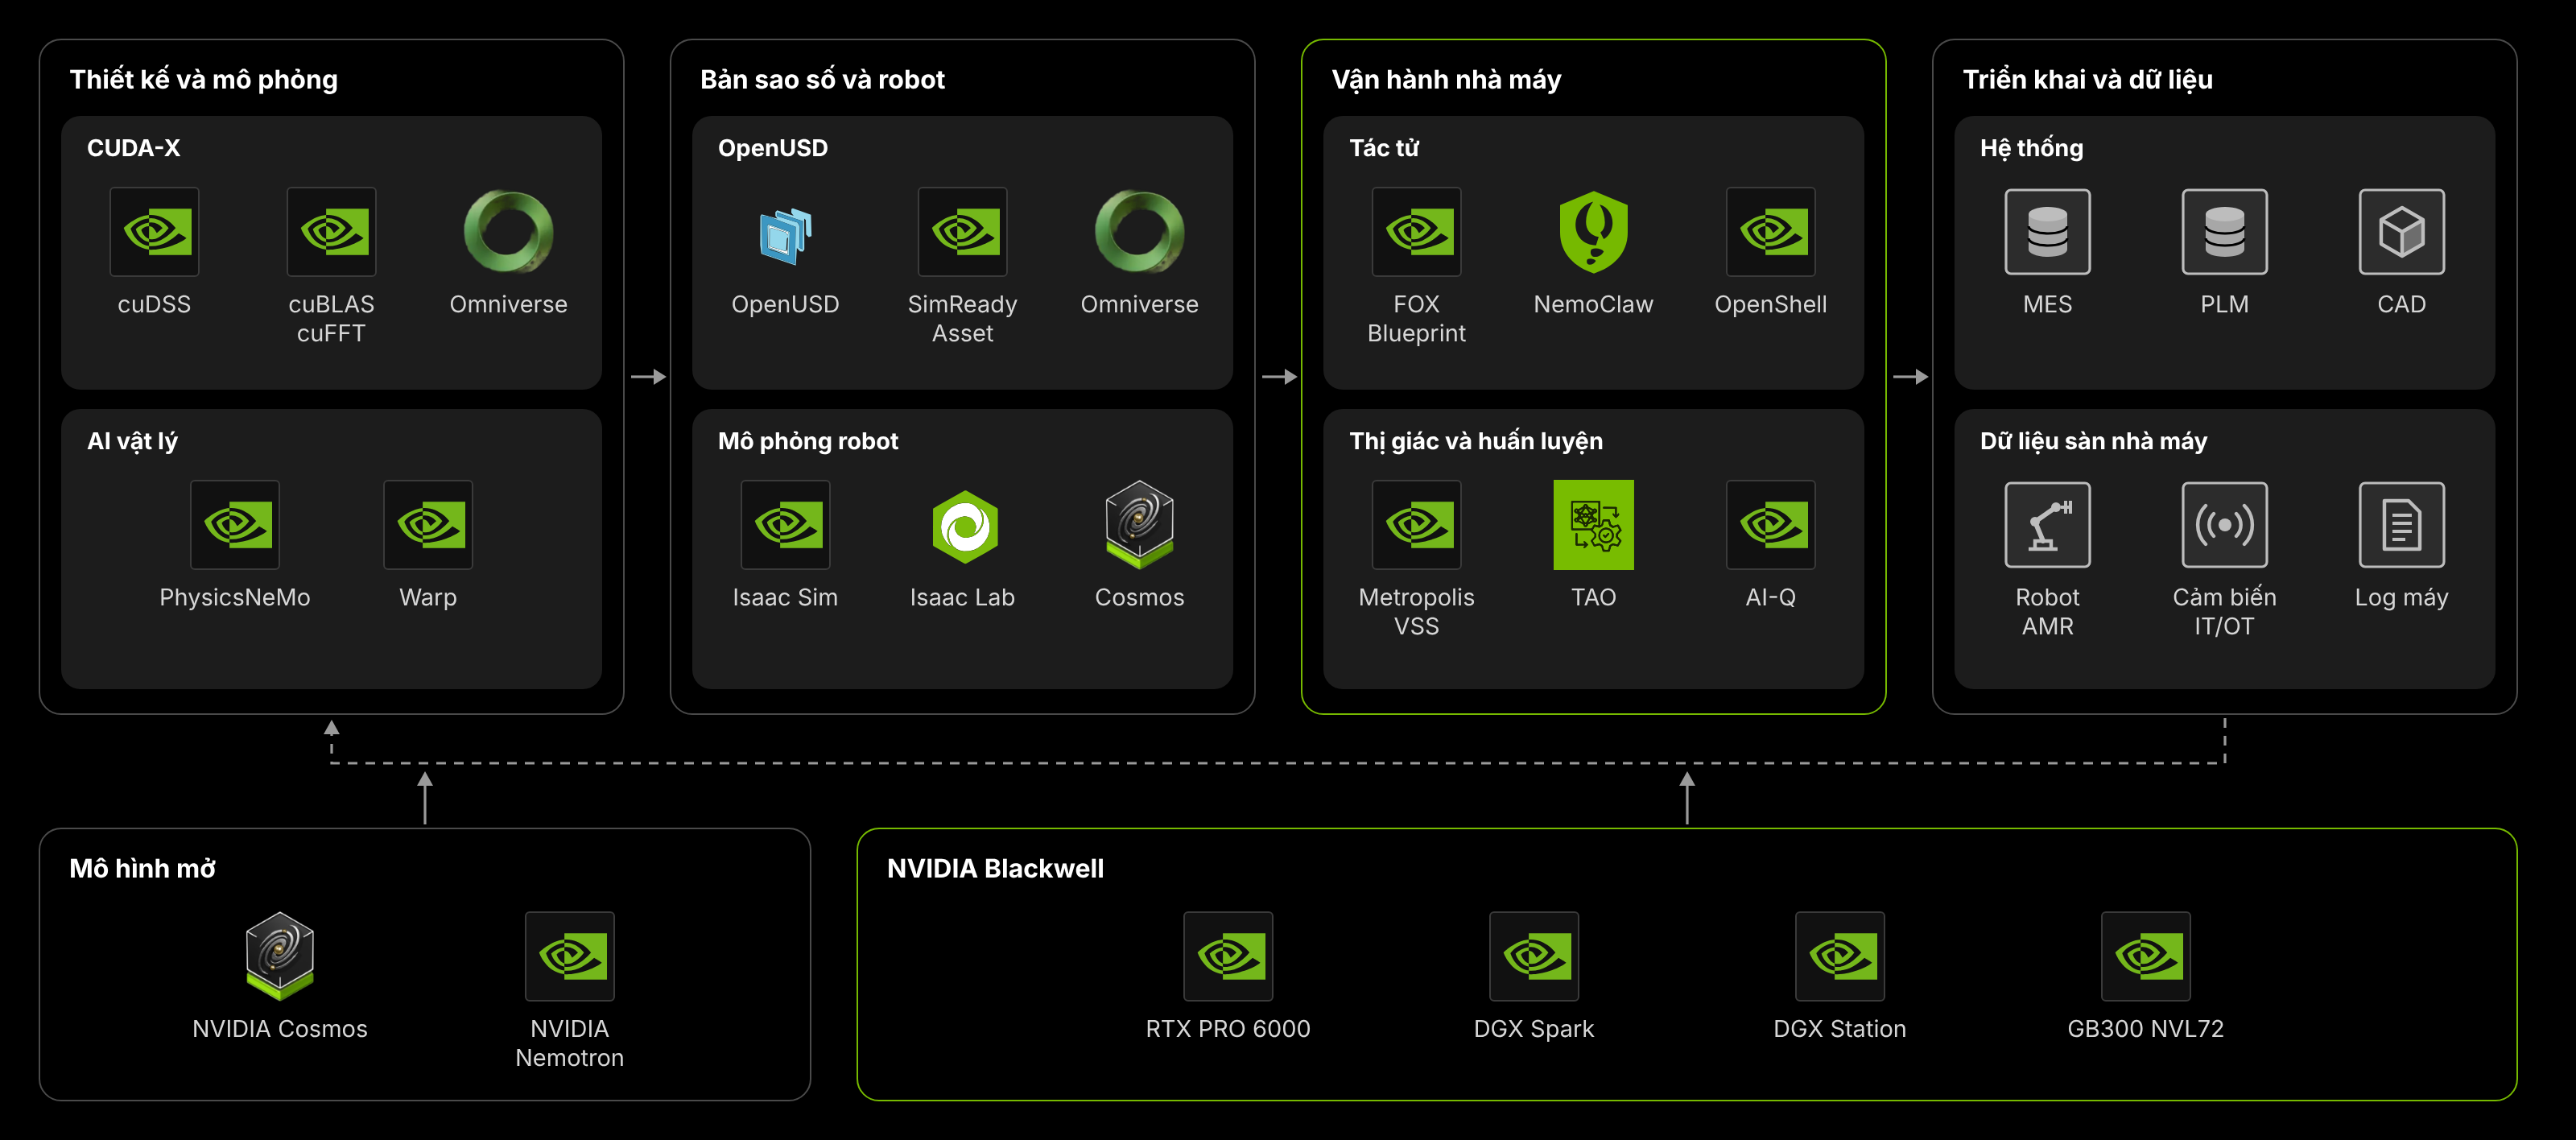
| Thư viện / mô hình | Vai trò kỹ thuật | Giai đoạn | DOANH NGHIỆP ỨNG DỤNG TIÊU BIỂU |
|---|---|---|---|
| cuDSS | Bộ giải trực tiếp hệ thưa trên GPU, C/C++/Python/Fortran, đa GPU | Thiết kế | Abaqus, Sentaurus, STAR-CCM+ |
| PhysicsNeMo | Khung huấn luyện mô hình AI vật lý (neural operator, PINN) | Thiết kế | Autodesk NavPack, Bentley |
| Warp | Kernel mô phỏng khả vi viết bằng Python, biên dịch CUDA | Thiết kế | Saab (UniversalAGI), Deltares (Fermioniq) |
| Omniverse | Kết xuất RTX, PhysX, chuyển đổi CAD, cộng tác OpenUSD | Thiết kế, bản sao số | Audi, Leonardo, PhysicsX, Falkor |
| Isaac Sim / Isaac Lab | Mô phỏng cảm biến, vật lý robot, học tăng cường | Bản sao số | Schaeffler, Wandelbots/VW |
| Cosmos | Mô hình thế giới, VLM, sinh ảnh lỗi, in-context learning | Bản sao số, vận hành | Siemens, Mercedes-Benz |
| Nemotron | LLM mở cho lập luận, gọi công cụ, tác tử | Vận hành | Dassault LEO/AURA, FOX |
| FOX + NemoClaw + AI-Q | Khung tác tử quản lý nhà máy, điều phối tác tử chuyên biệt | Vận hành | Siemens Intelligence Center X |
| Metropolis VSS | Tìm kiếm, tóm tắt và phân tích video nhà máy | Vận hành | Mercedes-Benz, Wistron |
Chọn phần cứng NVIDIA cho từng khối lượng công việc
Mỗi giai đoạn trong vòng đời trên có một cấu hình GPU phù hợp; nguyên tắc chung là tách phát triển tác tử (cần bộ nhớ lớn cho mô hình) khỏi kết xuất và mô phỏng (cần nhân RT và băng thông), rồi hợp nhất khi lên quy mô máy chủ.
| Hệ thống | Thông số chính | Khối lượng công việc phù hợp | Ví dụ |
|---|---|---|---|
| DGX Spark | GB10 Grace Blackwell, 128GB bộ nhớ hợp nhất, 1 PFLOP FP4, ghép 2 máy qua ConnectX-7 | Tạo nguyên mẫu tác tử, chạy mô hình cục bộ, kết nối công cụ kỹ thuật | Thử FOX, NemoClaw với Nemotron cỡ vừa |
| RTX PRO 6000 Blackwell Workstation Edition | 96GB GDDR7, nhân RT thế hệ 4, Tensor Core thế hệ 5 | Chuẩn bị tài sản OpenUSD, bản sao số tương tác, mô phỏng Isaac Sim, chạy cuDSS trên workstation | Audi, Schaeffler, Wandelbots |
| DGX Station | GB300 Grace Blackwell Ultra, 20 PFLOPS FP4, 748GB bộ nhớ nhất quán, NVLink-C2C | Tác tử quản lý nhà máy chạy liên tục, mô hình đến 1.000 tỷ tham số, tinh chỉnh TAO/Cosmos | Thiết kế tham chiếu của FOX |
| RTX PRO 6000 Blackwell Server Edition | 96GB GDDR7, làm mát thụ động, 8 GPU/máy chủ theo kiến trúc tham chiếu RTX PRO AI Factory | Kết xuất và suy luận đồng thời cho nhiều người dùng, tác tử không gian, VSS nhiều camera | Falkor trên Azure NCv6, DeepHow tại Foxconn |
| Cụm DGX / HGX Blackwell | GB200/GB300 NVL72 | Huấn luyện mô hình AI vật lý, cuDSS đa node cho mô phỏng cỡ lớn | Mistral, nhà máy AI của Nscale |
Thông số DGX Spark và DGX Station theo công bố của NVIDIA; cấu hình thực tế tùy OEM và phiên bản.
Cách ghép theo đội ngũ. Kỹ sư mô phỏng dùng RTX PRO 6000 Workstation với cuDSS và Omniverse; nhóm phát triển tác tử bắt đầu trên DGX Spark rồi chuyển lên DGX Station khi mô hình lớn hơn 128GB; khi nhiều phòng ban cùng truy cập bản sao số và tác tử, chuyển sang RTX PRO Server theo đơn vị bốn máy chủ (32 GPU) để mở rộng theo số người dùng đồng thời và độ phức tạp cảnh.
Lợi thế và lưu ý khi áp dụng ngăn xếp NVIDIA cho kỹ thuật – sản xuất
Lợi thế
- Một định dạng dữ liệu xuyên suốt: OpenUSD và tài sản SimReady đi từ CAD sang mô phỏng, bản sao số rồi bản sao vận hành, không phải chuyển đổi lại ở mỗi bước.
- Bộ giải sẵn trong phần mềm đang dùng: cuDSS đã nằm trong Abaqus, STAR-CCM+, Sentaurus, COMSOL, Celsius; kỹ sư không cần viết lại mã CUDA.
- Mô hình mở, chạy tại chỗ: Cosmos và Nemotron chạy trên DGX Station hoặc RTX PRO Server trong nhà máy, dữ liệu sản xuất không rời khỏi doanh nghiệp.
- Tác tử có kiểm soát: OpenShell giới hạn quyền của tác tử; FOX điều phối qua API chuẩn và agent skills thay vì tích hợp riêng từng hệ thống.
Lưu ý
- Con số hiệu năng (8–10x, 12x, 40x, tiết kiệm 20%) do NVIDIA và đối tác công bố, chưa có benchmark độc lập; mức tăng tốc phụ thuộc cấu trúc ma trận và kích cỡ bài toán.
- FOX mới ở giai đoạn truy cập sớm; API và cấu trúc kỹ năng có thể thay đổi trước khi GA.
- Hỗ trợ cuDSS tùy phiên bản phần mềm ISV; cần xác nhận bộ giải nào của sản phẩm đã bật GPU.
- Chuẩn bị tài sản SimReady (hình học, thuộc tính vật lý, kết nối) vẫn là công đoạn tốn công nhất khi bắt đầu một bản sao số.
Lời kết
Điểm chung của Siemens, Mercedes-Benz, Audi, Leonardo hay Falkor là không mua một “giải pháp AI” riêng lẻ, mà ghép thư viện CUDA-X vào bộ giải sẵn có, dựng bản sao số trên OpenUSD, rồi đặt tác tử lên lớp dữ liệu đó. Bắt đầu đúng chỗ, với bài toán có thể đo được, quan trọng hơn bắt đầu rộng.
Hãy liên hệ đội ngũ chuyên gia của Nhất Tiến Chung. Với vai trò NVIDIA Elite Partner tại Việt Nam, chúng tôi sẽ phân tích khối lượng công việc mô phỏng, bản sao số và tác tử của doanh nghiệp, tư vấn cấu hình RTX PRO, DGX Spark, DGX Station hoặc RTX PRO Server phù hợp và đồng hành triển khai hạ tầng AI công nghiệp.
Tổng đài: 1900 558879 · Email: sales@nhattienchung.vn
Nguồn
- Europe’s Industrial Leaders Reinvent Engineering and Manufacturing With NVIDIA — NVIDIA Blog, 21/10/2026
- NVIDIA cuDSS Now Generally Available to Accelerate Engineering and Scientific Simulations — NVIDIA Blog, 21/10/2026
- NVIDIA Factory Operations Blueprint Gives Factories a New AI Brain — NVIDIA Blog, 31/05/2026
- Toàn bộ công bố của NVIDIA tại GTC Berlin 2026
Bài viết liên quan
- Cách NVIDIA Mission Control 2.5 mang lại khả năng tự động phục hồi cho Kubernetes
- Phát triển Bản sao số Nhà máy AI với quy trình làm việc có sự hỗ trợ của tác tử
- Sử dụng AI Agents để dạy robot như Microduck đi bộ trong mô phỏng
- RTX Spark và PC Windows: khi AI agent về ở trên máy
- Chạy các mô hình AI Frontier-Class trên 8 nodes NVIDIA DGX Spark