Cách chúng tôi dạy robot lắp ráp khay kiểm tra GB300 và những gì chúng tôi học được về việc robot học hỏi, trí tuệ cơ học và kỹ thuật truyền thống
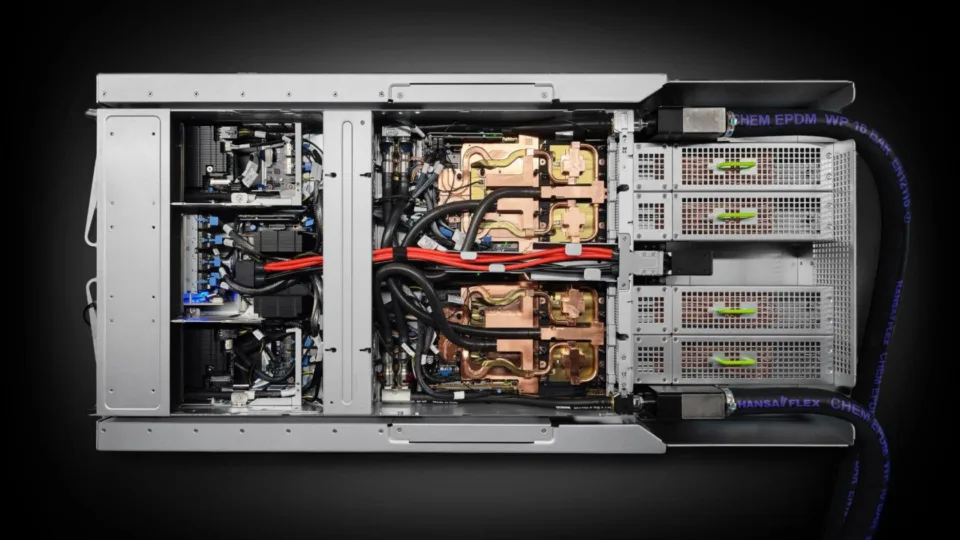
Siêu chip GB300 của NVIDIA Grace Blackwell là động cơ cho việc huấn luyện và suy luận AI của các mô hình nền tảng hiện đại. Tuy nhiên, quá trình lắp ráp khay GB300 đòi hỏi lao động vật lý có kỹ năng cao tại các nhà máy trên khắp thế giới. Phòng thí nghiệm Robot Seattle của NVIDIA (SRL), phối hợp với đội ngũ kỹ thuật NVIDIA Isaac, đã đặt ra câu hỏi trung tâm: Chúng ta có thể xây dựng các robot thông minh để lắp ráp những hệ thống phức tạp như vậy không?
Câu trả lời là có, nhưng con đường đã đầy thách thức. Cho phép robot lắp ráp các khay GB300 là một trong những vấn đề khó khăn nhất mà SRL đã giải quyết trong chín năm hoạt động với tư cách là một phòng thí nghiệm nghiên cứu có năng suất cao. Vấn đề này cũng đã thách thức những giả định của chúng tôi về việc học tập đầu-cuối (end-to-end learning) mạnh mẽ nhất ở đâu, và ở đâu một bộ chồng (stack) mô-đun có thể hiệu quả hơn.
Vấn đề hiện tại: Moravec quay lại
Chúng tôi tập trung vào việc lắp ráp các khay kiểm tra GB300, được sử dụng để xác minh chức năng và hiệu suất của các module tính toán GB300 trước khi vận chuyển và triển khai. Dựa trên các khuyến nghị từ Đội ngũ Vận hành NVIDIA và Foxconn, một nhà sản xuất theo hợp đồng của GB300, chúng tôi đã xác định hai nhiệm vụ quan trọng: (1) lắp ráp thanh dẫn điện (busbar) và (2) chèn nhiều đầu nối.
Trong lắp ráp thanh dẫn điện, một thanh dẫn điện dài và nặng (tức là một thanh kim loại truyền dòng điện cao) phải được cầm nắm, vận chuyển đến khay, chèn vào và vặn chặt tại 16 vị trí. Các jig và kẹp cũng phải được chèn vào và tháo ra. Trong chèn nhiều đầu nối, hai đầu nối điện lớn và hai đầu nối nhỏ được gắn trên cáp phải được nhấc lên từ khay và chèn vào các ổ cắm có khe hở hẹp.
Bố trí thực nghiệm thực tế được hiển thị bên dưới.
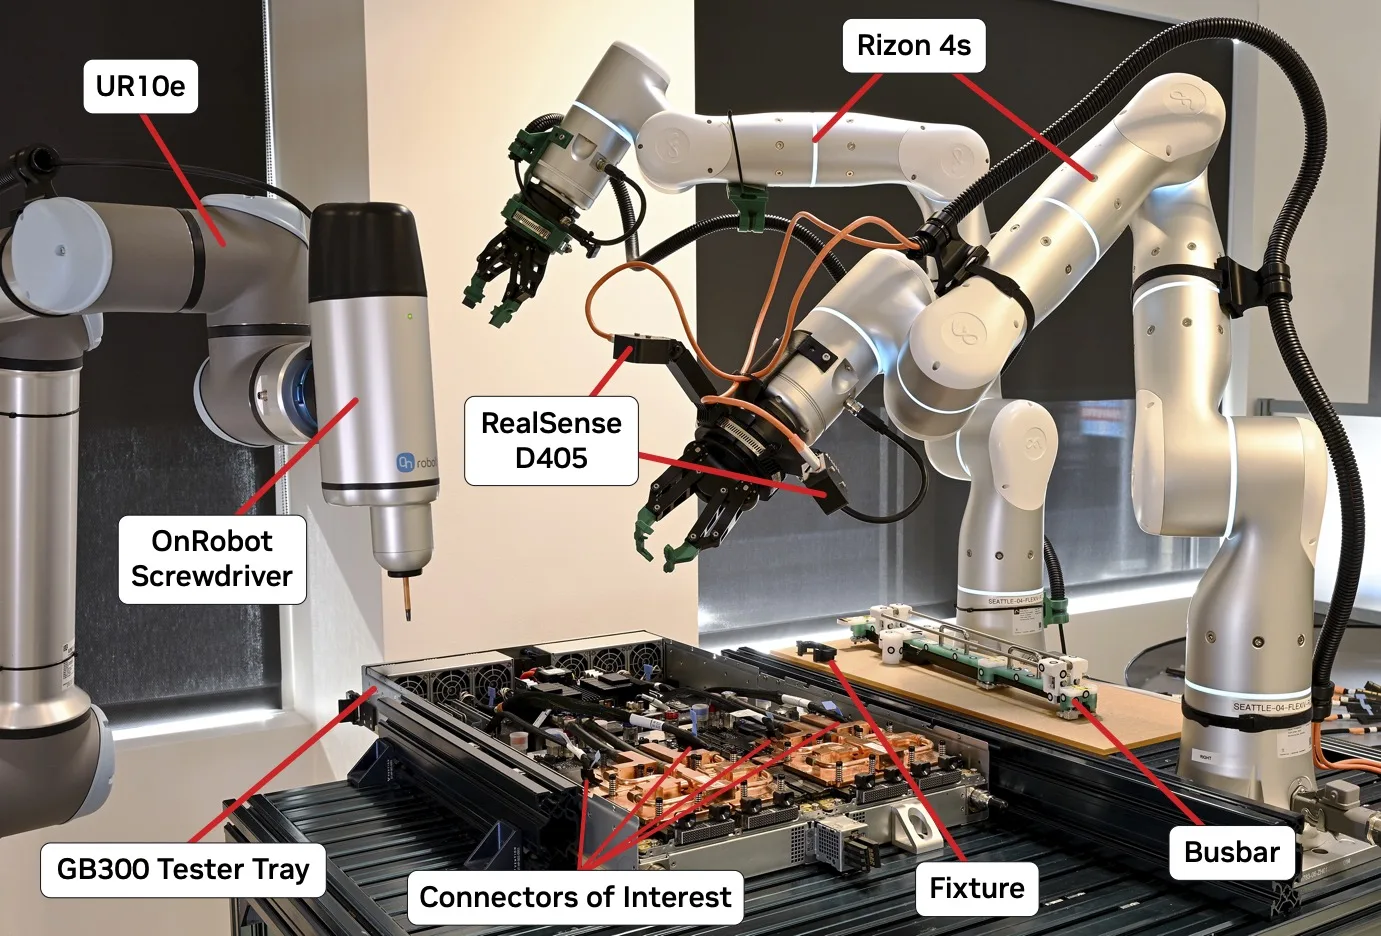 Hình 1. Góc nhìn phía trước của bố trí thực nghiệm thực tế. Các robot bao gồm hai cánh tay Flexiv Rizon 4S và một cánh tay UR10e với tua vít OnRobot
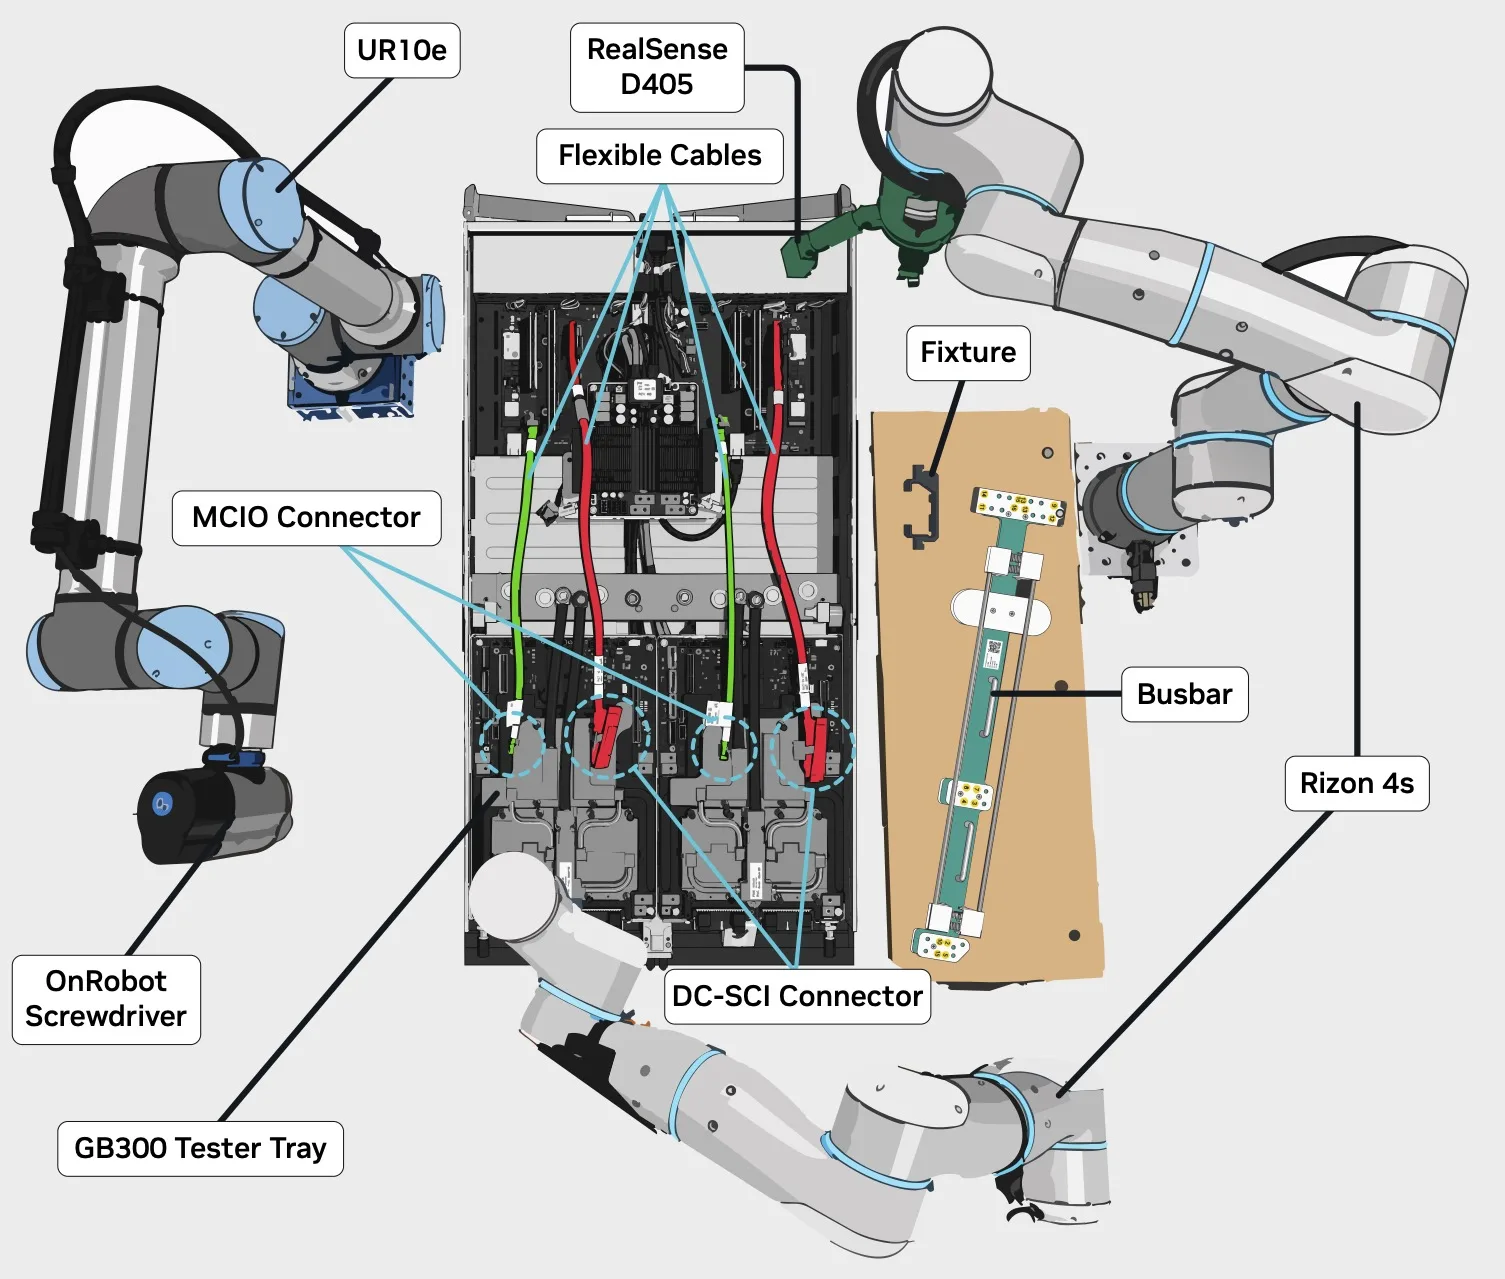 Hình 2. Góc nhìn từ trên xuống của bố trí thí nghiệm thực tế
Các công nhân nhà máy lành nghề thực hiện hai nhiệm vụ này một cách đáng tin cậy và trôi chảy, không cần nỗ lực tinh thần đáng kể. Tuy nhiên, trong một ví dụ khác về nghịch lý Moravec, sự khéo léo cần thiết cho các nhiệm vụ như vậy có thể đặc biệt khó để tự động hóa.
Thách thức chính đầu tiên là sự không chắc chắn. Hình học, ngoại hình và động lực học của các bộ phận không được biết chính xác, và tư thế ban đầu của các bộ phận có thể thay đổi đáng kể. Ngoài ra, các đầu nối điện được gắn vào các cáp bị biến dạng dọc theo toàn bộ chiều dài, có sự biến đổi đáng kể trong quá trình sản xuất và thậm chí còn thay đổi về mặt cơ học thông qua biến dạng dẻo và mỏi.
Trong nhiều hoạt động sản xuất, sự không chắc chắn được giảm thiểu thông qua tự động hóa cố định, trong đó môi trường được kiểm soát cẩn thận. Các giá đỡ và bộ chuyển đổi được thiết kế để ràng buộc các bộ phận với độ chính xác dưới milimét, và robot có thể hoạt động như các máy chuyển động lặp lại. Trong quá trình lắp ráp khay kiểm tra GB300, sự không chắc chắn phải được xử lý thông qua tự động hóa linh hoạt, vì các chu kỳ thiết kế nhanh và số lượng thấp khiến tự động hóa cố định không khả thi. Robot phải có khả năng thích ứng và bền vững với sự không chắc chắn một cách vốn có. Với nhu cầu ngày càng tăng về cơ sở hạ tầng AI, mô hình này là một ưu tiên chiến lược đối với NVIDIA.
Thách thức chính thứ hai là hiệu suất. Trong nghiên cứu robot, tỷ lệ thành công 50%-60% thường là đủ, và tỷ lệ thành công 80%-90% có thể đủ để coi một tác vụ là đã được giải quyết. Thời gian chu kỳ, độ mượt của chuyển động và thao tác nhẹ nhàng thường là thứ yếu. Ngoài ra, độ nghiêm ngặt thống kê thường không đủ; mỗi tác vụ thường chỉ thực hiện 10 đến 20 lần thử nghiệm, trong khi các khoảng tin cậy hợp lý có thể cần nhiều đánh giá hơn rất nhiều.
Yêu cầu hiệu suất của chúng tôi được xác định thông qua hợp tác trực tiếp với Đội ngũ Vận hành NVIDIA và Foxconn để đảm bảo rằng đã được giải quyết thực sự có nghĩa là đã được giải quyết. Tính đến ngày công bố bài viết này, chúng tôi đang nhanh chóng tiến gần đến các ngưỡng của họ.
Chiến lược kỹ thuật: Công cụ phù hợp vào thời điểm phù hợp
Trong nghiên cứu robot, sự mới lạ về mặt kỹ thuật được coi trọng; truyền thống này thúc đẩy phát minh nhưng tạo ra ít động lực để tối ưu hóa các phương pháp cơ sở có thể đạt hiệu suất cao hơn. Kết quả là, có thể dễ dàng rời khỏi một bài báo nghiên cứu mà không hiểu tại sao các cách tiếp cận trước đó không hiệu quả.
Chiến lược của chúng tôi cho việc lắp ráp khay kiểm tra GB300 là công cụ đúng vào thời điểm đúng. Đối với từng vấn đề con, chúng tôi đã xem xét (và thường triển khai) các phương pháp cơ sở cổ điển trước. Khi chúng không đạt yêu cầu, chúng tôi đã khám phá học mô phỏng, học tăng cường dựa trên mô phỏng (RL) với chuyển đổi từ mô phỏng sang thực tế, RL trong thế giới thực và các mô hình thị giác-ngôn ngữ-hành động (VLA). Sự tiến triển này cho phép chúng tôi xác định điểm mạnh và điểm yếu của từng cách tiếp cận và biện minh cho sự đổi mới và độ phức tạp.
Chúng tôi hiện thảo luận chi tiết về lắp ráp thanh dẫn và chèn nhiều đầu nối; chúng tôi hướng đến việc các tác vụ này đóng vai trò là các nghiên cứu điển hình cho các nhóm nghiên cứu và kỹ thuật khác đang giải quyết các vấn đề thao tác thực tế của riêng họ.
Lắp ráp thanh dẫn: Nhìn lại những kinh điển
Lắp ráp thanh ray bao gồm các bước sau:
- Nắm và chèn một dụng cụ giới hạn (tức là một dụng cụ cụ thể được sử dụng để hỗ trợ lắp ráp) vào khay
- Nắm thanh busbar (có kẹp gắn kèm) và chèn vào khay
- Vặn 16 ốc vít để cố định thanh busbar vào khay
- Thả và tháo kẹp gắn trên thanh dẫn điện
- Tháo giá đỡ giới hạn
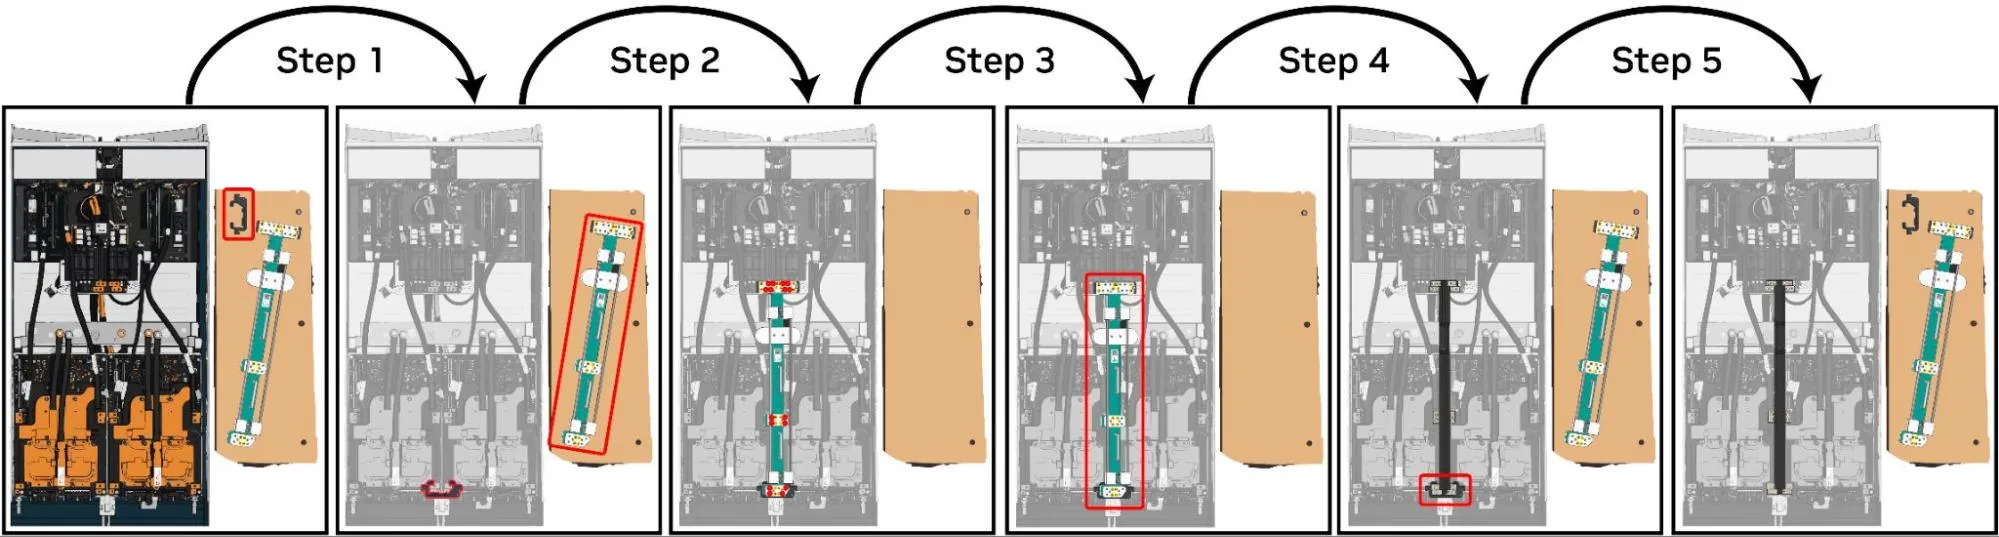 Hình 3. Năm bước con của quá trình lắp ráp thanh ray. Các bộ phận chính ở mỗi bước được khoanh bằng khung màu đỏ
Điều kiện ban đầu của chúng tôi phù hợp với bối cảnh sản xuất. Giá đỡ giới hạn và thanh ray (kèm kẹp) ban đầu được đặt ở các vị trí không bị ràng buộc trên một bề mặt phẳng cạnh robot, và các vít ban đầu nằm trong thanh ray.
Các nhà sản xuất yêu cầu chúng tôi đạt tỷ lệ thành công 99,5% và hoàn thành công việc trong thời gian không quá gấp đôi thời gian của công nhân lành nghề (trong trường hợp này, không quá 124 giây). Không được phép xảy ra va chạm ngoài ý muốn với khay, vì ngay cả hư hại nhỏ cũng có thể là lý do để loại bỏ toàn bộ hệ thống.
Chúng tôi bắt đầu công việc bằng cách triển khai một quy trình cổ điển (“kỹ thuật kiểu cũ“) bao gồm các module nhận thức, lập kế hoạch và điều khiển riêng biệt, với kỳ vọng sẽ chuyển sang học tập đầu-cuối sau đó. Tuy nhiên, quy trình cổ điển lại rất hiệu quả và không cần phải chuyển đổi. Cấu trúc module của giải pháp của chúng tôi cũng giúp hệ thống dễ dàng gỡ lỗi và tinh chỉnh, cũng như phân phối trên các cánh tay robot.
Đối với nhận thức, ban đầu chúng tôi sử dụng NVIDIA FoundationPose, một mô hình tổng quát ước tính tư thế 6D của một đối tượng từ lưới (mesh), một hình ảnh RGB và một hình ảnh độ sâu. Tuy nhiên, khi một đối tượng không được nhìn thấy đủ rõ, các ước tính có thể sai lệch 90 hoặc 180 độ. Do đó, chúng tôi đã mở rộng quy trình để tiếp nhận nhiều góc nhìn, tạo ra một ước tính cho mỗi góc nhìn và chọn ước tính có điểm tin cậy cao hơn, điều này giúp giảm thiểu sai sót. (Lưu ý: Sau đó, chúng tôi đã chuyển sang một mô hình chuyên biệt có tên là DOPER, được mô tả ở phần sau.)
Đối với lập kế hoạch, chúng tôi đã sử dụng một bộ lập kế hoạch điểm cách (waypoint) nhanh trong không gian tự do để giảm thời gian chu kỳ, cũng như các nguyên thủy thao tác dựa trên đường cong Lissajous và các đường đi đơn giản khác để căn chỉnh các bộ phận có thể bị lệch ban đầu.
Để kiểm soát, chúng tôi đã triển khai một bộ điều khiển trở kháng hiệu suất cao nhằm đảm bảo tiếp xúc nhẹ nhàng và ổn định trong khi vẫn áp dụng lực đủ mạnh trong quá trình chèn. Trong khi các quy trình học tập hiện đại thường triển khai các bộ điều khiển đơn giản nhất có thể, giải pháp của chúng tôi tận dụng thiết kế giảm chấn tự động và bù quán tính. Chúng tôi coi điều khiển hiệu suất cao là một công cụ mạnh mẽ nhưng chưa được khai thác đầy đủ trong lĩnh vực học máy robot.
Để giảm thời gian chu kỳ, chúng tôi đã chia công việc giữa ba cánh tay robot. Một cánh tay Flexiv Rizon 4S định vị một camera để ước tính tư thế; một cánh tay Flexiv Rizon 4S thứ hai chèn vào bộ cố định giới hạn và thanh dẫn điện, sau đó tháo ra kẹp thanh dẫn điện và bộ cố định; và một cánh tay Universal Robots UR10e sử dụng Tua vít OnRobot cho 16 thao tác vặn vít. Theo thỏa thuận với nhà sản xuất, kẹp thanh dẫn điện đã được sửa đổi nhẹ để một cánh tay duy nhất có thể mở khóa nó.
Giải pháp lắp ráp thanh ray (busbar) của chúng tôi đạt tỷ lệ thành công trên 95%, và chúng tôi đang tích cực đẩy tỷ lệ này lên cao hơn. Các lỗi còn lại chủ yếu đến từ sai sót khi cầm nắm và trượt trong tay trong quá trình chèn. Các nhiệm vụ con của bộ cố định giới hạn và thanh ray đáp ứng yêu cầu về thời gian chu kỳ; tuy nhiên, thao tác vặn vít không đạt, khiến thời gian chu kỳ đầy đủ là 160 giây so với mục tiêu 124 giây. Các thao tác vặn vít tuần tự, đặc thù theo thiết bị là nút thắt chính, để lại con đường tối ưu hóa rõ ràng.
Đoạn chuyển tiếp 1: Hiệu quả phi lý của hạ tầng
Đối với các vấn đề thách thức như lắp ráp thanh dẫn điện, hạ tầng robot thực tế được thiết kế tốt đã cho phép chúng tôi phát triển, triển khai và kiểm tra hệ thống của mình một cách nhanh chóng.
Thành phần hạ tầng quan trọng đầu tiên là dịch vụ robot. Như các nhà nghiên cứu robot biết, việc thử nghiệm với nhiều thư viện thường dẫn đến địa ngục phụ thuộc. Chúng tôi chuyển đổi các thư viện thành các dịch vụ web có thể triển khai độc lập, chạy trên biên, tại chỗ hoặc trên đám mây. Các dịch vụ được đóng gói dưới dạng container Docker với các điểm cuối FastAPI/HTTP; các nhà nghiên cứu có thể sử dụng một client Python nhẹ để kết hợp các dịch vụ từ các ngôn ngữ và framework khác nhau. Chúng tôi sử dụng dịch vụ cuRobo cho lập kế hoạch chuyển động, dịch vụ FoundationPose cho ước lượng tư thế, và dịch vụ FoundationStereo cho ước lượng độ sâu, cùng với nhiều dịch vụ khác.
Hạ tầng quan trọng thứ hai là Hệ thống Điều phối Vòng đời Nhiệm vụ và Tác nhân (TALOS). TALOS sử dụng ros2_control làm xương sống và cung cấp các bộ lập kế hoạch chuyển động, các nguyên thủy thao tác, và các bộ điều khiển hiệu năng cao (trở kháng, dẫn suất và lực). Thư viện này có thể sắp xếp liền mạch các thành phần này cùng với các chính sách đã học, cũng như thực thi các bộ điều khiển trong các vòng lặp thời gian thực nhanh hơn 500 Hz. TALOS hỗ trợ Franka FR3, Flexiv Rizon 4S, Universal Robots UR10e và SO-101. Chúng tôi sử dụng thư viện này cho tất cả các ứng dụng robot thực tế của mình, bao gồm dạy bằng cảm giác vận động, điều khiển từ xa, phối hợp hai tay và lập kế hoạch chuyển động.
TALOS cũng được tiếp cận thông qua các giao diện web tiêu chuẩn. Do đó, các tác nhân lập trình có thể truy cập các dịch vụ robot và robot vật lý, cho phép các tác nhân kết hợp các khả năng nhận thức, lập kế hoạch và điều khiển trong cả quá trình phát triển và triển khai. Quan điểm của chúng tôi phù hợp với Tiêu chuẩn Phần cứng Mô hình (MHS) của Anthropic, một quy định không phụ thuộc mô hình để làm cho các thiết bị vật lý có thể được phát hiện và vận hành an toàn bởi các tác nhân AI, và dự án mã nguồn mở DROID+ của chúng tôi là minh chứng cho cách tiếp cận này.
Được hỗ trợ bởi cơ sở hạ tầng robot của chúng tôi và tiến bộ trong lắp ráp thanh ray, chúng tôi đã tiến hành nhiệm vụ quan trọng thứ hai: chèn nhiều đầu nối.
Chèn nhiều đầu nối: ‘Bài học đắng cay ngược’
Chèn nhiều đầu nối có thể được phân rã thành các bước sau. Đối với mỗi đầu nối điện (2 lớn và 2 nhỏ):
- Nắm dây cáp để nâng kết nối điện khỏi bo mạch
- Nắm kết nối ở đầu dây cáp
- Cắm đầu nối vào ổ cắm tương ứng trên bo mạch
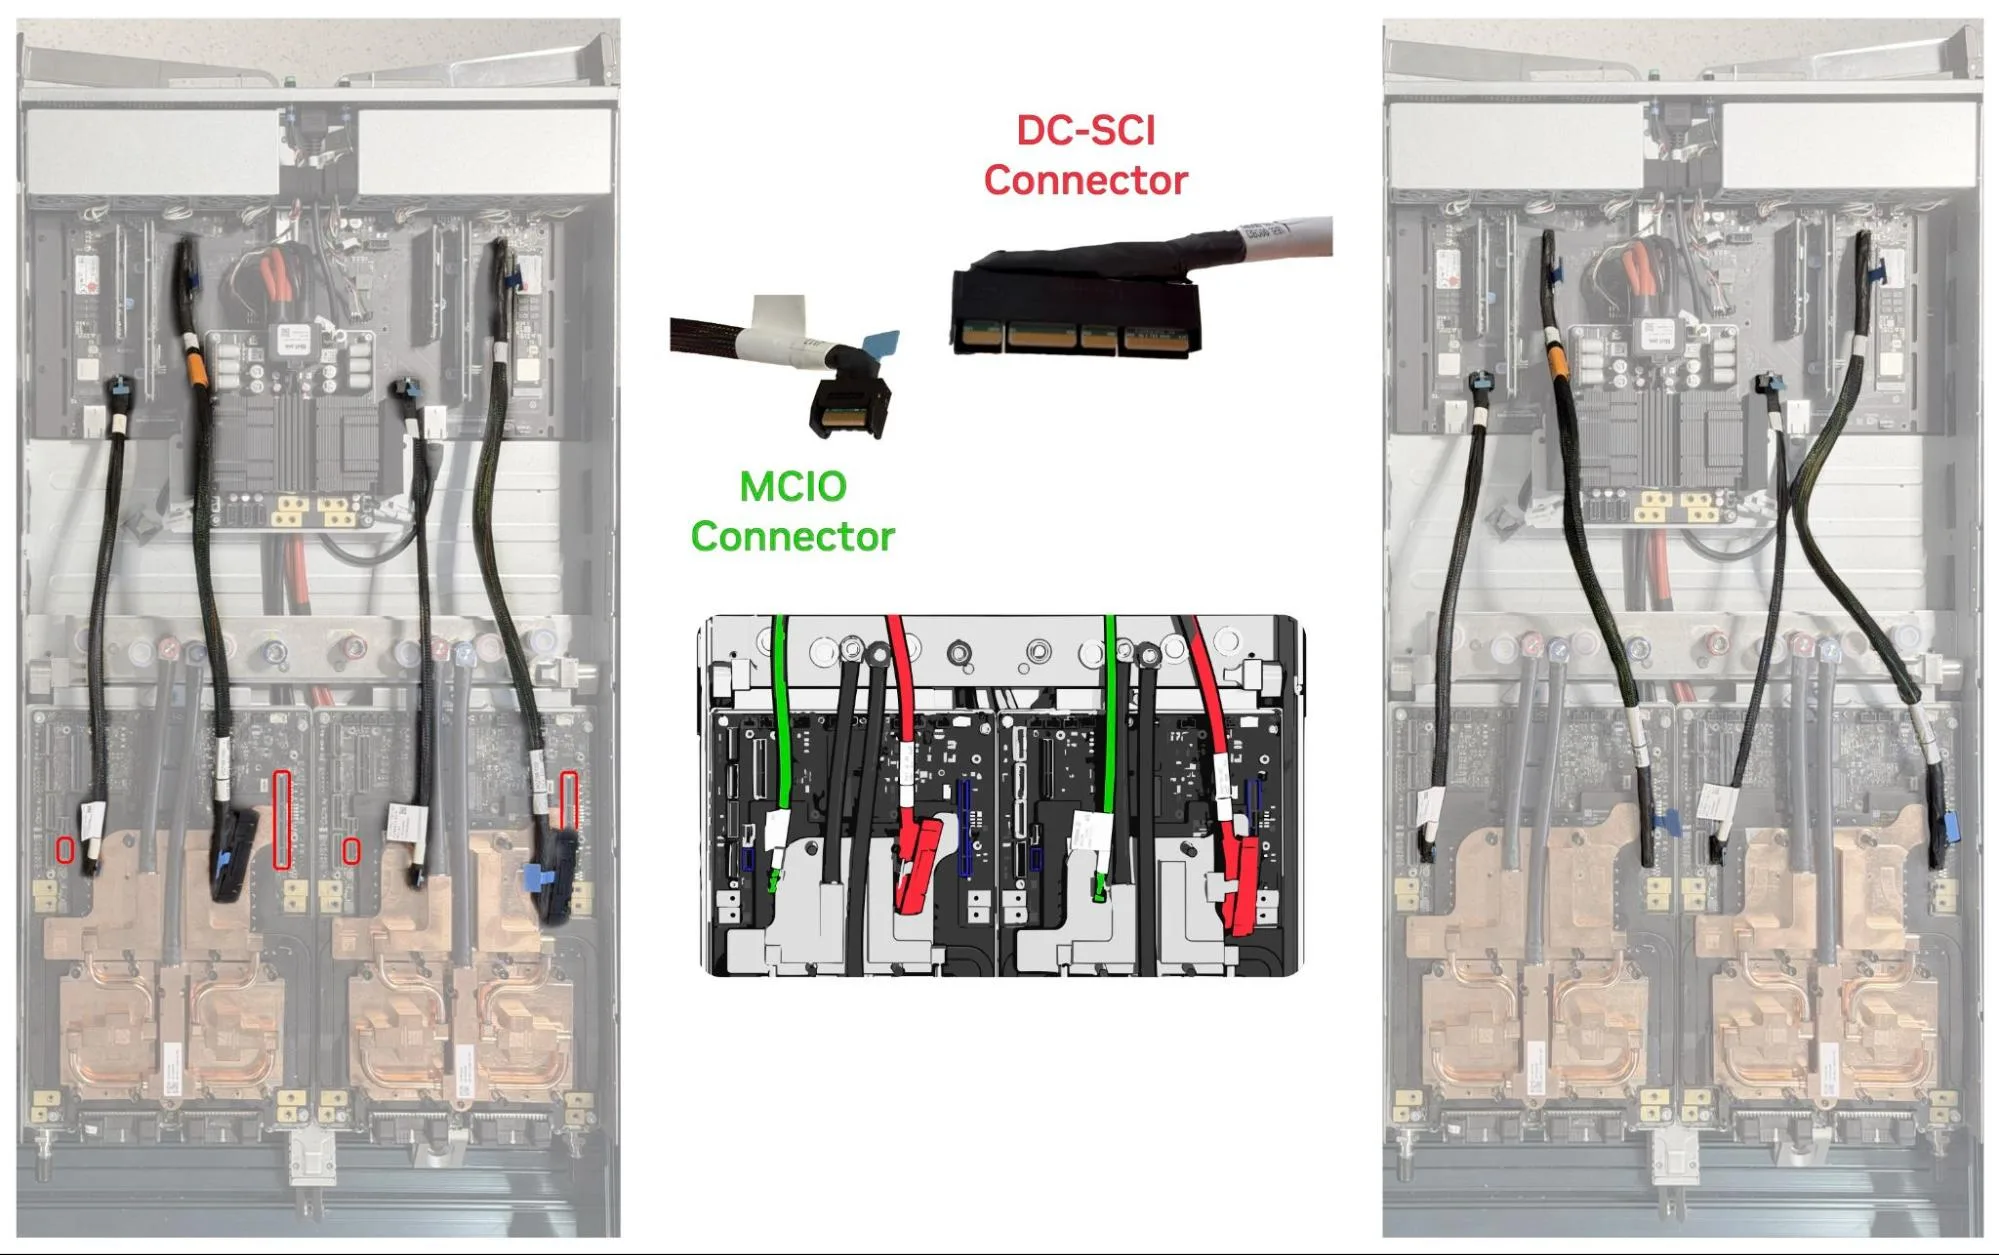 Hình 4. Điều kiện ban đầu, các loại đầu nối và trạng thái cuối cùng cho việc chèn nhiều đầu nối. Các ổ cắm đích được khoanh tròn bằng màu đỏ ở bên trái; các đầu nối MCIO được tô sáng bằng màu xanh lá cây, các đầu nối DC-SCI bằng màu đỏ
Điều kiện ban đầu của chúng tôi một lần nữa phù hợp với bối cảnh sản xuất. Cả bốn cáp đều được kết nối vào bo mạch GB300 ở một đầu, các cáp không bị rối nặng và các đầu nối gắn trên cáp có thể được đặt tùy ý trên bo mạch.
Các nhà sản xuất một lần nữa yêu cầu chúng tôi đạt tỷ lệ thành công ít nhất 99,5% và hoàn thành nhiệm vụ chèn nhiều đầu nối trong thời gian không quá gấp đôi thời gian của công nhân lành nghề (trong trường hợp này, không quá 72 giây cho cả bốn cáp). Như trước đây, không được phép có bất kỳ va chạm không chủ ý nào với khay.
Mặc dù việc mô tả nhiệm vụ là đơn giản, nhưng việc thực hiện chèn nhiều đầu nối lại vô cùng thách thức do ba yếu tố: (1) các cáp không đều, có thể biến dạng dẻo và dễ bị mài mòn, (2) các đầu nối nhỏ và gần như không có kết cấu, và (3) các đầu nối và ổ cắm của chúng có khoảng hở chặt chẽ với ít biên độ sai số.
Chúng tôi bắt đầu bằng việc triển khai lại một đường ống cổ điển. Để nắm bắt mỗi cáp, chúng tôi sử dụng Mô hình Phân đoạn Bất kỳ (SAM3) để phân đoạn các cáp trong một vùng được định nghĩa trước của hình ảnh RGB từ trên cao. Chúng tôi khớp một đường trung tâm với mỗi mặt nạ, ra lệnh cho robot nắm giữ điểm giữa của nó ở một độ cao được chỉ định, và ra lệnh cho robot di chuyển lên trên để lộ ra đầu nối.
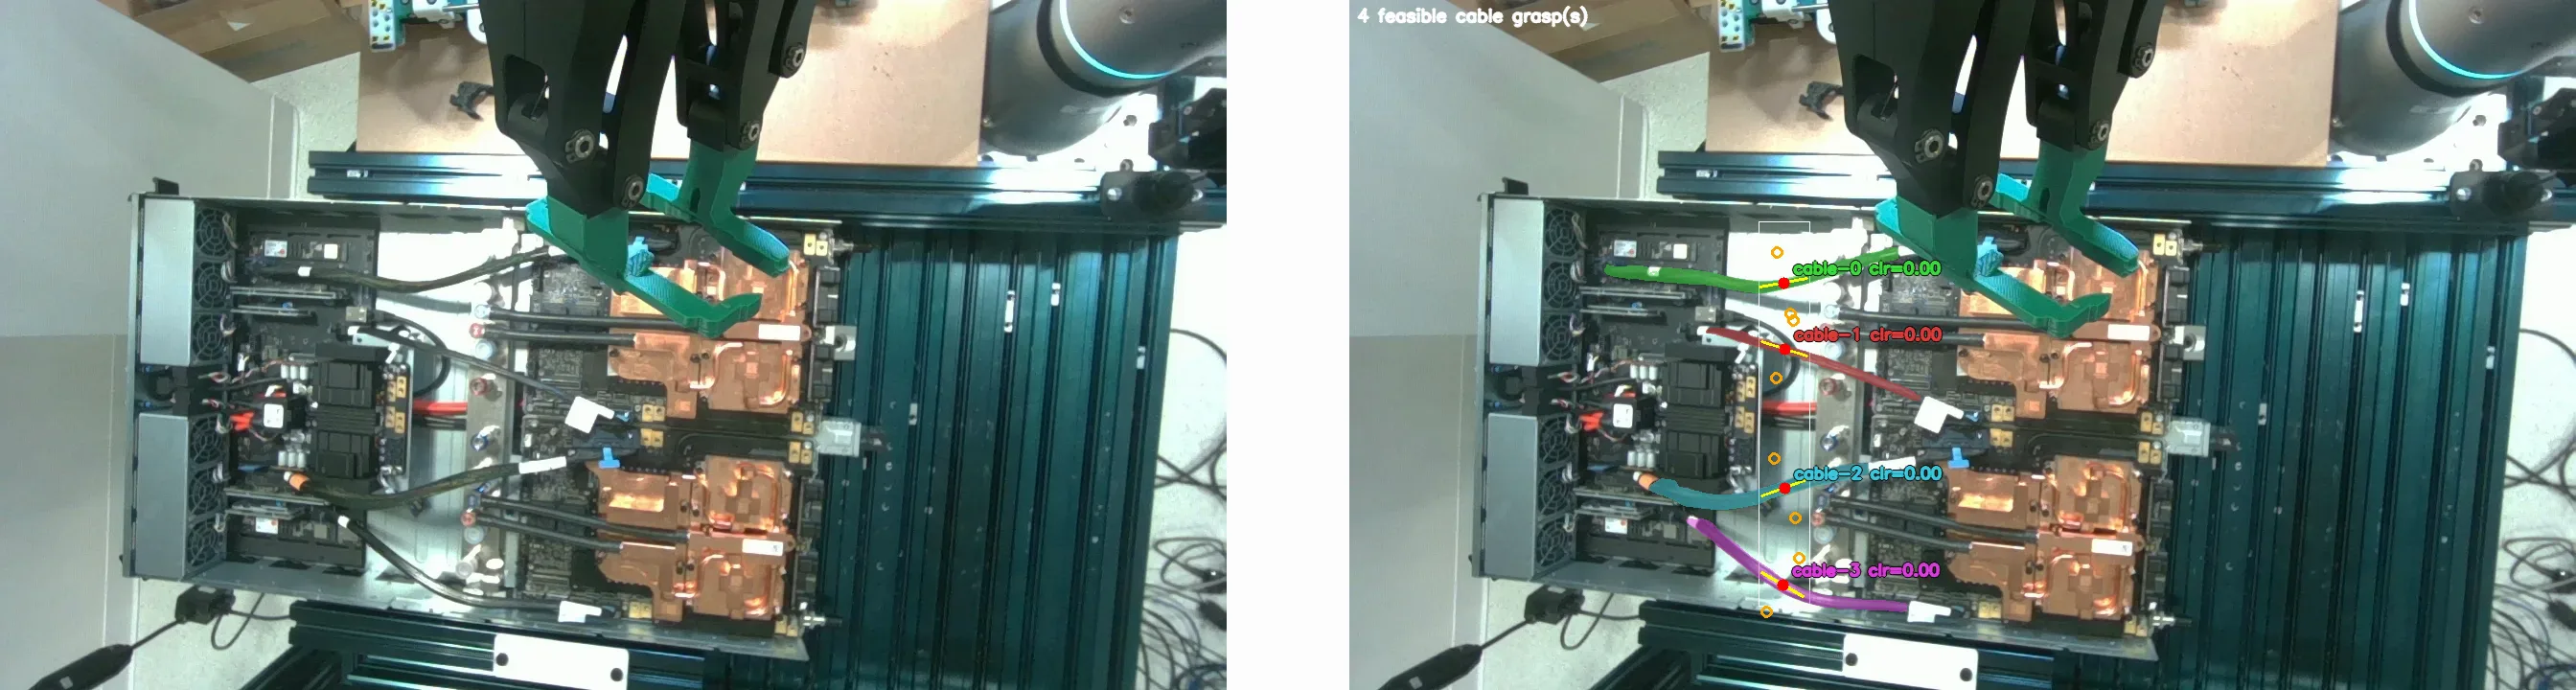 Hình 5. [Bên trái] Ảnh mẫu từ camera RealSense D405 gắn trên cổ tay. [Bên phải] Các phân đoạn SAM3 và các đường tâm cáp được trích xuất
Cách tiếp cận đơn giản này hầu như không ghi nhận sự cố nào.
Việc nắm các đầu nối lộ ra ngoài khó khăn hơn nhiều. Ước lượng tư thế bằng một mô hình tổng quát không hiệu quả; kích thước nhỏ, bề mặt không có kết cấu và các vùng gắn kết thay đổi của đầu nối với cáp đã gây ra sai số lớn. Do đó, lập kế hoạch chuyển động và nắm không đáng tin cậy. Vì vậy, chúng tôi đã chuyển sang học nhận thức, chuyển động và nắm một cách end-to-end.
Con đường này cũng là một ngõ cụt. Mô phỏng hành vi (behavior cloning) sử dụng các transformer chia nhỏ hành động (ACT) hoặc chính sách khuếch tán (diffusion policies) đạt được tỷ lệ thành công thấp; các phương pháp này được hưởng lợi từ dữ liệu chất lượng cao ở quy mô lớn, điều mà chúng tôi gặp khó khăn trong việc thu thập. Hình dạng và độ cứng của cáp thay đổi đáng kể giữa các mẫu, và chỉ có một số lượng nhỏ các loại cáp chuyên dụng này được cung cấp. Mỗi sợi cáp chỉ có thể được nắm và thao tác một số lần giới hạn trước khi bị biến dạng vĩnh viễn, điều này không còn đại diện cho các điều kiện triển khai thực tế.
Chúng tôi xem tình huống này là một “bài học đắng cay ngược” (inverse bitter lesson): trong một số tình huống thực tế, quy mô có thể trở nên không thể xử lý được do các hiện tượng vật lý, tài chính và hậu cần. Các phương pháp cổ điển tận dụng kiến thức chuyên ngành và yêu cầu ít dữ liệu tương tác hơn trở nên đáng được nghiên cứu lại.
Chúng tôi quay lại với ước lượng tư thế, nhưng với một bộ yêu cầu khác: chuyên biệt hóa cho các phần quan tâm, tránh phụ thuộc vào kết cấu thị giác chính xác hoặc đặc trưng, và cải thiện nhanh chóng bằng dữ liệu thực tế. Cùng với các đồng nghiệp tại NVIDIA Research, chúng tôi đã phát triển một khung nhận thức có tên là Deep Object Pose Estimation Revisited (DOPER). DOPER được lấy cảm hứng từ NVIDIA Deep Object Pose Estimation (DOPE), một trong những bài báo đầu tiên nghiên cứu việc sử dụng dữ liệu tổng hợp quy mô lớn để hỗ trợ nhận thức trong thế giới thực.
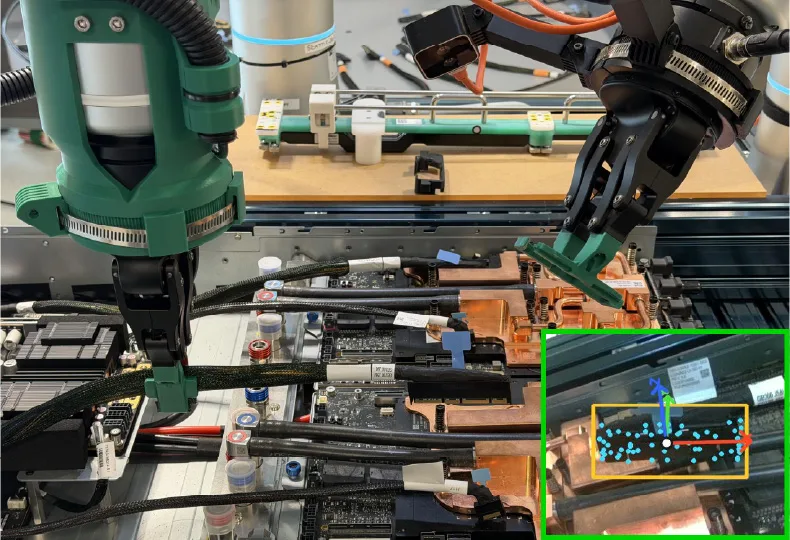
Hình 6. Một đầu nối bị lộ ra sau khi cáp của nó được nắm và nâng lên. [Ảnh chèn] Góc nhìn từ camera RealSense D405 gắn trên cổ tay. Hộp bao, các điểm chính và tư thế 6D của đầu nối từ DOPER được chú thích
Trong mô phỏng, một mô hình DOPER trước tiên được huấn luyện bằng cách nạp một mô hình CAD của một bộ phận cụ thể, render các hình ảnh RGB từ nhiều góc nhìn khác nhau và tự động tạo nhãn điểm chính (keypoint) thông qua lấy mẫu điểm xa nhất (farthest-point sampling) trên bao lồi (convex hull) của bộ phận, được lọc theo độ hiển thị và độ nổi bật (saliency) của các điểm. Sau đó, một mạng nơ-ron tích chập (convolutional network) nhanh và nhẹ được huấn luyện để dự đoán các hộp bao (bounding boxes), mặt nạ phân đoạn (segmentation masks) và các nhãn điểm chính từ các hình ảnh RGB.
Trong thế giới thực, một khôi phục hình học 3D bằng nơ-ron của bộ phận được thu thập. Mô hình DOPER đã được huấn luyện trước được thực thi trên các góc nhìn khác nhau của bản khôi phục nơ-ron với nền ngẫu nhiên, tạo ra các nhãn giả (pseudolabels); các dự đoán có độ tin cậy thấp được hiệu chỉnh bằng cách chiếu các dự đoán có độ tin cậy cao vào góc nhìn quan tâm.
Mô hình DOPER sau đó được tinh chỉnh trên các nhãn này. Cuối cùng, khi suy luận, mô hình DOPER được thực thi trong cảnh quan tâm và một ước lượng tư thế được trích xuất từ các điểm chính được dự đoán. Quy trình này có thể được thực thi với tốc độ camera là 30 Hz hoặc nhanh hơn.
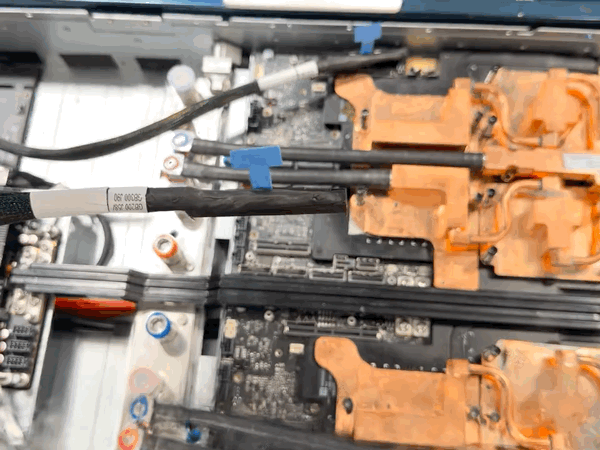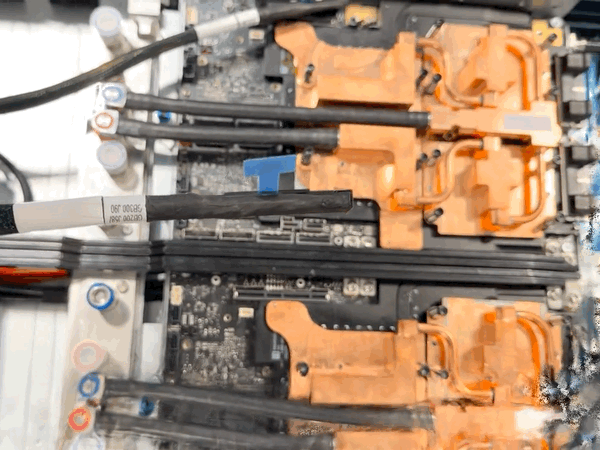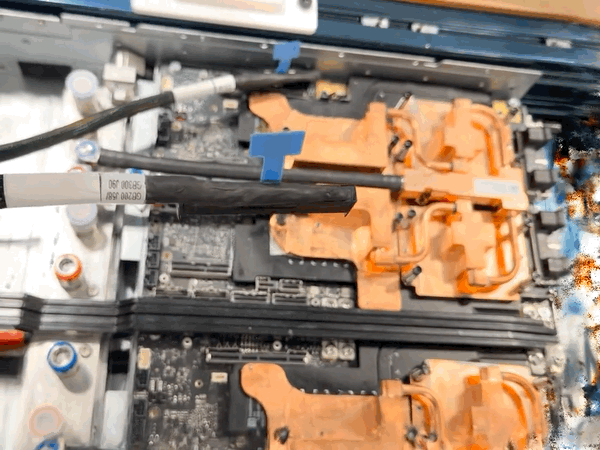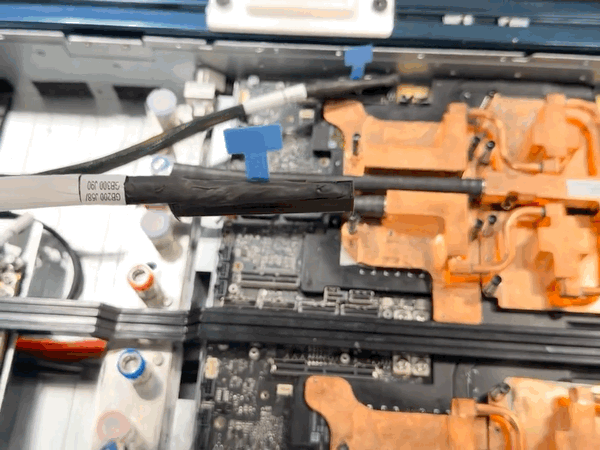
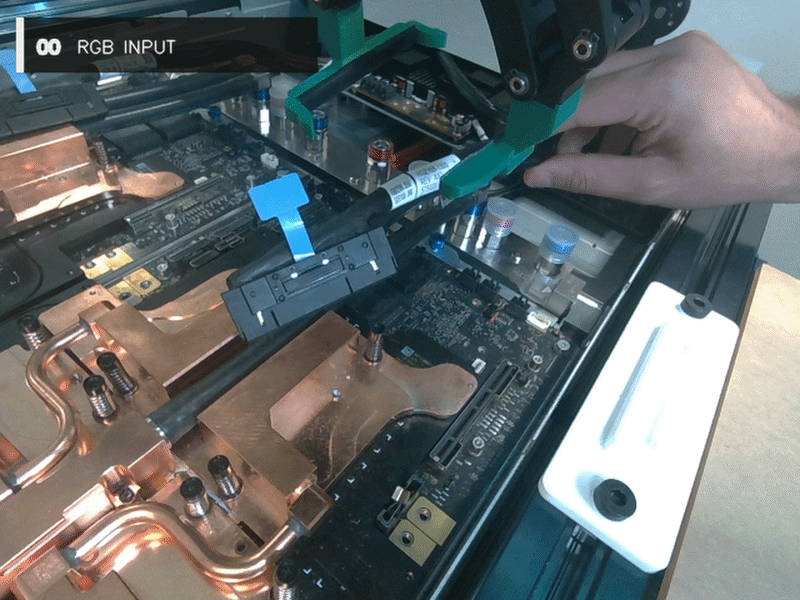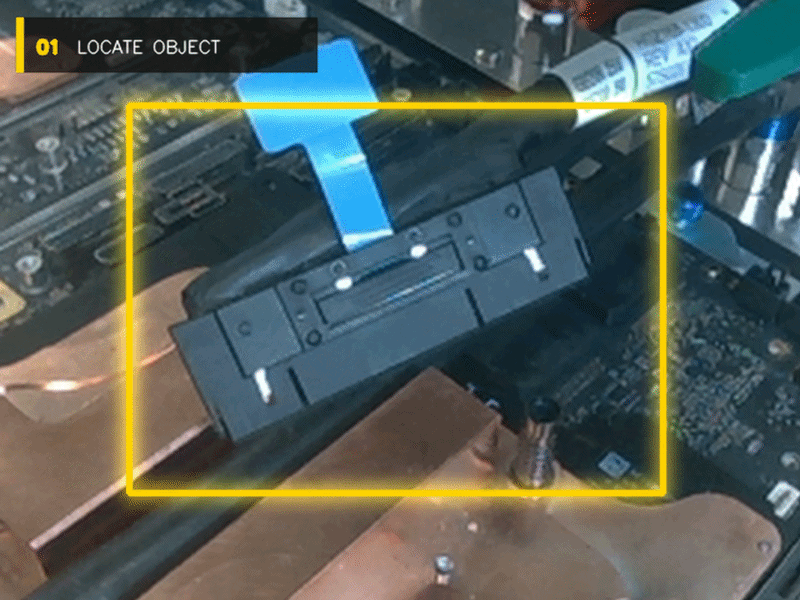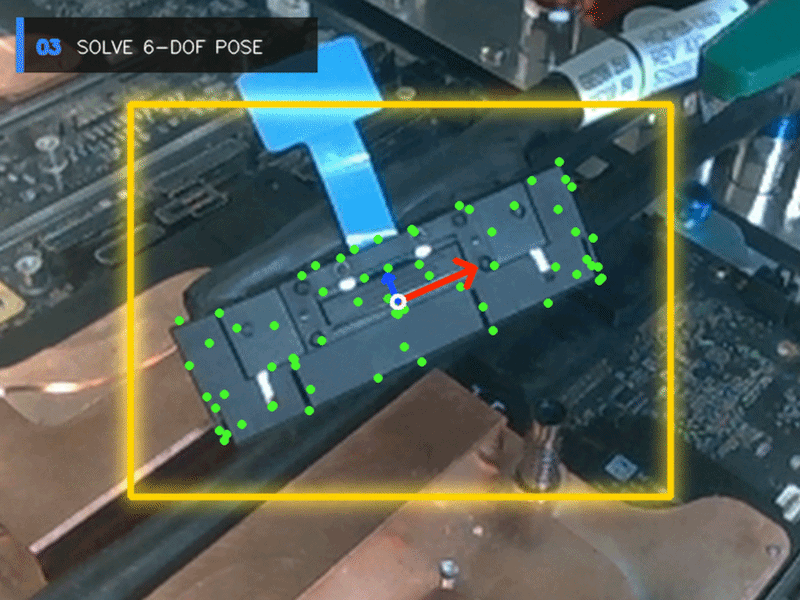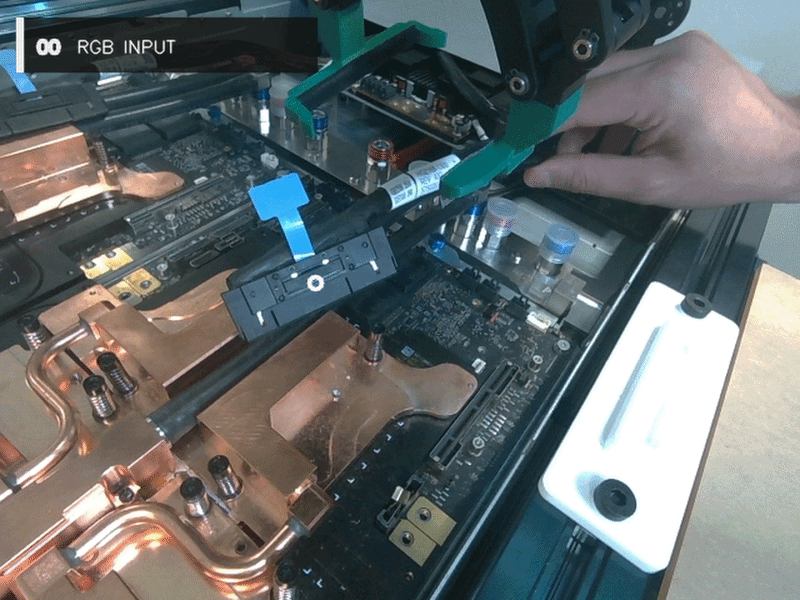
Hình 7. [Bên trái] Một hoạt ảnh được render từ tái tạo thần kinh của kết nối DC-SCI, được sử dụng để tinh chỉnh một mô hình DOPER. [Bên phải] Một mô hình DOPER tại thời điểm suy luận
DOPER đã làm sống lại niềm tin của chúng tôi vào tiềm năng của ước lượng tư thế. Khung làm việc này cho phép chúng tôi huấn luyện các bộ ước lượng tư thế chính xác, chuyên biệt cho các đầu nối của mình và triển khai các mô hình này theo thời gian thực. Sử dụng các ước lượng kết quả, một cánh tay robot có thể dịch chuyển và xoay mỗi đầu nối vào một tư thế mà từ đó cánh tay thứ hai có thể nắm giữ nó một cách đáng tin cậy.
Đoạn chuyển 2: Thiết kế cơ khí như việc giảm thiểu sự không chắc chắn
Như đã mô tả trước đó, do chu kỳ thiết kế nhanh và số lượng thấp, quá trình lắp ráp khay thử nghiệm GB300 đòi hỏi tự động hóa linh hoạt, trong đó các robot phải thích ứng và bền vững trước sự không chắc chắn về các bộ phận và tư thế. Đồng thời, các hệ thống linh hoạt vẫn có thể hưởng lợi từ những đổi mới trong tự động hóa cố định, chẳng hạn như sử dụng thiết kế cơ khí để giảm thiểu sự không chắc chắn.
Rất tiếc, các nhà nghiên cứu cơ điện tử tập trung vào tự động hóa cố định và các nhà khoa học máy tính tập trung vào tự động hóa linh hoạt từ lâu đã hoạt động trong những lĩnh vực khác nhau. Thay vào đó, chúng tôi ủng hộ một cách tiếp cận toàn diện, xem xét tổng thể về phần cứng, phần mềm và nghiên cứu AI.
Trong quá trình nắm bắt đầu nối, tiếp xúc khi kẹp gắp đóng có thể làm xáo trộn các đầu nối vào các tư thế không mong muốn hoặc không ổn định. Mặc dù cảm biến xúc giác, nắm lại và/hoặc thao tác trong tay có thể là những giải pháp hiệu quả, nhưng giải pháp thẳng thắn và tối ưu thời gian chu kỳ nhất trong trường hợp của chúng tôi đơn giản là thiết kế cơ khí tốt hơn.
Chúng tôi đã thiết kế hai bộ ngón gắp đa năng, cho phép robot của chúng tôi nắm giữ thanh busbar, giá đỡ giới hạn, cáp, cũng như các đầu nối lớn và nhỏ.
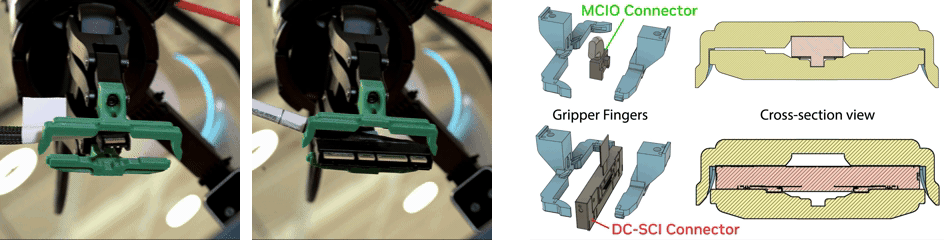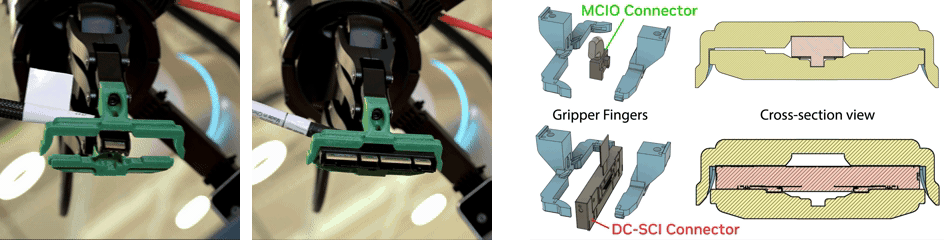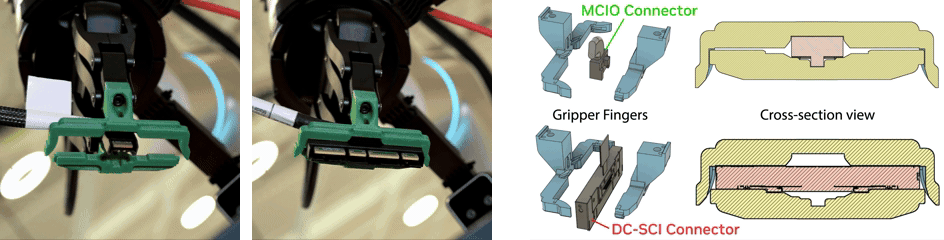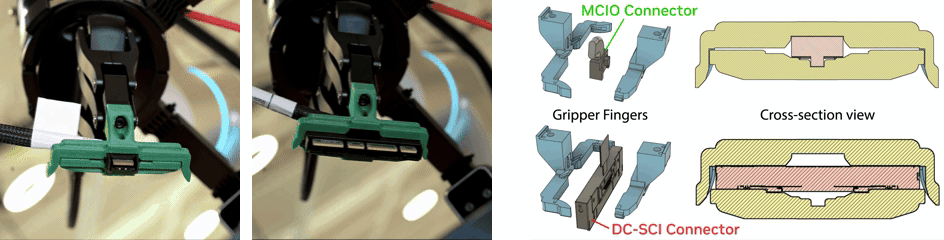
Hình 8. [Bên trái] Video về bộ ngón gắp đa năng đầu tiên. Những ngón gắp này được thiết kế để chấp nhận các sai lệch tư thế trước khi gắp và hướng dẫn các chi tiết vào các tư thế sau khi gắp có thể lặp lại. Video đầu tiên cho thấy các ngón gắp đang nắm giữ đầu nối MCIO nhỏ. Video thứ hai cho thấy cùng bộ ngón gắp đó đang nắm giữ đầu nối DC-SCI lớn. [Bên phải] Hình render CAD 3D của các ngón gắp đa năng với các đầu nối DC-SCI và MCIO, hiển thị các góc nhìn phối cảnh và mặt cắt. Hình học của ngón gắp hạn chế chuyển động của đầu nối trong quá trình tiếp xúc để tạo ra các tư thế sau khi gắp có thể lặp lại
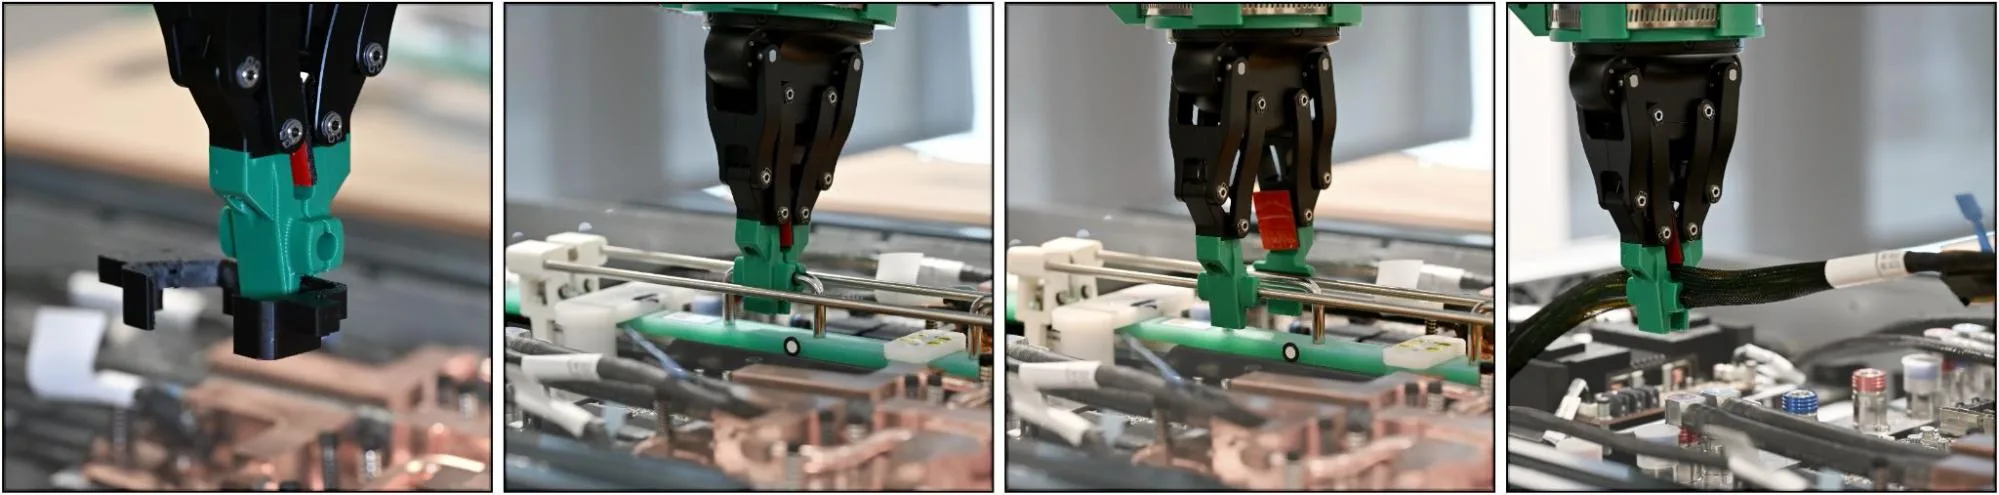
Hình 9. Bộ ngón gắp đa năng thứ hai. Những ngón này được thiết kế để nắm (từ trái sang phải) giá đỡ, tay cầm thanh dẫn điện, cơ cấu giải phóng cho kẹp thanh dẫn điện và các cáp
Hình học của các ngón gắp đã hạn chế chuyển động của chi tiết trong quá trình tiếp xúc, giúp các tư thế nắm trở nên lặp lại hơn nhiều. Những ngón gắp này có thể được tái tạo trên hầu hết các máy in 3D cấp độ nghiệp dư.
Giai đoạn cuối cùng: Một môn thể thao tiếp xúc
Sau khi nắm giữ mỗi đầu nối, bước cuối cùng của quá trình chèn nhiều đầu nối là chèn đầu nối vào ổ cắm tương ứng trên bo mạch GB300. So với việc chèn thanh dẫn điện, việc chèn các đầu nối khó khăn hơn do các chân dẫn điện tinh vi, khoảng hở hẹp và bề mặt dẫn hướng tối thiểu trong quá trình tiếp xúc.
Trong những điều kiện như vậy, các phương pháp truyền thống được biết là gặp khó khăn. Sự biến đổi trong hình học ổ cắm, các, các lỗi tích lũy trong điều khiển robot, hoặc các hồ sơ lực chèn không phù hợp có thể khiến kết nối bị kẹt trong ổ cắm, trượt khỏi ổ cắm, hoặc thậm chí va chạm với các thành phần xung quanh. Các bộ điều khiển linh hoạt có thể hữu ích, nhưng thiếu độ bền vững đối với các lỗi không gian lớn và cần được tinh chỉnh cẩn thận cho từng tác vụ.
Do đó, chúng tôi đã chuyển sang các giải pháp dựa trên học máy. Dựa trên dòng nghiên cứu sim-to-real của chúng tôi (1, 2, 3, 4, 5), chúng tôi đã sử dụng RL không mô hình để huấn luyện các chính sách trong NVIDIA Isaac Lab có thể chèn các kết nối điện từ một phạm vi rộng các tư thế ban đầu, và chúng tôi đã triển khai các chính sách này trong thế giới thực.
Video 9-12. Huấn luyện song song dựa trên RL cho các chính sách chèn kết nối trong Isaac Lab. (Bên trái) Các chính sách được huấn luyện một phần cho các kết nối DC-SCI và MCIO. (Bên phải) Các chính sách được huấn luyện hoàn chỉnh
Chuyển giao từ mô phỏng sang thực tế đã đạt được tỷ lệ thành công cao cho kết nối lớn trong thế giới thực. Tuy nhiên, phương pháp này kém hiệu quả hơn đối với kết nối nhỏ. Các chính sách sử dụng các ước lượng tư thế, và ngay cả những sai số ước tính nhỏ nhất cũng có thể khiến kết nối trượt khỏi mép ổ cắm. Ngay cả với kết nối lớn, độ tin cậy vẫn chưa đáp ứng các tiêu chuẩn công nghiệp. Do đó, chúng tôi đã đưa ra kết luận kỹ thuật cuối cùng: không có gì thay thế được dữ liệu thực tế.
Chính xác hơn, hầu hết các triển khai trong thực tế đều hướng đến việc đạt được hiệu suất tối ưu, chẳng hạn như độ tin cậy tối đa, tốc độ tối đa hoặc tỷ lệ can thiệp tối thiểu. Do sự không khớp giữa mô phỏng và thế giới thực luôn tồn tại, các chính sách được huấn luyện trong mô phỏng có thể dễ dàng trở nên không tối ưu. Do đó, các triển khai trong thực tế có thể được hưởng lợi từ việc học trực tiếp từ dữ liệu thực tế, lý tưởng nhất là từ tương tác trực tuyến khi có thể.
Trong trường hợp của chúng tôi, chúng tôi đã cải thiện các chính sách chèn của mình bằng cách mở rộng công việc trước đó SPARR của chúng tôi. Trong SPARR, một chính sách cơ bản dựa trên trạng thái trước tiên được huấn luyện thông qua RL trong mô phỏng, và sau đó một chính sách dư dựa trên hình ảnh được huấn luyện thông qua RL trong thế giới thực. Các rollout từ chính sách cơ bản khởi tạo việc học trong thế giới thực nhằm khuyến khích việc học hiệu quả và khám phá an toàn. Vì các đầu nối bị che khuất về mặt thị giác trong quá trình chèn, chúng tôi đã huấn luyện chính sách dư với các đầu vào lực-mô-men xoắn thay vì hình ảnh.
Giải pháp chèn nhiều kết nối cuối cùng của chúng tôi đã tích hợp các phương pháp nắm giữ cáp, nắm giữ kết nối và chèn kết nối để lắp ráp tất cả bốn kết nối từ đầu đến cuối. Hệ thống đạt tỷ lệ thành công từ 90-95%; các lỗi còn lại chủ yếu đến từ vấn đề phối hợp nhiều cánh tay trong quá trình nắm giữ kết nối. Thời gian chu kỳ trung bình là 40 giây mỗi cáp; nút thắt cổ chai chính là việc điều chỉnh rời rạc, chậm chạp các tư thế của các kết nối lộ ra trước khi nắm giữ chúng. Mặc dù hiệu suất chưa đáp ứng yêu cầu triển khai, các nỗ lực đang tiếp tục thu hẹp khoảng cách này.
Tại sao điều này quan trọng: Hướng tới một vòng tuần hoàn tích cực
Tự động hóa quy trình sản xuất và kiểm tra các hệ thống GB300 cùng các hệ thống kế nhiệm của chúng có giá trị vô cùng to lớn đối với NVIDIA và hệ sinh thái AI, vì những hệ thống này chính là động cơ tính toán của các mô hình nền tảng. Về lâu dài, việc bổ sung cho lực lượng lao động lành nghề bằng tự động hóa thông minh là yếu tố then chốt đối với sản xuất trong nước: 1,9 triệu việc làm trong ngành sản xuất có thể không được lấp đầy vào năm 2033. Trong dài hạn, việc lắp ráp phần cứng AI bằng robot có thể hiện thực hóa một tầm nhìn còn lớn lao hơn: một tương lai mà, dưới sự giám sát của con người, các robot được hỗ trợ bởi AI sẽ lắp ráp phần cứng AI, sau đó các phần cứng này sẽ huấn luyện thế hệ robot AI tiếp theo trong một vòng lặp an toàn và lành mạnh.
Những ngụ ngôn của Blackwell: Bài học từ câu chuyện
Việc xử lý việc lắp ráp khay kiểm tra GB300 là một trong những bài tập nghiên cứu bổ ích nhất mà chúng tôi đã thực hiện, củng cố giá trị của nghiên cứu theo hướng nhiệm vụ.
Trong nghiên cứu, việc phát triển các phương pháp tiếp cận kỹ thuật ở mức trừu tượng là một thực hành phổ biến và có giá trị, vì nó có thể mang lại lợi ích lớn nhiều năm sau khi các ứng dụng trở nên rõ ràng. Kinh nghiệm của chúng tôi trong việc lắp ráp GB300 cho thấy một cách tiếp cận bổ sung: xác định một vấn đề gần như không thể giải quyết nhưng có giá trị thực tế đáng kể, phơi bày năng lực và giới hạn của các phương pháp hiện có, và đổi mới ở những nơi không có con đường rõ ràng phía trước.
Công việc của chúng tôi cũng đã dạy cho chúng tôi bảy bài học kỹ thuật quan trọng:
- Ước lượng tư thế có thể rất hiệu quả. Vào đầu dự án, chúng tôi không tin vào kết luận này và thậm chí không muốn nó là sự thật. Tuy nhiên, khung DOPER của chúng tôi đã tạo ra các mô hình ước lượng tư thế nhanh và chính xác cho các bộ phận công nghiệp. Chìa khóa là xem xét lại ước lượng tư thế với các yêu cầu đã sửa đổi: huấn luyện các mô hình chuyên gia, tránh phụ thuộc vào kết cấu thị giác chính xác hoặc đặc trưng, và cho phép tinh chỉnh nhanh trên dữ liệu thực tế.
- Thiết kế cơ khí có thể giảm thiểu sự không chắc chắn một cách hiệu quả. Kết luận này là hiển nhiên đối với cộng đồng tự động hóa, nhưng có thể ít rõ ràng hơn trong lĩnh vực học máy robot. Thiết kế cơ khí của các ngón gắp in 3D cho phép chúng tôi nắm bắt các kẹp, cáp và giá đỡ một cách đáng tin cậy mà không cần đưa vào độ phức tạp thông qua cảm biến xúc giác, cơ chế nắm lại hoặc thao tác trong tay. Robot là một vấn đề toàn diện, và kết quả tốt nhất có thể đạt được bằng cả trí tuệ nhân tạo và trí tuệ cơ khí.
- Điều khiển hiệu suất cao không nên bị bỏ qua. Các nhà nghiên cứu đã làm việc trong nhiều thập kỷ để phát triển các bộ điều khiển robot hiệu suất cao, nhưng hầu hết các bài báo về học máy robot đều triển khai các quy luật điều khiển đơn giản nhất có thể. Các bộ điều khiển hiệu suất cao với thiết kế giảm chấn tự động và bù quán tính có thể đảm bảo chuyển động không gian tự do mượt mà, tạo điều kiện thuận lợi cho các tương tác tiếp xúc nhẹ nhàng và ổn định, và cải thiện tỷ lệ thành công và thời gian chu kỳ của các hành vi được học thông qua RL.
- Các chế độ bị giới hạn bởi quy mô cần được xem xét thêm. Bài học cay đắng được hỗ trợ bởi bằng chứng thực nghiệm đáng kể; tuy nhiên, trong điều mà chúng tôi gọi là “bài học cay đắng ngược”, quy mô có thể trở nên khó xử lý khi dữ liệu tương tác khan hiếm, các bộ phận khó mô phỏng, chi phí thay thế cao, hoặc việc sử dụng lặp lại làm suy giảm các đối tượng. Các phương pháp cổ điển vẫn có thể mạnh mẽ, và nghiên cứu dựa trên học máy có thể được hưởng lợi từ việc nhấn mạnh thêm vào cấu trúc và hiệu quả mẫu.
- Thời gian chu kỳ là một đối trọng xứng đáng với tỷ lệ thành công. Một hệ thống học robot điển hình có thể kết hợp cảm biến vị trí 1 kHz, chính sách 100 Hz, luồng camera 30 Hz và điều khiển gắp 5 Hz, với các đảm bảo thời gian thực khác nhau. Một số nhiệm vụ con có thể khó hoặc không thể song song hóa. Tốc độ tăng lên phải duy trì độ chính xác điều khiển, đảm bảo an toàn cho con người và robot, và tránh làm hỏng bộ phận. Các nhà nghiên cứu nên xem xét thời gian chu kỳ và tỷ lệ thành công với mức độ ưu tiên ngang nhau.
- Hạ tầng nghiên cứu thúc đẩy quá trình phát triển và triển khai. Trong công việc của chúng tôi, các dịch vụ robot và TALOS đóng vai trò quan trọng trong việc tránh xung đột phụ thuộc, cho phép các bộ lập kế hoạch và bộ điều khiển khác nhau có thể thay thế lẫn nhau, và chuyển giao mã nguồn giữa các robot. Trong khi các công ty khởi nghiệp và tập đoàn có thể đầu tư sâu vào hạ tầng, các phòng thí nghiệm nghiên cứu thường không làm như vậy; các nỗ lực cộng đồng trong việc phát triển hạ tầng phù hợp với nghiên cứu có thể thúc đẩy tiến bộ trong lĩnh vực này.
- Cả dữ liệu tổng hợp và dữ liệu thực tế đều đóng vai trò quan trọng. DOPER đã sử dụng dữ liệu tổng hợp quy mô lớn, cụ thể theo từng bộ phận để khởi động quá trình huấn luyện, và cách tiếp cận chèn kết nối của chúng tôi tận dụng RL dựa trên mô phỏng để huấn luyện trước các chính sách. Tuy nhiên, dữ liệu thực tế vẫn chứng minh được sự cần thiết. Những yêu cầu nghiêm ngặt của robot công nghiệp không thể chấp nhận việc bỏ lỡ hiệu suất, và dữ liệu tổng hợp cùng dữ liệu thực tế phải được kết hợp để mang lại giá trị thực tế.
Đóng khoảng cách giữa phòng thí nghiệm và nhà máy
Trong lĩnh vực robot, thước đo thực sự cho sự thành công của nghiên cứu là khả năng ứng dụng vào thế giới thực. Mục tiêu tiếp theo của chúng tôi là triển khai công nghệ của mình vào các nhà máy nơi các nhà sản xuất theo hợp đồng của NVIDIA sản xuất phần cứng AI; chúng tôi đặt mục tiêu đáp ứng hoặc vượt qua các yêu cầu hiệu suất của họ, và qua đó, đẩy nhanh quá trình sản xuất các hệ thống tính toán tiên tiến nhất trên thế giới.
Tuy nhiên, triển khai trong thực tế đi kèm với những thách thức đáng kể. Trước hết là vấn đề sau: ngay cả khi một giải pháp robot hoạt động tốt trong các thử nghiệm phòng thí nghiệm, làm thế nào để đảm bảo hiệu suất của nó trước khi triển khai? Nhà máy sẽ có các điều kiện môi trường và tế bào làm việc riêng biệt, và việc xử lý sự lệch biệt miền (domain mismatch) là điểm yếu gần như phổ biến của các robot dựa trên học máy. Các dây chuyền sản xuất thực tế cũng chịu tác động của những thay đổi trong thiết kế sản phẩm, một bậc tự do khác không thể quan sát được trong phòng thí nghiệm.
Ngoài ra, ngay cả khi hệ thống đủ mạnh mẽ hoặc thích ứng, hiệu suất của nó vẫn phải được xác minh. Để hỗ trợ xác suất thành công ít nhất 99,5% với cận tin cậy một phía 95%, không được quan sát thấy bất kỳ sự cố nào trong ít nhất 598 lần thử. Trong trường hợp của chúng tôi, do sự hao mòn, các đánh giá như vậy có thể yêu cầu hàng trăm thành phần GB300 dự phòng. Mô phỏng chính xác các thành phần không đều về hình học và cơ học cũng là một thách thức mở, bất chấp những tiến bộ gần đây trong mô phỏng vật lý và mô hình thế giới tương tác.
Chúng tôi đề xuất rút kinh nghiệm từ ngành xe tự hành (AV). Trong lĩnh vực AV, ranh giới giữa huấn luyện ngoại tuyến và triển khai trực tuyến bị mờ nhạt: ban đầu, con người giám sát và sửa chữa hành vi của phương tiện một cách cẩn thận, nhưng theo thời gian, chiếc xe trở nên tự chủ hơn. Tương tự, một hệ thống robot học nên được triển khai với hiệu suất mạnh mẽ nhưng chưa hoàn hảo. Con người hoặc các tác nhân được con người giám sát nên ghi lại các can thiệp một cách liền mạch, và hệ thống nên tận dụng chúng để cải thiện liên tục. Theo thời gian, đủ dữ liệu sẽ được thu thập trong các điều kiện triển khai thực tế để cung cấp các đảm bảo thống kê mạnh mẽ về hiệu suất.
Thách thức chính thứ hai của việc triển khai thực tế là, sau khi triển khai một giải pháp robot để giải quyết một nhiệm vụ cụ thể, làm thế nào để nhiệm vụ tiếp theo có thể được giải quyết với ít nỗ lực hơn? Mục tiêu này có thể được tóm tắt bằng hai từ: sự khái quát hóa và sự thích ứng.
Một dạng khả năng khái quát hóa mạnh mẽ là khi một robot được huấn luyện trên một tập các tác vụ có thể giải quyết tốt một tác vụ mới. Nếu một robot biết cách chèn chốt gỗ vào lỗ, lắp ráp một bộ bánh răng và siết chặt ốc vít, nó nên có sự hiểu biết thông thường ở cấp độ cao và sự khéo léo ở cấp độ thấp để cắm một cáp USB-C. Một dạng khả năng thích ứng mạnh mẽ là khi một robot không biết cách giải quyết một tác vụ mới, nhưng có thể học nó một cách hiệu quả. Một robot có thể lắp ráp các bánh răng với khe hở 0,5 mm nên nhanh chóng học được cách lắp ráp các bánh răng với khe hở 0,1 mm.
Nhất quán với sự đồng thuận trong nghiên cứu, chúng tôi tin rằng con đường dài hạn hướng tới khả năng khái quát hóa và thích ứng là thông qua các mô hình học từ dữ liệu ở quy mô internet, bao gồm các mô hình thị giác-ngôn ngữ-hành động (VLA), các mô hình thế giới-hành động (WAM) và các mô hình nền tảng gốc robot. Những mô hình này đã cho thấy những dấu hiệu đáng chú ý về sự hiểu biết thông thường vật lý, thích ứng nhanh và học trong ngữ cảnh.
Tuy nhiên, có một bí mật công khai trong cộng đồng robot: chúng ta vẫn còn rất xa để nắm bắt được sự đa dạng gần như vô hạn của thế giới vật lý và học hỏi từ nó một cách hiệu quả. Như một thử nghiệm tư duy, một công ty xe tự hành (AV) có thể thu thập từ 100 TB đến 1 PB dữ liệu hữu ích mỗi ngày, nhưng lái xe tự hành chỉ là một nhiệm vụ mà một robot đa năng cần biết cách thực hiện. Hơn nữa, các hệ thống mô-đun trong các môi trường được ràng buộc hợp lý thường khái quát hóa tốt hơn và nhanh hơn so với các mô hình end-to-end (ví dụ: 1, 2).
Chúng tôi nhìn thấy ba con đường bổ trợ cho việc khái quát hóa và thích ứng trong các mô hình nền tảng robot. Con đường đầu tiên là vòng lặp dữ liệu: xây dựng các hệ thống robot liên tục được cải thiện trong các điều kiện triển khai, thu thập dữ liệu trong quá trình triển khai và sử dụng dữ liệu đó để huấn luyện giữa (mid-train) hoặc huấn luyện sau (post-train) các mô hình nền tảng. Hạn chế chính là phạm vi bao phủ: mỗi lần triển khai đại diện cho một phân phối tương tác hẹp, và các mô hình nền tảng có thể gặp khó khăn trong việc nội suy.
Con đường thứ hai là mô hình thế giới. Được định nghĩa là “mô hình dự đoán đa phương thức có điều kiện hành động”, những mô hình này có thể được huấn luyện trên hầu như bất kỳ nguồn dữ liệu vật lý nào. Các nhà nghiên cứu cuối cùng có thể sử dụng chúng như một trình mô phỏng cho mọi tương tác vật lý, cho phép huấn luyện sau đa dạng cho các mô hình nền tảng robot. Tuy nhiên, các mô hình thế giới trong tương lai phải tiến hóa theo thời gian; như đã thảo luận trước đó, động lực học của các đối tượng có thể rất không dừng.
Con đường thứ ba là robotics do tác nhân điều khiển. Như được gợi ý trong các đột phá gần đây (ví dụ: 1, 2, 3), các tác nhân không chỉ thể hiện ngày càng nhiều kiến thức thông thường của con người, bao gồm suy luận không gian, mà còn có thể đề xuất các hành động hiệu quả trong các trình mô phỏng, mô hình thế giới và thế giới thực. Các hành động do tác nhân hướng dẫn có thể tạo ra dữ liệu huấn luyện sau, và các can thiệp do tác nhân hướng dẫn cuối cùng có thể thay thế cho các sự sửa lỗi của con người trên các nhiệm vụ mới.
Chúng tôi kết thúc bằng một lời kêu gọi hành động: hãy tham gia cùng chúng tôi trong hành trình này. Việc lắp ráp phần cứng AI bằng robot không chỉ đại diện cho một trong những vấn đề có tác động lớn nhất của thời đại hiện đại, mà còn là một ngôi sao Bắc Cực đầy sức hấp dẫn cho nghiên cứu robot học cơ bản và ứng dụng. Chúng tôi rất hào hứng khi thấy cộng đồng đạt được những tiến bộ nhanh chóng theo hướng này.
Tìm hiểu sâu hơn
Chúng tôi đang chuẩn bị một whitepaper mô tả chi tiết đáng kể về các phương pháp và kết quả thực nghiệm mới nhất của chúng tôi. Chúng tôi cũng đang hướng tới việc phát hành DOPER và TALOS để cộng đồng sử dụng, cùng với các quy trình tham chiếu cho việc lắp connector được xây dựng hợp tác với đội kỹ thuật NVIDIA Isaac.
Chúng tôi sẽ cập nhật bài viết này với các liên kết khi mỗi bản phát hành được đưa vào hoạt động.
Hãy xem Tóm tắt Nghiên cứu và Phát triển Robot của NVIDIA (R2D2) để có cái nhìn tổng quan nhanh về những đột phá mới nhất từ NVIDIA Research trong các ứng dụng AI vật lý và robot.
Luôn cập nhật thông tin bằng cách đăng ký tin tức và theo dõi NVIDIA Robotics trên YouTube, Discord và diễn đàn dành cho nhà phát triển. Để bắt đầu hành trình robot của bạn, hãy đăng ký các khóa học Nền tảng Robot miễn phí của NVIDIA.
Bài viết liên quan
- NVIDIA Nemotron 3.5 Super VL hỗ trợ các tác nhân chuyên biệt với khả năng suy luận đa phương thức
- Mở rộng quy trình lập trình Agentic với Muse Spark Open của Meta trên NVIDIA GB300 NVL72
- Đánh giá hiệu năng suy luận LLM quy mô lớn với AIPerf
- Một nền tảng, hai cấu hình: Giải mã sự khác biệt giữa NVIDIA DGX Spark 64GB và 128GB
- Thêm các trình điều khiển runtime cho các tác nhân AI với NVIDIA OpenShell