Trí tuệ nhân tạo đang bước vào giai đoạn mới: các tác nhân AI, mô hình mã nguồn mở và quy trình tinh chỉnh rời đám mây để về thẳng bàn làm việc của nhà phát triển. Dữ liệu ở lại trong doanh nghiệp, mô hình chạy ngay trên thiết bị, và đội ngũ toàn quyền làm chủ hạ tầng AI của mình. Khi AI cục bộ đã trở thành hiện thực, câu hỏi then chốt chuyển sang dung lượng: dự án của bạn cần bao nhiêu bộ nhớ cho mô hình, ngữ cảnh và số tác nhân?
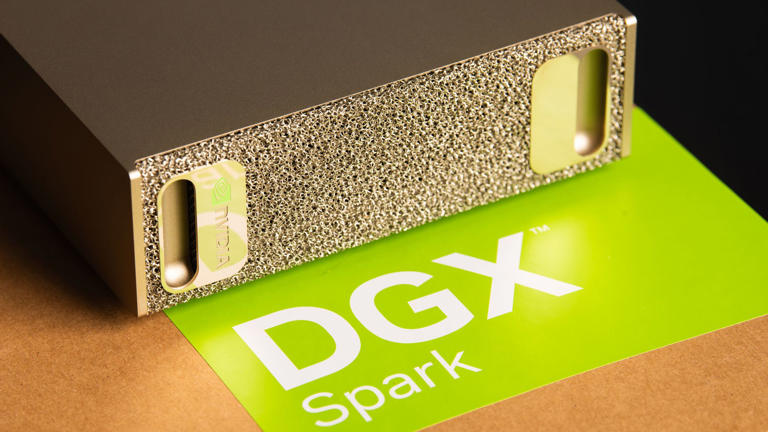
NVIDIA trả lời bằng một nền tảng duy nhất với hai lựa chọn dung lượng. Bên cạnh DGX Spark 128GB, phiên bản DGX Spark 64GB chính thức có mặt từ ngày 23/10/2026 qua Acer, ASUS, Dell, Gigabyte, HP và MSI. Cả hai cùng mang trái tim GB10 Grace Blackwell, sức mạnh 1 PFLOP FP4, băng thông 273 GB/s, card mạng ConnectX-7 200 Gb/s và trọn bộ phần mềm NVIDIA AI.
Ad
Cùng một kiến trúc, cùng hiệu năng lõi, khác biệt cốt lõi nằm ở dung lượng bộ nhớ hợp nhất. Bài viết đặt hai phiên bản lên bàn cân ở bốn khía cạnh: thông số kỹ thuật, dư địa bộ nhớ, hiệu năng và khả năng mở rộng, giúp bạn thấy rõ mỗi cấu hình đáp ứng được tới đâu.
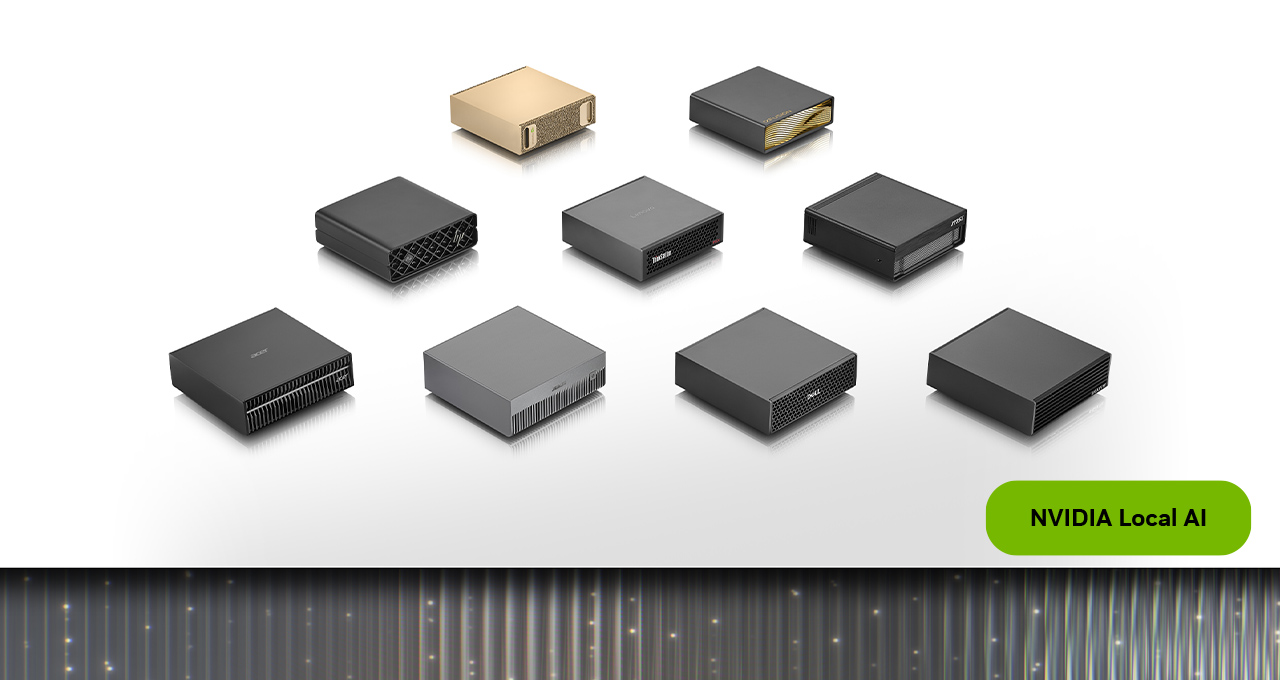
Dòng máy DGX Spark từ các hãng sản xuất
Bộ Nhớ Hợp Nhất: Yếu Tố Định Hình Khoảng Cách Giữa Hai Cấu Hình
Hai phiên bản sở hữu sức mạnh tính toán như nhau. Thứ tạo nên khoảng cách là bộ nhớ, thể hiện qua ba yếu tố:
- Quy mô mô hình: Bản 64GB xử lý mô hình đến 100 tỷ tham số; bản 128GB nâng trần lên 200 tỷ.
- Độ dài ngữ cảnh: Mỗi token ngữ cảnh cần thêm bộ nhớ KV Cache. Tài liệu càng dài, hội thoại càng sâu, nhu cầu bộ nhớ càng lớn.
- Số phiên đồng thời: Mỗi tác nhân hay người dùng thêm vào đều cần không gian riêng; tinh chỉnh mô hình cũng đòi hỏi nhiều bộ nhớ cho trạng thái huấn luyện.
Thông Số Kỹ Thuật: Đồng Nhất Ở Kiến Trúc Lõi
Ở cấp độ kiến trúc, hai phiên bản gần như là một: cùng siêu chip, cùng GPU Blackwell, cùng băng thông và cùng hạ tầng mạng. Thông số theo công bố của NVIDIA; bản 128GB lấy theo Founders Edition, bản 64GB do từng hãng sản xuất hoàn thiện vỏ máy, lưu trữ và nguồn.
| Thông số | DGX Spark 64GB | DGX Spark 128GB |
|---|---|---|
| Chip | GB10 Grace Blackwell | |
| CPU | 20 lõi Arm: 10 Cortex-X925 + 10 Cortex-A725 | Giống |
| GPU | Blackwell, 6.144 CUDA core, Tensor Core thế hệ 5 | Giống |
| Sức tính AI | Đến 1 PFLOP FP4 khi tận dụng tính thưa | Giống |
| Bộ nhớ hợp nhất | 64GB LPDDR5X | 128GB LPDDR5X |
| Giao tiếp, băng thông | 256-bit, 273 GB/s | 256-bit, 273 GB/s |
| Mạng tốc độ cao | ConnectX-7 200 Gb/s | ConnectX-7 200 Gb/s, 2 cổng QSFP |
| Kết nối khác | Theo hãng sản xuất | 10 GbE, Wi-Fi 7, Bluetooth 5.4, 4 USB-C, HDMI 2.1a |
| Lưu trữ | Theo hãng sản xuất | NVMe M.2 tự mã hóa, 1TB hoặc 4TB |
| Nguồn | TDP chip 140W; adapter theo hãng | TDP chip 140W; adapter 240W |
| Kích thước, trọng lượng | Theo hãng sản xuất | 150 × 150 × 50,5 mm; 1,2 kg |
| Trần mô hình một máy | 100 tỷ tham số | 200 tỷ tham số |
| Tinh chỉnh mô hình | Chưa công bố | Đến 70 tỷ tham số |
| Ghép cụm | Tối đa 4 máy | Tối đa 4 máy |
| Phần mềm | DGX OS, ngăn xếp phần mềm AI NVIDIA, NVIDIA Sync | Giống |
Dung Lượng Khả Dụng: Dư Địa Thực Tế Cho Mô Hình AI
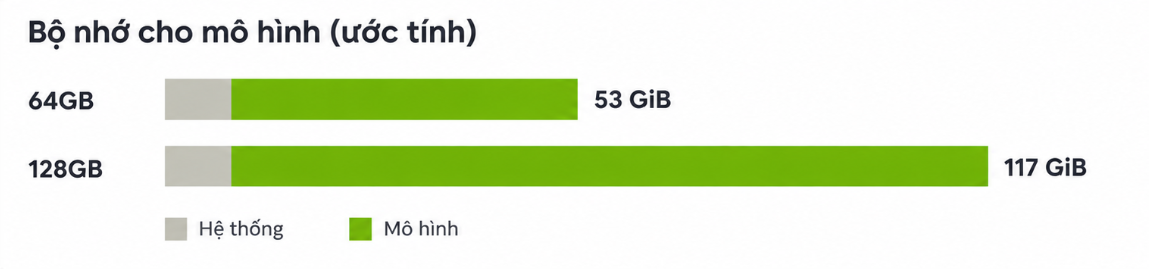
Bản 128GB mang lại khoảng 117 GiB dành riêng cho mô hình và ngữ cảnh, gấp 2,2 lần bản 64GB. Đây là con số ước tính sau khi trừ khoảng 11 GiB cho firmware, hệ điều hành và runtime; NVIDIA chưa công bố dung lượng khả dụng chính thức.
Hiệu Năng Điện Toán: Ngang Bằng Trên Cùng Một Mô Hình
Với cùng một mô hình vừa bộ nhớ, bản 64GB được kỳ vọng chạy nhanh ngang bản 128GB. Pha đọc prompt tận dụng trọn sức tính 1 PFLOP FP4 của GB10, pha sinh token dựa vào băng thông 273 GB/s, và cả hai thông số này giống hệt nhau trên hai phiên bản.
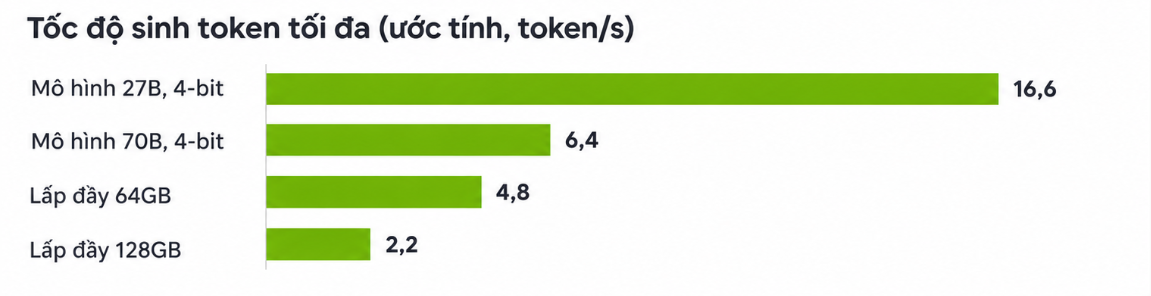
Biểu đồ thể hiện trần lý thuyết ước tính; tốc độ thực tế thấp hơn. Mô hình dense càng lớn thì càng chậm, vì vậy dung lượng thêm của bản 128GB phát huy giá trị rõ nhất với mô hình MoE, ngữ cảnh dài và nhiều phiên song song.
Quy Mô Mô Hình: Từ 100 Đến 405 Tỷ Tham Số
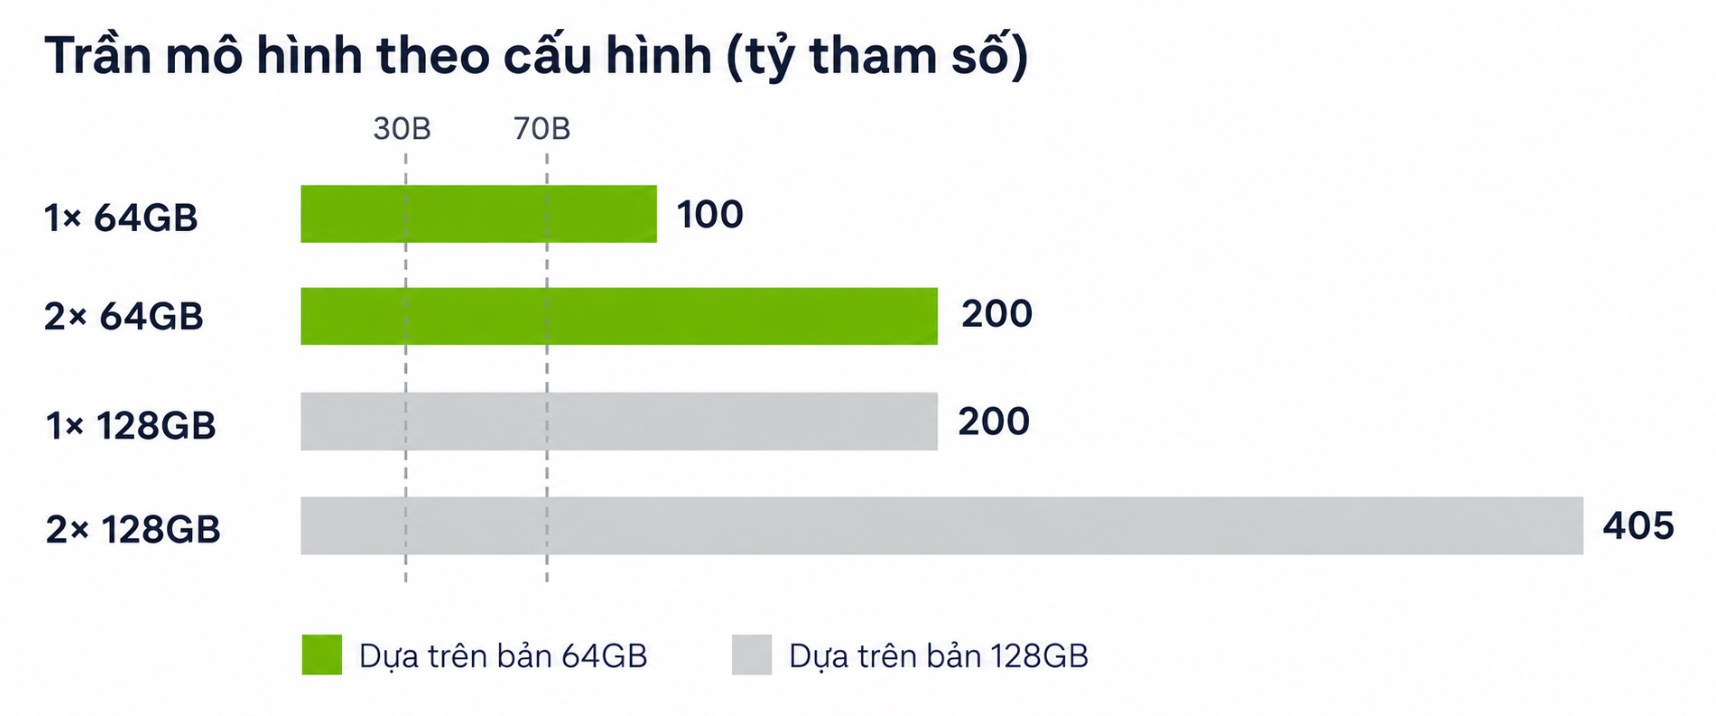
Mô hình 30–70 tỷ tham số 4-bit, nhóm thường dùng cho tác nhân AI, chạy được trên mọi cấu hình. Khác biệt nằm ở chiều sâu ngữ cảnh: bản 64GB vận hành mô hình 70B với ngữ cảnh vừa phải, bản 128GB giữ được đến 128K token; sinh ảnh, video BF16/FP16 cần bản 128GB (ước tính).
Mở Rộng Theo Cụm: Hai Máy 64GB Đặt Cạnh Một Máy 128GB
Bộ nhớ không phải giới hạn cố định. Mỗi DGX Spark đều tích hợp sẵn card mạng ConnectX-7 200 Gb/s và ghép được tối đa bốn máy. Hai máy 64GB đạt cùng tổng bộ nhớ và cùng trần 200 tỷ tham số như một máy 128GB, đồng thời nhân đôi sức tính và băng thông.
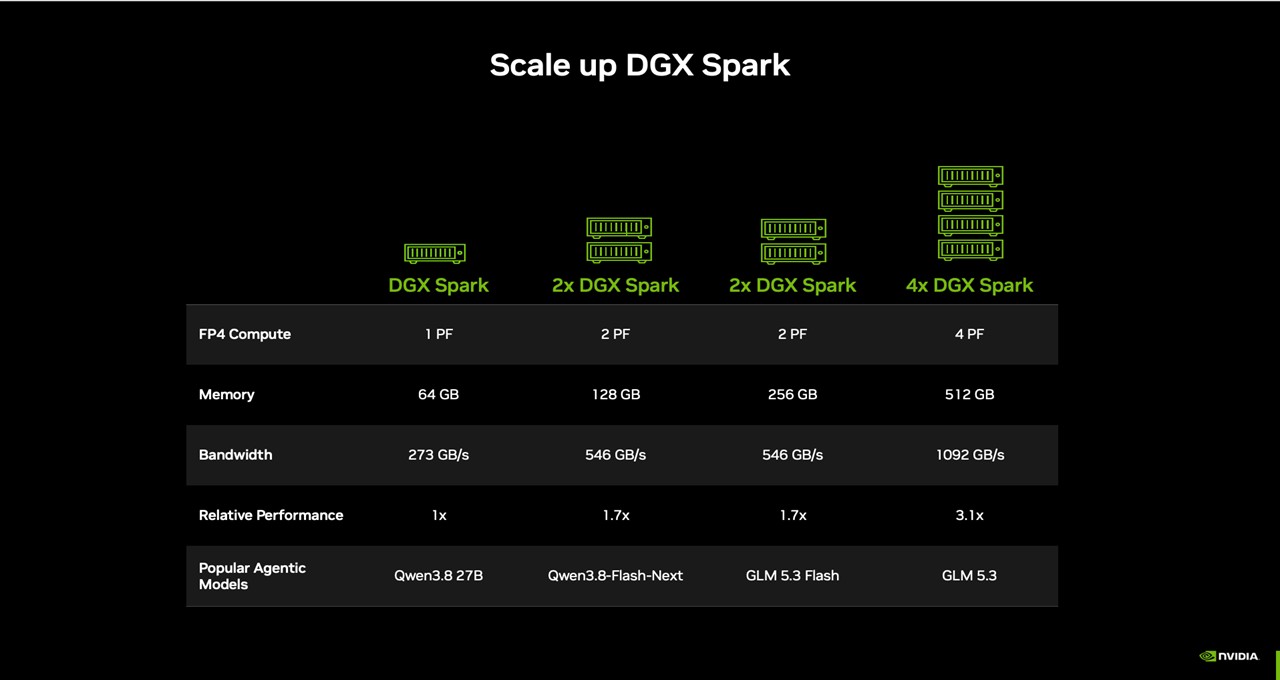
Hiệu năng tương đối do NVIDIA tự đo, chưa công bố cấu hình phép thử. Cụm máy là hệ phân tán: liên kết giữa hai máy tối đa 25 GB/s theo lý thuyết, thấp hơn khoảng 11 lần so với bộ nhớ trong máy, nên cần runtime hỗ trợ chia mô hình qua mạng. Trong khi đó, một máy 128GB giữ toàn bộ mô hình trong cùng một vùng nhớ và vận hành độc lập với mạng.
Khả Năng Đáp Ứng Khối Lượng Công Việc Theo Từng Cấu Hình
Chung một hệ sinh thái phần mềm, nên khả năng đáp ứng của từng cấu hình chỉ phụ thuộc vào dung lượng bộ nhớ:
| Tác vụ | DGX Spark 64GB | DGX Spark 128GB | Cụm 2× 64GB |
|---|---|---|---|
| Tác nhân AI 24/7 với mô hình 20–32B 4-bit | Có | Có | Có |
| Khoa học dữ liệu tăng tốc GPU | Có | Có | Có |
| Nhiều tác nhân, ngữ cảnh dài cùng lúc | Hạn chế | Có | Có |
| Sinh ảnh, video FP8 | Có | Có | Có |
| Sinh ảnh, video BF16/FP16 | Không | Có | Chưa có số liệu |
| Tinh chỉnh mô hình đến 70 tỷ tham số | Chưa công bố | Có | Chưa công bố |
| Tinh chỉnh đầy đủ mô hình 7B, khoảng 104 GiB | Không | Sát | Chưa có số liệu |
Khả năng tinh chỉnh đến 70 tỷ tham số là số liệu NVIDIA công bố cho bản 128GB; các ô còn lại là ước tính theo dung lượng bộ nhớ.
Lợi Thế Và Giới Hạn Của DGX Spark 64GB Trong Tương Quan Với Bản 128GB
Lợi thế
- Hiệu năng lõi nguyên vẹn: Cùng GB10, 1 PFLOP FP4 và 273 GB/s; với mô hình vừa bộ nhớ, tốc độ được kỳ vọng ngang bản 128GB.
- Một hệ sinh thái, không rào cản: Phần mềm, công cụ và quy trình giống hệt, dự án chuyển giữa hai cấu hình mà không cần thiết lập lại.
- Mở rộng linh hoạt từng bước: Bắt đầu với một máy, thêm máy thứ hai khi cần để đạt trần 200 tỷ tham số cùng 2 PFLOP và 546 GB/s.
- Đa dạng lựa chọn thiết kế: Sáu hãng sản xuất cùng phát triển, mỗi hãng một thiết kế vỏ máy và lưu trữ riêng.
Giới hạn
- Một nửa dư địa bộ nhớ: Khoảng 53 GiB so với 117 GiB cho mô hình (ước tính), nên ngữ cảnh dài và nhiều phiên đồng thời chạm trần sớm hơn.
- Trần mô hình một máy thấp hơn: 100 tỷ tham số so với 200 tỷ; vượt mức này phải ghép cụm và dùng runtime phân tán.
- Ảnh, video BF16/FP16 và tinh chỉnh lớn: Chưa vừa một máy (ước tính); NVIDIA chưa công bố giới hạn tinh chỉnh cho bản 64GB, trong khi bản 128GB tinh chỉnh được đến 70 tỷ tham số.
- Ít số liệu thực tế hơn: Chưa có benchmark độc lập; vỏ máy, lưu trữ và nguồn khác nhau theo từng hãng.
DGX Spark 64GB và 128GB là hai lựa chọn dung lượng trên cùng một nền tảng: cùng siêu chip GB10, cùng hệ sinh thái phần mềm NVIDIA AI, cùng khả năng mở rộng qua ConnectX-7. Bản 64GB mang trọn sức mạnh Grace Blackwell cho đa số tác vụ AI cục bộ, bản 128GB mở rộng dư địa cho mô hình lớn, ngữ cảnh dài và đa tác nhân. Xác định đúng nhu cầu bộ nhớ của workload là bước đầu tiên để khai thác trọn vẹn nền tảng này.
Hãy liên hệ ngay đội ngũ chuyên gia của Nhất Tiến Chung. Với vai trò NVIDIA Elite Partner tại Việt Nam, chúng tôi sẽ phân tích workload thực tế, đề xuất cấu hình DGX Spark phù hợp và đồng hành triển khai hạ tầng AI cục bộ cho doanh nghiệp.
Tổng đài: 1900 558879 · Email: sales@nhattienchung.vn
Bài viết liên quan
- Đánh giá hiệu năng suy luận LLM quy mô lớn với AIPerf
- Thêm các điều khiển thời gian chạy cho các tác nhân AI với NVIDIA OpenShell
- Giới thiệu NV-Reason-CT Open 3D CT VLM cho suy luận chuỗi suy nghĩ của bác sĩ chẩn đoán hình ảnh
- Open Agent Safety Platform: AI Agent cần một lớp an toàn nằm ngoài chính nó
- Thêm các runtime control cho các tác nhân AI với NVIDIA OpenShell