Mỗi bản phát hành CUDA Toolkit của NVIDIA đều bổ sung các tính năng và cải tiến hiệu suất giúp các nhà phát triển tận dụng tối đa GPU NVIDIA và nền tảng phần mềm NVIDIA rộng lớn hơn.
CUDA Toolkit 13.4 bổ sung hỗ trợ cho Windows trên Arm. Các ứng dụng CUDA từ lâu đã được hỗ trợ trên các nền tảng Arm thông qua Linux; bản phát hành này mở rộng khả năng đó sang nền tảng Windows trên Arm.
Bản phát hành cũng giới thiệu hỗ trợ sớm cho nhà phát triển đối với kiến trúc GPU NVIDIA Rubin, nâng cao khả năng quản lý GPU, mở rộng chức năng CUDA Python và CCCL, cùng các bản cập nhật cho các công cụ dành cho nhà phát triển NVIDIA Nsight và các thư viện toán học cốt lõi.
Các cải tiến của CUDA 13.4
Các cải tiến bổ sung trong CUDA 13.4 được trình bày chi tiết trong phần này.
Quyền truy cập của nhà phát triển vào NVIDIA Rubin dưới dạng bản xem trước
CUDA Toolkit 13.4 bổ sung hỗ trợ chức năng cho kiến trúc NVIDIA Rubin (khả năng tính toán 107) dưới dạng bản xem trước, cho phép các nhà phát triển bắt đầu chuyển đổi ứng dụng trước khi CUDA hỗ trợ Rubin đạt mức phát hành chính thức trong một phiên bản tương lai của CUDA Toolkit. Rubin là kiến trúc GPU thế hệ tiếp theo điều khiển kỷ nguyên của AI tự chủ.
Dịch vụ Đa quy trình V3
Máy chủ đa tiến trình (MPS) V3 giới thiệu một lớp điều khiển hiện đại hóa cho CUDA MPS, đơn giản hóa việc tự động hóa và quản lý các tài nguyên GPU được chia sẻ. Bản cập nhật này cung cấp cho các nhà phát triển và lớp điều phối một CLI có thể lập trình, các instance máy chủ có tên và namespace để tổ chức các workload đồng thời. Nó cũng bổ sung hỗ trợ cấu hình TOML, các điều khiển phân vùng bộ xử lý đa luồng (SM) và giới hạn bộ nhớ GPU tích hợp cgroup. Những khả năng này cho phép phân vùng GPU chính xác, nơi hiệu suất tính toán, ranh giới bộ nhớ và ưu tiên thực thi được xác định bằng chương trình. Bản phát hành này đảm bảo rằng MPS tích hợp vào các môi trường chứa hóa, tối đa hóa việc sử dụng phần cứng đồng thời duy trì cách ly tài nguyên nghiêm ngặt cho mọi tiến trình. Để bắt đầu với MPS V3, hãy xem hướng dẫn nhanh và tài liệu đầy đủ.
CUDA Compute Fabric Transport
CUDA Compute Fabric Transport (CFT) giới thiệu một phương pháp tập trung vào truyền tải, cho phép các ứng dụng nâng cao và thư viện giao tiếp di chuyển dữ liệu trên quy mô lớn qua kiến trúc NVLink của NVIDIA. Thay vì ánh xạ mọi vùng bộ nhớ GPU từ xa vào không gian địa chỉ ảo của một tiến trình, phần mềm có thể nhắm mục tiêu đến các điểm cuối logic được đặt tên bằng cách sử dụng ID điểm cuối và offset, sau đó thực hiện các thao tác put, get và reduction bất đồng bộ trực tiếp từ GPU.
Phương pháp này giảm áp lực lên không gian địa chỉ ảo trong các hệ thống nhiều GPU lớn, hỗ trợ các mô hình giao tiếp unicast và multicast, đồng thời báo cáo trạng thái hoàn thành và lỗi để các ứng dụng có thể phát hiện, thử lại hoặc định tuyến lại các lần truyền tải fabric bị lỗi.
CFT chỉ khả dụng thông qua CUDA Driver API và dành cho các nhà phát triển thư viện giao tiếp cần những chức năng rất cụ thể không có trong các thư viện giao tiếp cấp cao hơn. Hầu hết các nhà phát triển ứng dụng nên sử dụng các thư viện như NVIDIA NCCL hoặc NVSHMEM. Để tìm hiểu thêm, hãy xem CUDA Programming Guide.
Các miền cục bộ
CUDA 13.4 cung cấp quyền truy cập theo chương trình vào các miền cục bộ. Một miền cục bộ là một phần của GPU chứa các bộ xử lý đa luồng (SM) và bộ nhớ thiết bị. Một ứng dụng có thể phân bổ bộ nhớ thiết bị trong một miền cục bộ và tạo một ngữ cảnh xanh với các tài nguyên SM trong cùng miền cục bộ đó. Việc đặt gần các phép tính gần với bộ nhớ mà chúng truy cập có thể cải thiện hiệu suất trên các thiết bị có nhiều hơn một miền cục bộ. Để biết thêm thông tin về cách truy vấn và sử dụng các miền cục bộ, hãy xem Hướng dẫn Lập trình CUDA.
Truy vấn vị trí của bộ nhớ hợp nhất
Hỗ trợ API để truy vấn thông tin về nơi lưu trú của bộ nhớ hợp nhất cung cấp cho các thư viện và runtime nhạy cảm về hiệu suất một cách trực tiếp để hiểu dữ liệu được quản lý hoặc được phân bổ bởi hệ thống hiện đang nằm ở đâu. Bộ nhớ hợp nhất giúp đơn giản hóa lập trình dị chủng, nhưng phần mềm hiệu suất cao vẫn cần nhận thức về tính cục bộ để tránh các cuộc di chuyển trang không cần thiết, truy cập bộ nhớ từ xa hoặc các đường dẫn lưu trung gian kém hiệu quả. Với các truy vấn về nơi lưu trú, các ứng dụng và thư viện CUDA đưa ra quyết định thông minh hơn về nơi và thời điểm lập lịch tính toán và di chuyển dữ liệu. Để tìm hiểu thêm, hãy xem tham khảo API cho cudaMemGetLocationInfo.
Tách biệt trình điều khiển CUDA và bộ công cụ CUDA
Các trình cài đặt CUDA SDK không còn đi kèm với driver NVIDIA nữa. Hãy cài đặt riêng các gói driver nvidia-open hoặc cuda-toolkit phù hợp, bằng cách sử dụng trình quản lý gói mà bạn ưa thích.
Quản lý bộ nhớ dựa trên driver nhất quán mặc định cho các nền tảng nhất quán
Trên các nền tảng đồng nhất của NVIDIA như NVIDIA Grace Hopper, NVIDIA Grace Blackwell và NVIDIA Vera Rubin, trình điều khiển hiện mặc định sử dụng Quản lý bộ nhớ dựa trên trình điều khiển đồng nhất (CDMM) thay vì NUMA. Chế độ NUMA vẫn được hỗ trợ đầy đủ và có thể được chọn bằng tham số mô-đun kernel. Nếu bạn dự định sử dụng chế độ này, hãy thực hiện thay đổi trước khi nâng cấp. Đây là thiết lập cấp nút (node-wide) yêu cầu tải lại trình điều khiển hoặc khởi động lại. Chế độ này cần được chọn trước khi nâng cấp. Để biết thêm thông tin về CDMM, xem bài viết Understanding Memory Management on Hardware-Coherent Platforms và tài liệu kỹ thuật.
Trình biên dịch/NVCC
Tương thích trình biên dịch máy chủ hiện bao gồm GCC 16 và Clang 22 trên các nền tảng máy chủ được hỗ trợ. Kiến trúc đích SM_107 mới cho phép biên dịch cho các GPU Rubin.
CUDA Python
CUDA Python mở rộng khả năng truy cập các API CUDA cốt lõi và các thuật toán hiệu suất cao theo phong cách Python, với các bản cập nhật dành cho công cụ phát triển, quản lý bộ nhớ, quy trình đồ thị và khả năng di chuyển ứng dụng.
cuda.core
Sau khi phát hành CUDA Python 1.0, cuda.core 1.1.0 đã mở rộng API CUDA kiểu Python ổn định với lập trình texture và surface, kiểm soát bộ nhớ được quản lý phong phú hơn, tích hợp CUDA graph được cải thiện và thông tin kiểu đầy đủ cho các công cụ phát triển và agent.
Để xem danh sách đầy đủ các thay đổi, xem các ghi chú phát hành cuda.core 1.1.0.
Lập trình texture và surface
Module cuda.core.texture mới cung cấp các API Python hạng nhất cho bộ nhớ texture và surface của CUDA. OpaqueArray và MipmappedArray biểu thị các vùng cấp phát GPU được bố trí bởi phần cứng, trong khi TextureObject cho phép các thao tác đọc kernel được lọc bởi phần cứng mà không cần ràng buộc (bindless), còn SurfaceObject cho phép các thao tác nạp và lưu có kiểu ở phía kernel. Ví dụ sau đây tạo một mảng CUDA không minh thị (opaque) và ràng buộc nó với một đối tượng texture để thực hiện các thao tác đọc kernel được lọc bởi phần cứng.
from cuda.core import Device
from cuda.core.texture import (
      OpaqueArrayOptions,
      ResourceDescriptor,
      TextureObjectOptions,
)
from cuda.core.typing import ArrayFormatType, FilterModeType

dev = Device()
dev.set_current()
stream = dev.create_stream()

with dev.create_opaque_array(
      OpaqueArrayOptions(
          shape=(1024, 1024),
          format=ArrayFormatType.FLOAT32,
          num_channels=1,
      )
) as array:
      array.copy_from(image, stream=stream)

      resource = ResourceDescriptor.from_opaque_array(array)
      options = TextureObjectOptions(filter_mode=FilterModeType.LINEAR)

      with dev.create_texture_object(
          resource=resource,
          options=options,
      ) as texture:
          # Pass texture.handle to a CUDA C++ kernel.
          run_kernel(texture.handle)
Bộ nhớ được quản lý nhận thức NUMA
ManagedMemoryResource.allocate() hiện trả về một ManagedBuffer với giao diện dựa trên thuộc tính cho lời khuyên bộ nhớ CUDA. Các ứng dụng có thể cấu hình dữ liệu chủ yếu đọc, vị trí ưu tiên và quyền truy cập của bộ xử lý.
Loại Host mới bổ trợ cho Device khi chỉ định vị trí bộ nhớ. Nó có thể đại diện cho bất kỳ bộ nhớ máy chủ nào, một nút NUMA cụ thể hoặc nút NUMA liên kết với luồng gọi.
Ví dụ sau cấu hình vị trí và quyền truy cập bộ nhớ được quản lý, nạp trước dữ liệu vào GPU, sau đó chuyển kết quả sang bộ nhớ máy chủ.
from cuda.core import Device, Host, ManagedMemoryResource
from cuda.core.utils import prefetch_batch

dev = Device()
dev.set_current()
stream = dev.create_stream()

mr = ManagedMemoryResource()
weights = mr.allocate(weights_nbytes, stream=stream)
output = mr.allocate(output_nbytes, stream=stream)

weights.read_mostly = True
weights.preferred_location = dev
weights.accessed_by.add(dev)

prefetch_batch(stream, [weights, output], dev)

# Launch GPU work, then move the result to host memory.
output.prefetch(Host(), stream=stream)
stream.sync()
Cải thiện quy trình phát triển và đồ thị
cuda.core 1.1 cung cấp các stub kiểu .pyi cho mọi API công khai, cho phép các IDE truy cập vào thông tin kiểu, chữ ký hàm, kiểu trả về và nhiều hơn nữa, đồng thời hỗ trợ tính năng tự động hoàn thành mã và truy cập vào thông tin kiểu cho các tác nhân mã hóa.
Trong số nhiều cải tiến về quy trình làm việc với CUDA graph, GraphBuilder.graph_definition hiển thị một graph đã được nắm bắt dưới dạng GraphDefinition. Các nhà phát triển có thể sử dụng tính năng này để kết hợp việc nắm bắt luồng (stream capture) với việc xây dựng graph một cách rõ ràng, bao gồm việc kiểm tra hoặc mở rộng một graph đã được nắm bắt.
Các bổ sung khác bao gồm liệt kê NVLink dành riêng cho thiết bị, cấu hình hàng đợi công việc (workqueue) của green-context được mở rộng, các đầu vào dạng đường dẫn cho Program và ObjectCode, cùng với thuộc tính Buffer.size công khai. Phiên bản phát hành này cũng tăng cường xác thực IPC, tính chính xác của Python hỗ trợ đa luồng (free-threaded) và khôi phục điểm kiểm tra (checkpoint) của quá trình CUDA.
cuda.compute
cuda.compute cung cấp quyền truy cập kiểu Python vào các thuật toán GPU hiệu suất cao, có thể tùy chỉnh của NVIDIA CUDA Core Compute Libraries (CCCL), bao gồm sắp xếp, quét, giảm, biến đổi và nhiều thuật toán khác.
cuda.compute 1.1 cho phép biên dịch trước (AoT) các đối tượng thuật toán cho nhiều kiến trúc GPU, bao gồm cả trên các hệ thống xây dựng không có GPU. ProxyArray và ProxyValue mô tả các loại tham số mà không cần phân bổ bộ nhớ thiết bị, trong khi serialize() tạo ra một tệp có thể được lưu trữ và triển khai. Trên hệ thống đích, deserialize() khôi phục thuật toán mà không cần biên dịch lại và tải bản dựng khớp với kiến trúc GPU hiện tại.
Ví dụ sau đây biên dịch một phép giảm cho sm_80 và sm_90 mà không cần GPU, sau đó lưu lại để triển khai sau này.
import numpy as np

from cuda.compute import (
      OpKind,
      ProxyArray,
      ProxyValue,
      make_reduce_into,
      serialize,
)

reducer = make_reduce_into(
      d_in=ProxyArray(np.int32),
      d_out=ProxyArray(np.int32),
      op=OpKind.PLUS,
      h_init=ProxyValue(np.int32),
      compute_capability=[80, 90],  # Build for sm_80 and sm_90.
)

with open("reduce.cclb", "wb") as file:
      file.write(serialize(reducer))
CCCL
CUDA 13.4 đi kèm với CCCL 3.4, nổi bật với cub::DeviceScan nhanh hơn trên các GPU NVIDIA Blackwell, các API một lần gọi cho các thuật toán toàn thiết bị của CUB, các phép giảm warp theo lô và các thuật toán song song quen thuộc của Thư viện Tiêu chuẩn C++ trong cuda::std.
Các phép quét trên toàn thiết bị nhanh hơn trên GPU NVIDIA Blackwell
Một phiên bản triển khai chuyên biệt cho warp của cub::DeviceScan dành cho Blackwell hiện đã có sẵn. Phiên bản triển khai này sử dụng Tensor Memory Accelerator (TMA) để chồng lấn việc di chuyển bộ nhớ và tính toán, đồng thời giảm thiểu chi phí đồng bộ hóa.
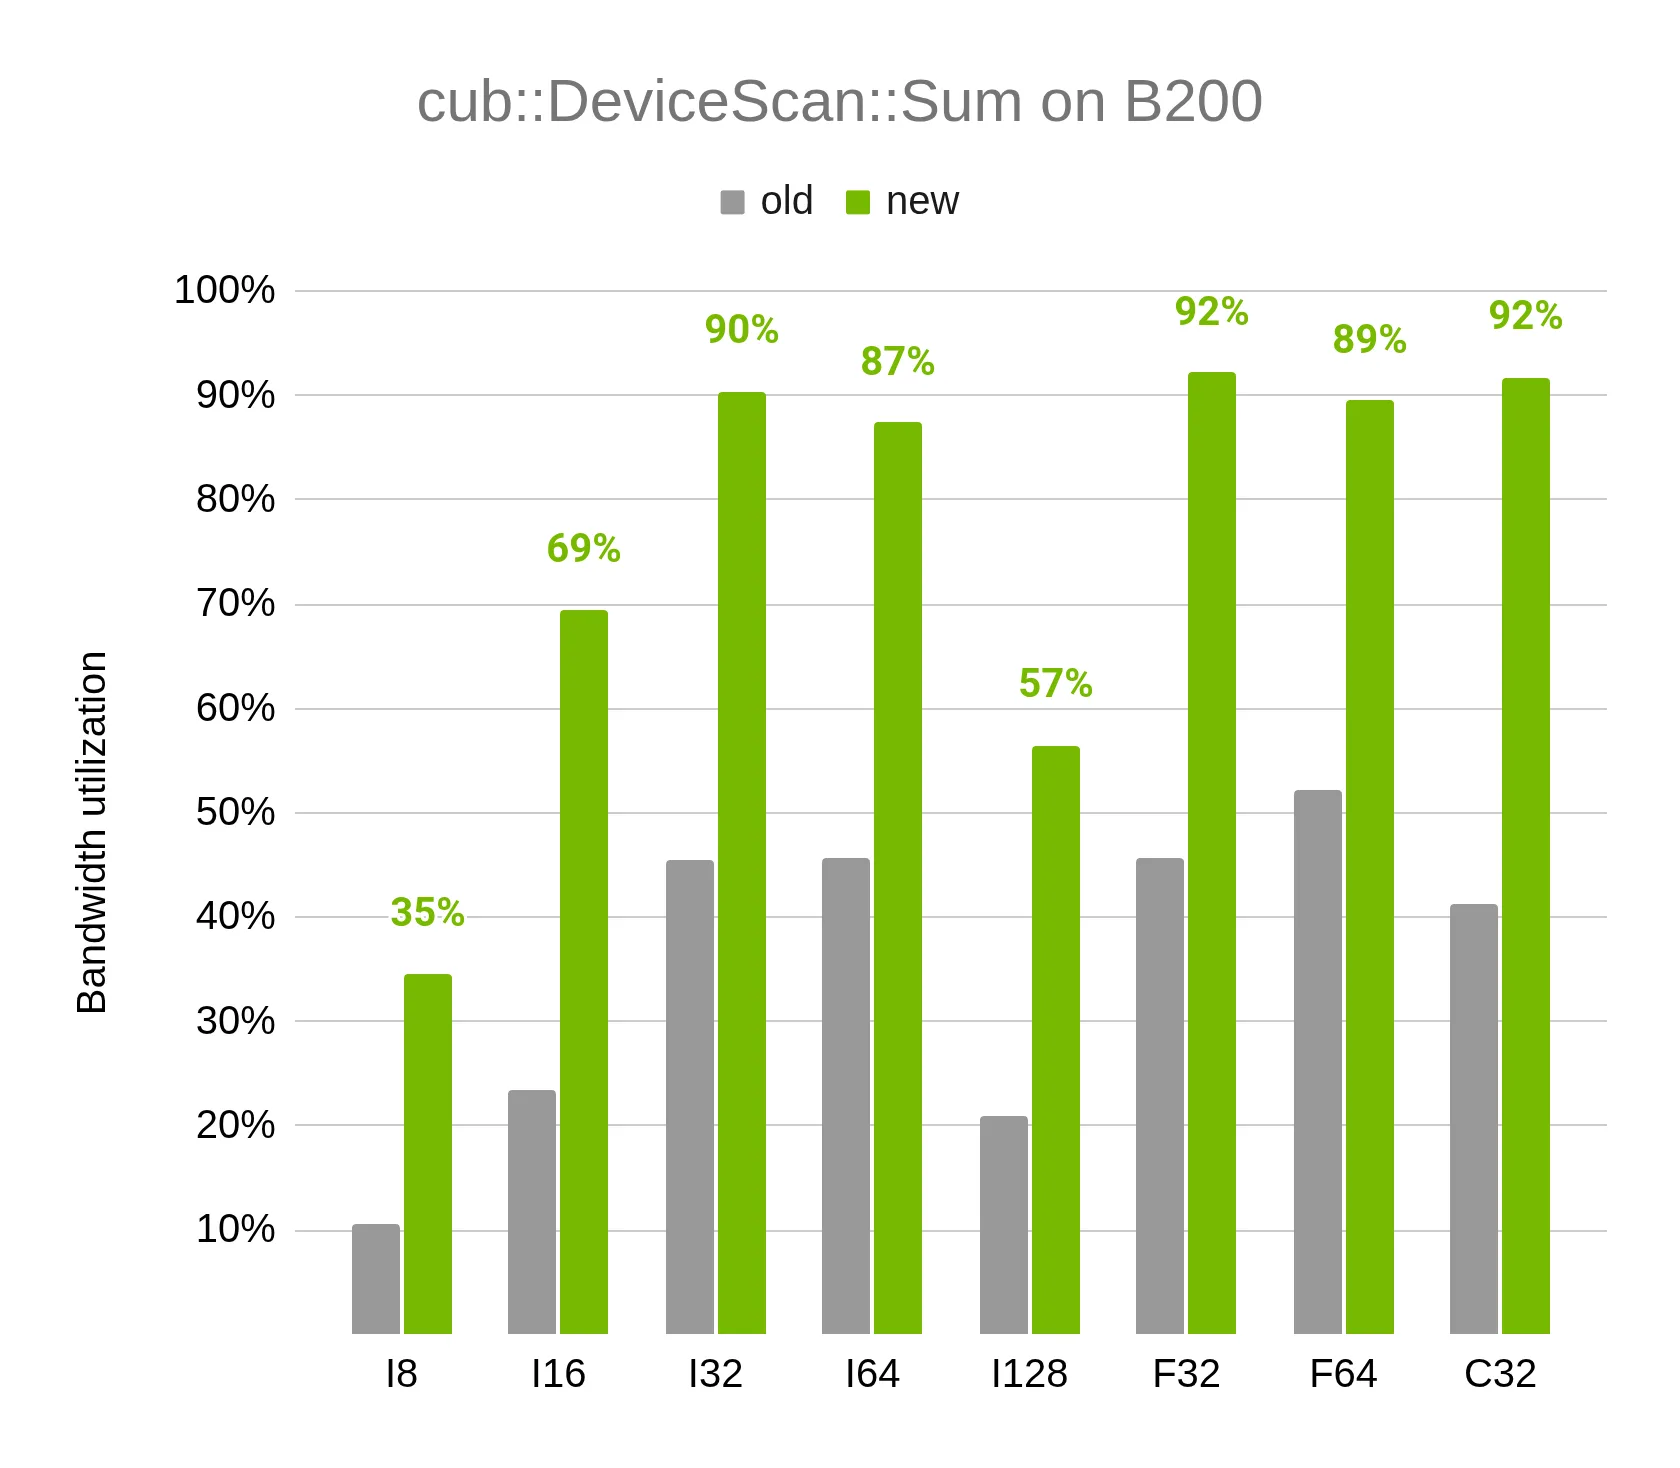
Hình 1. Cải thiện hiệu suất CUB DeviceScan trong CUDA 13.4
Trong các kết quả kiểm chuẩn trên GPU NVIDIA Blackwell, triển khai mới cub::DeviceScan::Sum đạt mức sử dụng băng thông bộ nhớ lên tới 92% (so với mức tối đa khoảng 50% trong triển khai trước đó) trên các kiểu dữ liệu được kiểm thử. Triển khai này được tối ưu hóa cho các khối lượng công việc quét lớn, đồng thời vẫn giữ lại các phương án dự phòng cho các kiến trúc, kiểu dữ liệu, iterator và công cụ biên dịch không được hỗ trợ.
API gọi một lần cho các thuật toán toàn thiết bị của CUB
CCCL 3.4 hoàn tất việc triển khai các phiên bản quá tải hàm gọi một lần dựa trên môi trường cho các thuật toán toàn thiết bị của CUB. Trước đây, các ứng dụng thường gọi một thuật toán CUB một lần để xác định yêu cầu bộ nhớ tạm thời, cấp phát bộ nhớ đó, sau đó gọi lại thuật toán để thực hiện thao tác. Các phiên bản quá tải mới lấy bộ nhớ tạm thời từ một tài nguyên bộ nhớ được cung cấp thông qua môi trường thực thi. Để biết thêm thông tin, xem Đơn giản hóa CUB với API gọi một lần và tài liệu về nguyên thủy toàn thiết bị của CUB.
Ví dụ sau đây tạo một môi trường thực thi với luồng CUDA và hồ chứa bộ nhớ, sau đó chạy một phép giảm thiểu mà không cần quản lý thủ công bộ nhớ tạm thời.
auto device = cuda::devices[0];
auto stream = cuda::stream{device};
auto pool   = cuda::device_default_memory_pool(device);

auto env = cuda::std::execution::env{
      cuda::stream_ref{stream},
      pool
};

cub::DeviceReduce::Sum(d_input, d_output, num_items, env);
Điều này giúp giảm bớt mã lặp lại (boilerplate) đồng thời tập trung hóa việc kiểm soát cách một thuật toán thực thi và lấy bộ nhớ tạm thời. Các API hai giai đoạn truyền thống không bị loại bỏ và vẫn có sẵn cho các ứng dụng yêu cầu quản lý bộ nhớ rõ ràng.
Phép giảm theo lô trong một warp
Một hàm hợp nhất cấp warp mới của CUB, cub::WarpReduceBatched, được giới thiệu để giảm nhiều lô giá trị độc lập được phân phối trên một warp. Hàm này xử lý các lô cùng với nhau, giảm thiểu các thao tác trộn (shuffle) và tăng lượng công việc hữu ích được thực hiện bởi mỗi warp.
Các thuật toán thư viện chuẩn C++ song song trên GPU
CUDA 13.4 giới thiệu mô hình thuật toán song song của Thư viện chuẩn C++ trong cuda::std. Các nhà phát triển có thể gọi hàng chục thuật toán quen thuộc, bao gồm các thao tác copy_if, find_if, merge, reduce, transform và scan bằng cách sử dụng chính sách thực thi cuda::execution::gpu.
Ví dụ sau sử dụng chính sách thực thi GPU để sao chép các giá trị dương từ phạm vi có thể truy cập thiết bị này sang phạm vi khác.
#include
#include

struct is_positive
{
    __host__ __device__
    bool operator()(int value) const
    {
        return value > 0;
    }
};

cuda::std::copy_if(
      cuda::execution::gpu,
      d_first,
      d_last,
      d_output,
      is_positive{}
);
Các thuật toán hoạt động trên các phạm vi có thể truy cập thiết bị và sử dụng các triển khai CCCL và CUB bên dưới. Điều này cung cấp cho các nhà phát triển CUDA C++ một giao diện tiêu chuẩn, dễ nhận biết cho việc thực thi GPU, đồng thời vẫn giữ quyền truy cập vào các tính năng dành riêng cho CUDA như luồng và tài nguyên bộ nhớ thông qua các chính sách thực thi có thể tùy chỉnh. Xem tài liệu về thuật toán song song cuda::std để biết thêm chi tiết.
Programmatic Dependent Launch được đưa vào CUDA Tile IR
Hỗ trợ Programmatic Dependent Launch (PDL) cho CUDA Tile IR cho phép chồng chéo giữa các kernel trên cùng một luồng CUDA, để một kernel phụ thuộc có thể bắt đầu thực thi trước khi kernel trước đó hoàn thành. Xem Ghi chú phát hành của CUDA Tile IR để tìm hiểu thêm về các thao tác này.
Các chế độ xem mới trong CUDA Tile C++
CUDA Tile C++ giới thiệu các chế độ xem bổ sung để tải và lưu trữ dữ liệu.
- Strided view tạo ra các khối dữ liệu có kích thước tĩnh, trong đó khoảng cách giữa các khối được xác định bởi một hệ số bước nhảy (striding factor) tại thời điểm biên dịch. Điều này tạo điều kiện thuận lợi cho các mẫu truy cập dữ liệu thường thấy trong các thao tác dạng stencil.
- Gather scatter view hỗ trợ truy cập các khối không liền kề của một mảng. Điều này tạo điều kiện thuận lợi cho việc truy cập dữ liệu với các mẫu truy cập thưa (sparse access patterns).
Công cụ dành cho nhà phát triển
Một số cải tiến về công cụ dành cho nhà phát triển như sau.
Nsight Python
Nsight Python 1.0 là một giao diện lập hồ sơ kernel Python, tự động hóa phân tích hiệu suất trên nhiều cấu hình kernel bằng cách sử dụng NVIDIA Nsight Tools. Một decorator và context manager cho phép đo hiệu năng kernel, thu thập số liệu kiến trúc, ngăn chặn tình trạng throttling GPU và trực quan hóa hiệu suất trong một script duy nhất. Không cần mã mẫu. Không cần phân tích báo cáo thủ công. Nsight Python cung cấp các số liệu kiến trúc có khả năng mở rộng, không chỉ là thời gian đo theo đồng hồ treo tường, với chi phí mã hóa tối thiểu.
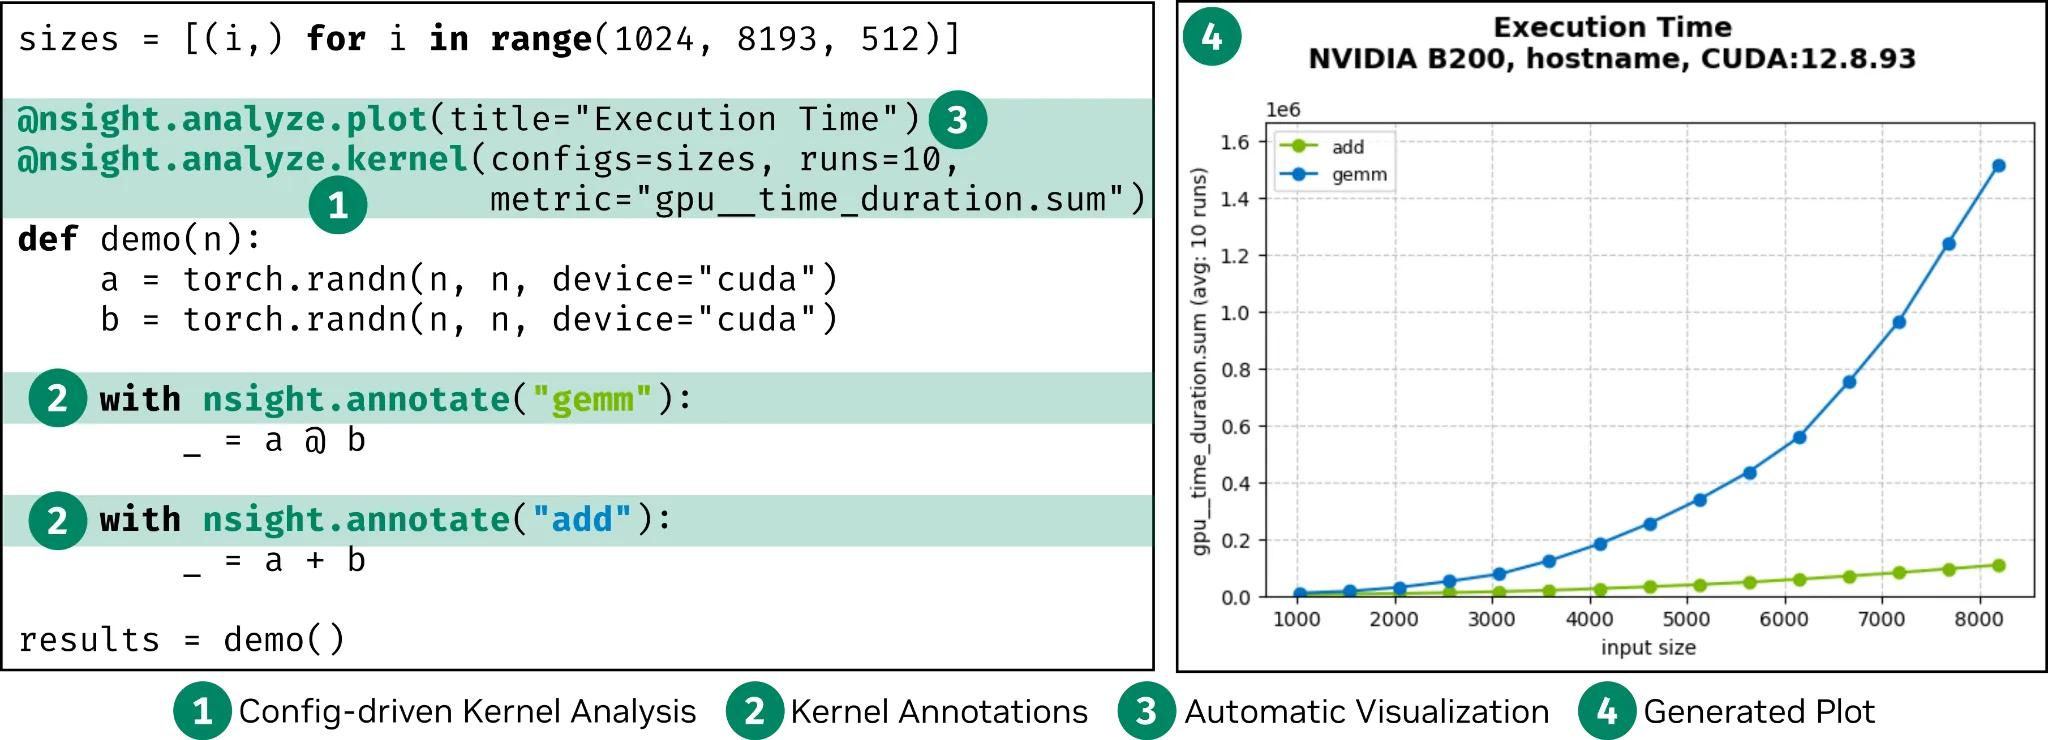
Hình 2. Mã nguồn Python được chú thích với các vùng lập hồ sơ và đồ thị hiệu suất tương ứng cho cả hai vùng
NVIDIA Nsight Compute
Nsight Compute 2026.3 bổ sung hỗ trợ Tile IR cho các khối lượng công việc CUDA Tile, giúp các nhà phát triển kiểm tra Tile IR trên trang nguồn và liên kết nó với mã nguồn CUDA Tile và mã được tạo. Phiên bản này cũng cải thiện thông tin tràn thanh ghi cho các khối lượng công việc OptiX và nâng cao Nsight Copilot.
NVIDIA Nsight Systems
Nsight Systems 2026.5.1 mở rộng phạm vi nền tảng và khả năng hiển thị khối lượng công việc trên CUDA, CPU, các framework AI, mạng và lưu trữ. Phiên bản web bổ sung hỗ trợ cho CUDA 13.4, GPU Rubin và Windows trên Arm. Công cụ này cũng chiếu phạm vi NVTX vào hệ thống phân cấp “All Streams”, giải mã các tên cuTile và hiển thị các khối lượng công việc CUDA được gửi qua các luồng CiG trên đường thời gian.
Các bộ chỉ số CPU nhóm các bộ đếm phần cứng liên quan để thu thập trong một lần chạy, giúp các nhà phát triển cô lập dần các điểm nghẽn thông qua các bộ chỉ số Topdown. Đối với các khối lượng công việc PyTorch, tùy chọn --pytorch=functions-trace-shapes mới bổ sung thông tin như hình dạng tensor và các tham số huấn luyện vào các hàm được theo dõi. Các nhà phát triển có thể lựa chọn giữa chi tiết bổ sung do theo dõi hình dạng cung cấp và mức độ tiêu tốn tài nguyên thấp hơn của tùy chọn theo dõi hàm hiện có.
Đo hiệu năng mạng, lưu trữ và cụm máy chủ
Đo hiệu năng mạng bổ sung việc thu thập số liệu NIC tần suất cao thông qua NVIDIA DOCA Telemetry Service, cho phép các nhà phát triển tương quan lưu lượng truy cập, thông báo tắc nghẽn và thời gian chờ gửi với hoạt động của ứng dụng mà không cần đặc quyền nâng cao. Một công thức phân tích nút thắt chậm trễ NCCL mới phân tích thời gian tập thể để xác định các rank làm chậm tiến độ của communicator một cách lặp đi lặp lại. Xem Hướng dẫn sử dụng Nsight Systems và Hướng dẫn phân tích sau thu thập để biết các yêu cầu thu thập và cách sử dụng công thức.
Công cụ lập hồ sơ lưu trữ hiện bao gồm công thức phân tích tóm tắt truy cập S3, giúp tổng hợp các mẫu truy cập và thống kê I/O trên nhiều quy trình và máy chủ, từ đó xác định các bucket và đối tượng nóng, các truyền tải nhỏ thường xuyên và sự mất cân bằng khối lượng công việc. Lập hồ sơ số liệu NVIDIA SCADA đưa các bộ đếm và biểu đồ tần suất từ kiến trúc lưu trữ SCaled Accelerated Data Access vào đường thời gian, giúp các nhà phát triển tương quan hoạt động của máy chủ lưu trữ với các sự kiện GPU và CPU.
Đối với việc lập hồ sơ và phân tích trên nhiều nút và cụm, plugin vClock thử nghiệm cải thiện việc căn chỉnh báo cáo mà không cần thay đổi đồng hồ hệ thống hoặc yêu cầu quyền truy cập đặc quyền khi không có đồng bộ hóa chính xác cao như PTP.
Tải trọng nhị phân và phát triển plugin
Các tải trọng nhị phân NVTX hiện có thể được xuất dưới dạng bảng quan hệ động, với các trường tải trọng được biểu thị dưới dạng cột để phân tích ở hạ nguồn dưới các định dạng SQLite, Arrow và Arrow/Parquet. Khung plugin của Nsight Systems cũng bổ sung giai đoạn khởi tạo, API gọi lại khi thoát khỏi quy trình và nạp thư viện plugin trong các quy trình con. Các nhà phát triển có thể khởi tạo việc thu thập trước khi ứng dụng bắt đầu, nắm bắt dữ liệu được tạo ra trong quá trình tắt và mở rộng phạm vi lập hồ sơ trên các quy trình con.
NVIDIA Nsight Cloud
Nsight Cloud giúp dễ dàng xem và phân tích các báo cáo lập hồ sơ trên các hệ thống từ xa, không giao diện. Nsight Operator bổ sung các cải tiến cho phân tích, OpenTelemetry và NVIDIA Dynamo, cùng với một trang tài liệu mới.
NVIDIA Nsight AI
Nsight AI đưa trợ lý AI chuyên dụng vào các quy trình làm việc phát triển tính toán tăng tốc. Máy chủ CUDA MCP do NVIDIA lưu trữ kết nối các tác nhân lập trình AI được hỗ trợ với tài liệu CUDA và các ví dụ mã nguồn hiện hành, trong khi Blueprint Nsight Copilot mã nguồn mở cung cấp một backend AI CUDA tự triển khai cho các đội ngũ muốn triển khai và vận hành nó trong môi trường riêng của họ.
NVIDIA Compute Sanitizer
Compute Sanitizer đi kèm với khả năng phát hiện vượt biên bộ nhớ chia sẻ được cải thiện bằng cách vá lỗi khi biên dịch trên các kiến trúc Hopper trở lên. Initcheck hiện bao gồm hỗ trợ memcpy async hàng loạt và hỗ trợ racecheck để lọc theo từng cụm khối.
Thư viện Toán học NVIDIA Core
Các thư viện toán học cốt lõi trong CUDA Toolkit 13.4 hiện đã hỗ trợ chức năng cho kiến trúc GPU Rubin và hỗ trợ Windows trên Arm cho hệ sinh thái Laptop N1X.
Các cập nhật cho cuBLAS trong phiên bản 13.4 bao gồm các tính năng sau:
- cuBLAS cải thiện hiệu suất độ chính xác kép thông qua mô phỏng số điểm cố định bằng cách sử dụng phương án Ozaki-II.
- Trên các GPU máy chủ dữ liệu Blackwell, cuBLASLt lập lịch động các phép tính Grouped GEMM trên các bộ xử lý đa luồng (SM) để giảm thiểu tình trạng mất cân bằng tải trong các khối lượng công việc MoE phổ biến. So với các phiên bản toolkit trước, phương pháp này cải thiện hiệu suất cho các lệnh gọi Grouped GEMM có nhiều nhóm (ví dụ: 32). Nó cũng có thể cải thiện hiệu suất khi các thao tác Grouped GEMM chạy đồng thời với các kernel thiết bị khác.
- cuBLASLt bổ sung các chế độ scale thử nghiệm
CUBLASLT_MATMUL_MATRIX_SCALE_VEC32_MN_K4_UE8M0vàCUBLASLT_MATMUL_MATRIX_SCALE_VEC128_MN_K4_UE8M0, sử dụng bố cục hệ số scale thay thế hỗ trợ các tensorAvàBcó độ chính xác FP8. Các chế độ này đóng gói các hệ số scale thành các nhóm gồm 4 và lưu chúng theo bố cục chính M hoặc N. Phần đệm được thêm vào bất cứ khi nào chiều chính không chia hết cho 4. Để biết thêm chi tiết, tham khảo tài liệu.
Bắt đầu với CUDA Toolkit 13.4
CUDA Toolkit 13.4 mở rộng khả năng phát triển CUDA với hỗ trợ Windows trên Arm, hỗ trợ thử nghiệm cho kiến trúc GPU NVIDIA Rubin, các khả năng quản lý tài nguyên và giao tiếp GPU được cập nhật, cùng những cải tiến trên CUDA Python, CCCL, các công cụ dành cho nhà phát triển NVIDIA Nsight và các thư viện toán học cốt lõi.
Tải xuống CUDA Toolkit 13.4 và xem các ghi chú phát hành của CUDA Toolkit 13.4 để có danh sách đầy đủ các tính năng, nền tảng được hỗ trợ và thông tin về khả năng tương thích.
Lời cảm ơn
Cảm ơn các đóng góp viên sau đây của NVIDIA: Andy Terrel, Rob Armstrong, Jackson Marusarz, Mahender Hari, Becca Zandstein, Mridula Prakash, Daniel Rodriguez, Noah Stern.
Bài viết liên quan
- NVIDIA PAIR Virtual Inference Router mở rộng khả năng tính toán có sẵn trên mạng nội bộ của bạn
- Xây dựng Hệ thống An ninh mạng Thích ứng dựa trên với NVIDIA Nemotron
- Bộ công cụ CUDA hiện đại trong thực tiễn: Hướng dẫn tối ưu hóa từng bước
- GPU Sizing: Cách lựa chọn cấu hình GPU cho quá trình suy luận AI để tối ưu tổng chi phí sở hữu
- Cách đánh giá các chính sách Robot đa năng cho triển khai thực tế